
昨天講了進入CLI開工前要怎麼跟 AI 聊清楚:需求、架構、安全要求。
今天講聊完之後呢???
開 AI CLI 之後第一件事做什麼???
在WEB對話的最後
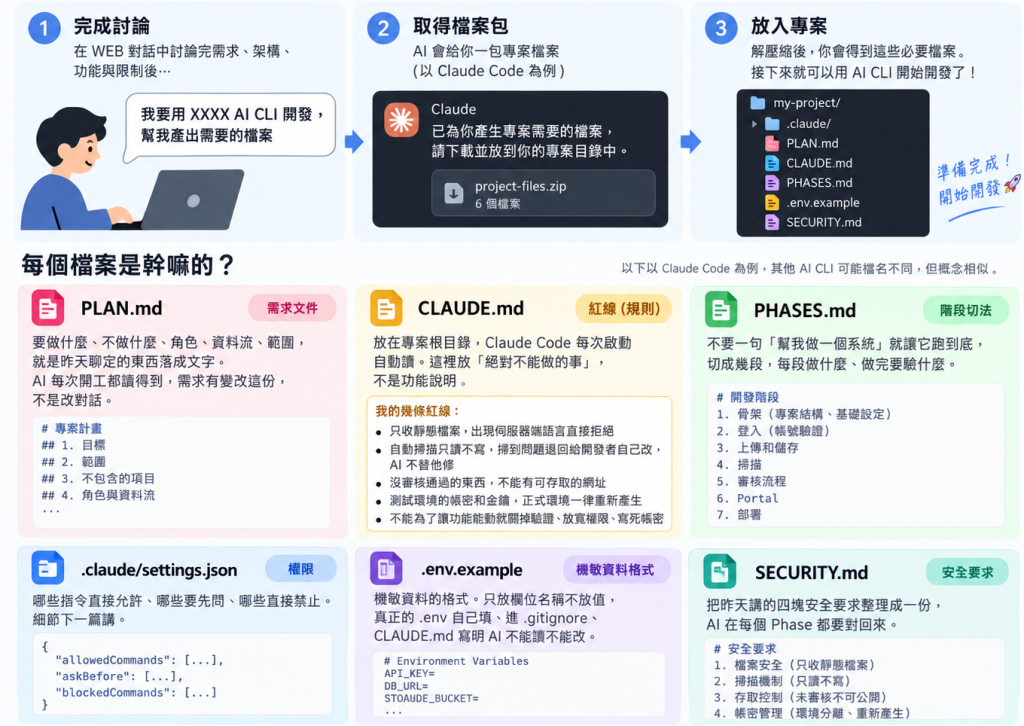
請跟他說「我要用 XXXX AI CLI 開發,幫我產出需要的檔案」,它會給一包東西。每個檔案是幹嘛的:
我以 Claude Code 為例子 通常他會給我這些檔案
PLAN.md:需求文件。要做什麼、不做什麼、角色、資料流、範圍,就是昨天聊定的東西落成文字。AI 每次開工都讀得到,需求有變改這份,不是改對話。
CLAUDE.md:紅線。放在專案根目錄,Claude Code 每次啟動自動讀。這裡放「絕對不能做的事」,不是功能說明。我的幾條:
PHASES.md:階段切法。不要一句「幫我做一個系統」就讓它跑到底,切成幾段,每段做什麼、做完要驗什麼。我切的是:骨架、登入、上傳和儲存、掃描、審核流程、Portal、部署。
.claude/settings.json:權限。哪些指令直接允許、哪些要先問、哪些直接禁止。細節下一篇講。
.env.example:機敏資料的格式。只放欄位名稱不放值,真正的 .env 自己填、進 .gitignore、CLAUDE.md 寫明 AI 不能讀不能改。
SECURITY.md:把昨天講的四塊安全要求整理成一份,AI 在每個 Phase 都要對回來。
開一個乾淨的資料夾,結構大概是:
專案/
├── CLAUDE.md
├── .claude/
│   └── settings.json
├── .env.example
├── .gitignore
└── docs/
    ├── PLAN.md
    ├── PHASES.md
    └── SECURITY.md
CLAUDE.md 和 .claude/ 一定要在根目錄,Claude Code 是靠位置找的。
docs 底下的東西它不會自動讀,要在 CLAUDE.md 裡寫一句「開工前先讀 docs/ 底下的文件」。
放進去之前先看過一次
AI 產的出來的規定 會有它自己的假設,跟你要的不一定一樣。
重點看三個:
CLAUDE.md:紅線有沒有全部在?有沒有它自己加的、你沒說的?有沒有寫得太簡單的,例如「盡量避免」這種字眼要改成「不可以」。
settings.json:禁止清單有沒有涵蓋刪目錄、連正式環境、改 .env? 有沒有你不允許的事情或為了方便把某些危險指令放進「允許清單」?
PHASES.md:每個 Phase 的驗收條件有沒有寫?沒有驗收條件的 Phase 等於沒切。
在專案資料夾裡啟動 Claude Code。
通常我第一件事不是叫它做東西,是叫它讀:
「讀取專案內的所有文件理解專案內容。」
並且且他敘述出他理解的內容且文件化紀錄
把它說的跟你的認知確認一次。
有差異的地方,如果是文件寫得不清楚,回去改文件,如果只在對話裡補一句那可能下次就又出現差異。
這一步做完,才確定它跟你在同一頁上。
首先,什麼是威脅建模?
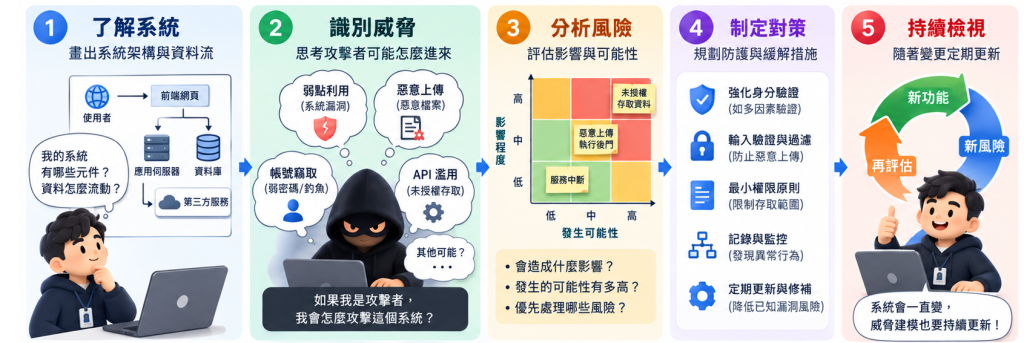
一句話:六種攻擊方式的清單,冒充、竄改、否認、洩漏、癱瘓、越權。
如果有大大想要更深入了解,請參考飛飛大大的這篇詳盡解說:
https://ssdlc.feifei.tw/stride-threat-modeling-data-flow-diagram-trust-boundary-guide/
AI 已經理解你想幹嘛、也讀懂專案了。
但正式開工前最重要的一件事:這個專案可能會遭受怎樣的攻擊?
傳統做法是畫資料流圖、標信任邊界、每個邊界用 STRIDE 列威脅。這是一門專業技能,正規要把前端、後端、DBA、架構師、網路、資安、主管全部找來開會,一個人做出來肯定不完整。你不懂攻擊,就不知道威脅會在哪,這不是翻 CVE 清單能翻出來的。
現在有 AI,這一整桌人的知識它都有,甚至還超過。所以同樣的流程,我現在會直接在 Claude Code 裡叫它跑:
「依照 PLAN.md 的架構,畫出資料流和信任邊界,在每個邊界跑一次 STRIDE,結果寫成 docs/THREATS.md。」
為什麼要在 CLI 做而不是 Web 對話?因為這時候你等於找了另一個專家來,他手上有完整的專案文件,畫出來的資料流是照文件來。Web 對話階段做的威脅建模是粗的,這裡做的是對著實際架構的。
它會給你一張表:哪條資料流、跨了哪個邊界、六種裡哪幾種打得到、怎麼擋。我的專案跑出來二十幾條。
拿到表之後做三件事:
刪掉不合理的。 AI 會列一些照本宣科的威脅,例如「攻擊者實體接觸伺服器」。跟你的環境對不起來的直接劃掉,不然它後面每個 Phase 都會拿這條來煩你。
找另一個 AI 看一次。 前面說過不要只信任一個 AI。把 THREATS.md 丟給另一個模型,問它有沒有漏的、有沒有列錯的。
寫回文件。 留下來的威脅,對應的防禦措施補進 SECURITY.md,該在哪個 Phase 驗的補進 PHASES.md 的驗收條件。不寫回去,這張表就只是一次對話,下個 session 它不記得。
威脅建模我是在 CLI 做,但前面那包文件不是。
說實話沒有不行,他一定能幫你產生相關檔案,
只是在重要專案開發的時候我還是會分開來做。
但有些小東西我的確也偷懶只在CLI直接開始。
三個原因:
CLI 經常會急著動手。 Claude Code 是做事的工具,你跟它聊需求,聊到一半它就開始建檔案、寫程式。Web 對話雖然有時候他也會產生範例給你,但我覺得比較像是專家對談的概念,你可以慢慢問、慢慢改。
你會少看一遍。 Web 產出來的東西你得自己複製、貼進資料夾,這個動作逼你至少掃過一次。CLI 直接寫進去,你看到的是「已建立 6 個檔案」,然後就開工了。上面「自己看過一遍」那段,在 CLI 流程裡最容易被跳過。
多個專家比一個好。 Web 那邊是跟共同討論出來的,CLI 這邊是拿著文件來做。
文件寫得不清楚,第二個專家讀不懂,你馬上就知道問題在文件而不是在對話裡。
如果全部在 CLI 做,它讀的是自己的對話記憶,雖然文件寫爛了它也「懂」,
可是你換一個 session 就可能會有問題。
我個人是覺得多前面的步驟 產出來的比較完整。


 iThome鐵人賽
 看影片追技術