
前面說了開啟 Claude Code 之後先做什麼,才能確保專案跟你想的一樣、做出來的東西比較安全。
今天大概說一下開發的時候該怎麼控制它。
不管是 Claude Code、Codex 還是其他 AI Agent,它們都能在你的電腦裡執行指令、改你的檔案。這是一把雙面刃:好用的地方,也是最危險的地方。
首先要做的限制
正式讓 AI 動手前,我會先限制它能做什麼。
以 Claude Code 為例,.claude/settings.json 可以設定工具與操作權限:哪些可以直接執行、哪些需要先取得同意、哪些直接禁止。
直接禁止的:
.env、金鑰、憑證等敏感資料git push --force
要求先詢問的:
至於一般的程式碼建立、修改與測試,可以在限定的專案範圍內讓 AI 自己進行。
我給 AI agent 的原則很簡單:
「程式碼可以讓你改;環境、權限、憑證與對外連線,不讓AI具有自主權。」
也就是把 AI 的自由度留在「開發」裡,而不是把整台電腦的控制權一起交出去。
環境上的限制
設定檔限制完,我還是不放心。
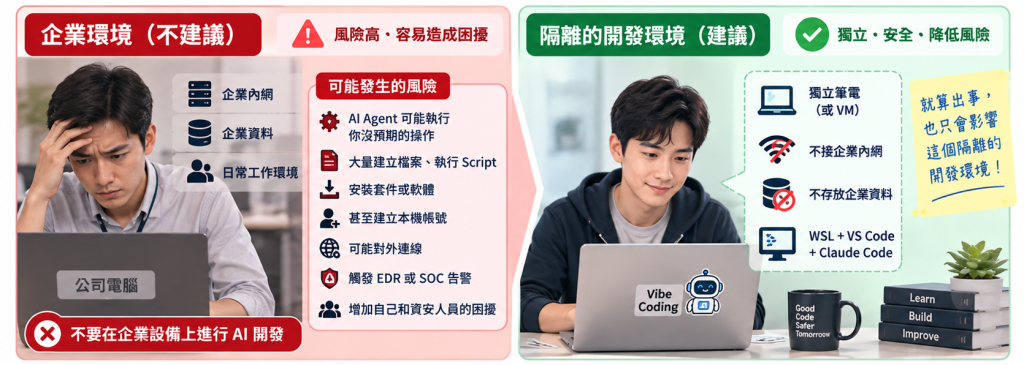
我 Vibe Coding 用的是一台完全獨立的筆電,上面跑 WSL + VS Code + Claude Code。
這台電腦不接企業內網,跟平常工作的電腦分開,也不存放任何企業資料。
原因很簡單:設定檔只是一個護欄,但不是絕對的安全邊界。
規則可能寫漏、權限可能設錯,工具本身也可能出現我們沒有預期到的行為。
尤其 Agent 為了完成你交代的任務,有時候可能採取你原本沒想到的操作。
所以我會再加一層「實體隔離」。
就算前面的限制真的失效,最壞的情況也只能影響這個隔離的開發環境,碰不到我平常工作的電腦、企業內網與正式資料。
沒有多一台筆電也沒關係,可以另外建立一台 VM 作為開發與測試環境。重點不一定是「實體電腦」,而是:
開發環境要跟日常工作環境、企業網路及正式資料隔離。
另外還有一個很實際的原因。
AI Agent 在開發過程中可能大量建立檔案、執行 Script、呼叫系統工具、安裝套件、甚至有的會在你電腦中建立本機帳號、產生各種行為,很多行為都會觸發 EDR 或 SOC 告警。
如果直接在企業設備上做,不只增加風險,也可能替自己和資安人員製造一堆困擾。
所以做法很單純:
設定檔限制 AI「可以做什麼」;
隔離環境限制「就算出事,它能影響到哪裡」。
兩層一起做,而不是只相信其中一層。
連線資料、環境變數
再來是 .env 和 .env.example。
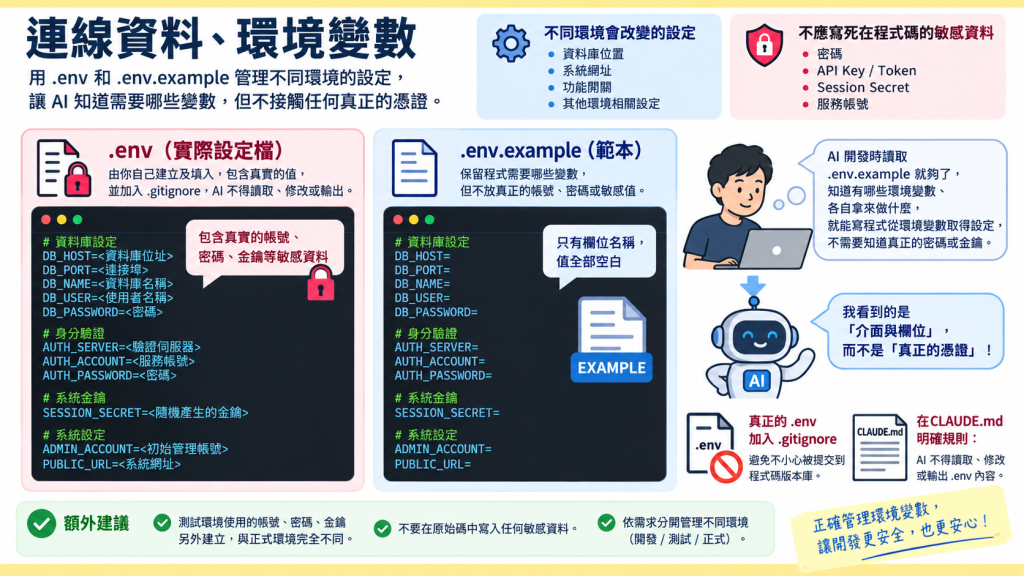
.env 可以把它理解成「這套程式在目前環境下要使用的設定」。
通常會放兩類東西:不同環境會改變的設定,以及不應直接寫死在程式碼裡的敏感資料。
例如資料庫位置、系統網址到了開發、測試與正式環境可能都不一樣;而密碼、API Key、Token、Session Secret 這類敏感資料,更不應該直接寫在原始碼裡。
這裡不使用任何真實環境資料,單純示意 .env 的概念:
# 資料庫設定
DB_HOST=<資料庫位址>
DB_PORT=<連接埠>
DB_NAME=<資料庫名稱>
DB_USER=<使用者名稱>
DB_PASSWORD=<密碼>

# 身分驗證
AUTH_SERVER=<驗證伺服器>
AUTH_ACCOUNT=<服務帳號>
AUTH_PASSWORD=<密碼>

# 系統金鑰
SESSION_SECRET=<隨機產生的金鑰>

# 系統設定
ADMIN_ACCOUNT=<初始管理帳號>
PUBLIC_URL=<系統網址>
而 .env.example 就是它的範本:告訴開發者「這個程式需要哪些環境變數」,但不放真正的帳號、密碼、金鑰或其他敏感值。
例如:
DB_HOST=
DB_PORT=
DB_NAME=
DB_USER=
DB_PASSWORD=

AUTH_SERVER=
AUTH_ACCOUNT=
AUTH_PASSWORD=

SESSION_SECRET=
ADMIN_ACCOUNT=
PUBLIC_URL=
AI 協作開發時,其實讓它讀 .env.example 就夠了。
它只需要知道「程式有哪些環境變數、各自拿來做什麼」,就可以把程式寫成從環境變數取得設定,不需要知道真正的密碼或金鑰是什麼。
真正的 .env 則由我自己另外建立及填入,並加入 .gitignore,避免不小心被提交到程式碼版本庫。
同時在 AI 開發規則文件中明確要求:
AI 不得讀取、修改、輸出或將 .env 的內容寫入其他檔案。
測試環境需要的帳號、密碼與金鑰也另外建立,不與正式環境共用。
這樣 AI 看到的是「有哪些欄位、程式該怎麼使用」,而不是「真正的帳號、密碼與憑證」。


 iThome鐵人賽
 看影片追技術