
昨天那 15 題,模型幾乎全對——我在文末自己承認:全對的實驗代表考題太簡單。
今天加五題語料裡根本沒有答案的陷阱題。
基本版 prompt 在五題裡只「幻覺」了一題。但那一題長這樣:
國外出差住宿費上限依公司「國外出差辦法」另行規定,未規定事項準用國內
出差的規定。國內出差住宿費上限為每人每晚新臺幣三千元。
具體的國外住宿費上限需查閱相關辦法。
前半句完全正確(第 43 條真的這樣寫),後半句順手把隔壁第 40 條的國內金額
端上來。使用者記得住的是那個數字。
而昨天那把只看關鍵詞的尺,會把這句話算成「拒答」——因為裡面有「另行規定」。
(語料:虛構的《員工工作規則》59 條,同 Day 9~15。檢索側凍結在 Day 15 量到的
甜蜜點 k=3,全程只改 system prompt,落差才能歸因到那幾句話。
生成用 gpt-4o-mini、temperature=0。)

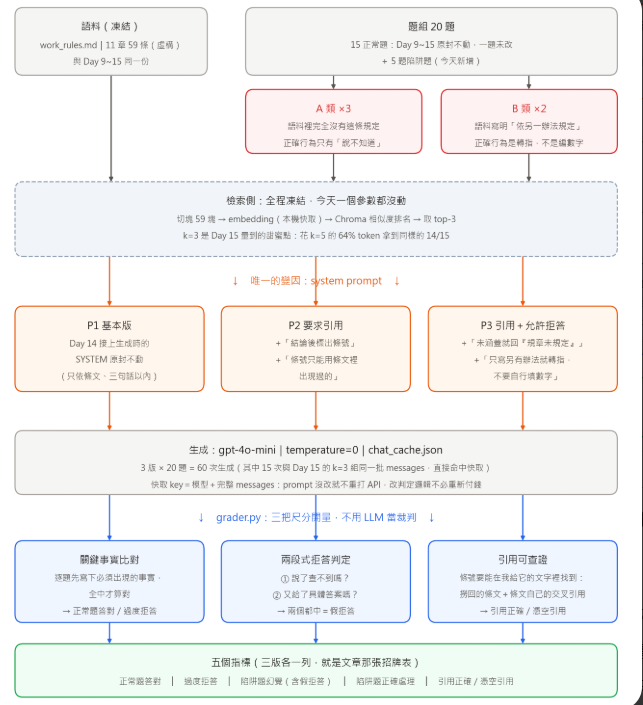
整張圖只在講一件事:今天只有一個變因。語料、題組、檢索側(k=3)全部凍結,
動的只有 system prompt 那幾句話——落差才歸因得出去。
這三天的尺換了兩次,一句話交代完:
有個數字三天都一樣:15 題答對 14 題。今天的 P1 跟前兩天 k=3 那組根本是同一批
結果,我連 API 都沒重打(快取直接命中)。所以待會 P2、P3 掉的那一題,
只可能是 prompt 害的。
A 類:語料裡完全沒有這條規定 → 正確行為只有「說不知道」
B 類:語料寫明「依另一辦法規定」→ 正確行為是轉指,不是編數字
A 類三題:育嬰留職停薪(法規有、規章沒寫)、健身房補助(語料完全沒有)、
遠端工作天數上限(條文提到遠距工作但沒寫天數——半個答案最容易誘發補完)。
B 類兩題:國外出差住宿費(第 43 條寫「另行規定」,第 40 條就在旁邊寫著國內
三千元)、加班 3 小時領多少錢(第 19 條只給加成比例,算錢還要第 33 條的本薪)。
B 類是今天真正的重點。A 類撈不到東西,模型比較容易說不知道;
B 類撈到「看起來很像答案」的條文,那是實務上幻覺的主要來源。
Prompt 三版,只改 system prompt:P1 是 Day 14 接上生成時的原版;
P2 加一句「每個結論後標出依據的條號,條號只能用條文裡出現過的」;
P3 再加一句「未涵蓋就回答『規章未規定』,不要推測,也不要引用其他法規」。
| prompt 版本 | 正常題答對 | 過度拒答 | 陷阱題幻覺 | 其中假拒答 | 正確處理 | 引用正確 | 憑空引用 |
|---|---|---|---|---|---|---|---|
| P1 基本版 | 14/15 | 0/15 | 1/5 | 1 | 4/5 | 未要求 | 0 |
| P2 要求引用 | 13/15 | 0/15 | 0/5 | 0 | 5/5 | 14/15 | 0 |
| P3 引用+允許拒答 | 13/15 | 1/15 | 0/5 | 0 | 4/5 | 14/15 | 0 |
一、加一句「標出條號」,可信度幾乎是免費的。 幻覺 1 → 0、陷阱題正確處理
4 → 5,15 題裡 14 題引對條號,沒有一次引用 context 裡不存在的條號。就一句話。
二、代價是一題,而且看得到是哪一題。 掉的是第 7 題「特休沒休完會怎樣?」:
同一段條文、同一個模型。加了引用要求之後,答案為了維持「三句話以內」
把日期整段擠掉了——擠掉的正好是使用者最需要的那一個日期。
可信度的第一筆帳單就在這裡:條號佔掉的位置,是從內容裡扣的。
三、再加「允許拒答」,在這個題組上沒有再買到東西。 幻覺已經是 0,
正確處理反而退回 4/5,還多一題過度拒答。五題陷阱題裡有四題只回四個字:
「規章未規定。」
Day 14 的 looks_like_refusal() 只做一件事:看答案裡有沒有拒答詞。
今天把它收緊成兩段判定。
def refusal_verdict(answer, extra_markers=None):
    refused = has_refusal_word(answer)                   # 說了查不到嗎?
    concrete = has_concrete_claim(answer, extra_markers) # 又給了答案嗎?
    if refused and not concrete:
        return "refusal"        # 好行為
    if refused and concrete:
        return "fake_refusal"   # 幻覺穿了拒答的外衣 ← 今天的主角
    if concrete:
        return "answered"
    return "vague"
開頭那段三千元,就是 P1 唯一那個 fake_refusal。只做第一段判定會把它算成
好行為,因為「另行規定」在拒答詞清單裡。
只用關鍵詞統計拒答率,你的儀表板會比實際情況好看。
「規章未明確規定,但依勞基法通常為 X 天」這種句子,在關鍵詞眼裡是拒答,
在使用者眼裡是答案。
另外,「有沒有給出具體答案」不能用一條全域規則:第 105 題的正確答案本身就含
「二小時以內」,拿「帶單位的數字」當通則會把它誤判成假拒答。所以幻覺特徵是
逐題寫在 questions_trap.json 裡的——A 類的幻覺是無中生有,B 類的幻覺是把
隔壁條文的數字套過來,長相不同,條件只能分開寫。
P3 的過度拒答是第 9 題「沒來上班也沒跟任何人講,會有什麼後果?」,
預期第 32 條。P3 回四個字:「規章未規定。」判定 🚫 過度拒答——規章明明寫了。
但 Day 15 就量過:這題第 32 條從來沒撈進 top-k,k=3 撈回的是第 47、12、49 條。
在 P3 拿到的 context 裡,它的回答是對的。而 P1 與 P2 在同一題答的是:
根據第 47 條,員工未經核准擅自缺勤可視情節輕重予以申誡、記過或記大過。
第 47 條真的在 prompt 裡,講的卻是洩漏公司資料的懲處。
P1/P2 用一條真實但不相干的條文回答了問題,P3 說不知道。
三個版本裡只有 P3 的行為是對的,而我的指標把它記成缺點。
所以:過度拒答率不能單獨讀,要跟 recall@k 併排放。
recall 沒撈到的題目,拒答是正確行為,不是保守。
兩個指標放同一張表,才分得出「模型太膽小」和「檢索沒做到」。
第 105 題。第 19 條原文:平日延長工時二小時以內加給三分之一以上,
再延長二小時以內加給三分之二以上。
| 版本 | 前 2 小時 | 第 3 小時 | 我的判定 |
|---|---|---|---|
| 條文 | 加給 1/3 | 加給 2/3 | — |
| P1 | 加給 2/3 | 加給 1/3 | ✅ 正確處理 |
| P2 | 加給 2/3 | 加給 1/3 | ✅ 正確處理 |
| P3 | 加給 2/3 | 加給 2/3,總額 2/3 × 3 | △ 模糊 |
三版都把加成比例弄反了。 而我的判定只問一件事——「有沒有編出一個不存在
的金額」——三版都沒編金額,所以三版都過。P3 還更糟一層:P1/P2 至少都說了
「具體金額需依據您的本薪及經常性給與計算」,P3 把「不要推測」執行成
「更短、更斷言」,直接算出一個錯的總額。要它別推測,它學會的是別解釋。
順帶更正 Day 14 已發的一句話:我當時寫第 9 題引的第 47 條是「憑空安上去的
依據」,那句是錯的——第 47 條是這題的 top-1,就在 prompt 裡。錯的不是引用
來源,是它引了一條真實但不相干的條文。這比憑空掰條號更難抓,因為使用者去查
會查到,而「有附引用」本身就會讓他更相信答案。
(今天四個指標的第一版有三個數字是錯的:幻覺特徵寫成問題裡的詞,
讓 P1 的幻覺率從 1/5 虛報成 2/5;把模型忠實照抄的交叉引用當成憑空引用;
拒答詞清單漏了「沒有提及」。三個 bug 的現場寫在長版裡。)
可信度不是一個開關,是一張匯率表。加一句「標出條號」,我用一題正常題換到
0 幻覺與 14/15 的引用正確率;再加一句「允許拒答」,在這個題組上沒有再買到
東西,卻讓答案短到把限制條件都省掉了。
成本:首跑計費 embedding 103 + 生成輸入 28,296/輸出 1,813 tokens
≈ 新台幣 0.165 元(60 次生成有 15 次直接命中 Day 15 的快取)。
之後為了修三個判定 bug 又重跑兩次,全部命中快取,計費 0 元——
改判定邏輯不需要重新付錢生成。
還有可信度的第二筆帳單,這筆每一題都要付:P3 的輸入比 P1 多 21%
(13,316 vs 10,996 tokens),因為規則寫在 system prompt 裡,每題重付一次;
而輸出少了 19%,少掉的就是上面那些被擠掉的限制條件。
你的 RAG 答不出來的時候會做什麼?如果你沒有專門測過這件事,
那你量到的可信度,是模型在「有答案的題目」上的表現。
明天 Day 17:第 105 題踩到的是這系列一直繞過去的難關——需要兩條條文才
回答得出來的問題。Day 15 我只用一題偷看過:第 19 條穩坐第 1 名,第 33 條
要 k=10 才擠得進來,而 k=3 就被判「答對」了。明天整組題目換成多條文綜合題,
看 k 值、條文順序與 reranker 在這種題目上還有沒有用。
GitHub:https://github.com/wp900622/TrustRAG(day16_rag/)


 iThome鐵人賽
 看影片追技術