

在今天之前,打這支 API 的只有我自己的 curl。今天沒有實驗,也沒有預測對帳。
| 人 | 模型 | |
|---|---|---|
| 入口 | /ui/,Vue 3 單頁 |
mcp_server.py,兩個工具,stdio |
| 最在意的 | 第一個字什麼時候出現 | 一次呼叫回什麼、要不要再問一次 |
| 撞到的地方 | 出處先到、答案後到 | 欄位的意思要翻成它讀得懂的話 |
先講模型這一邊。MCP(Model Context Protocol)是讓 AI 應用程式掛外部工具的協定:Claude Desktop、Cursor 這類程式讀一份設定檔,把你的程式當子行程開起來,透過 stdin/stdout 問它有哪些工具、請它呼叫其中一個。對模型來說,就是手上多了幾個可以選的動作。
我交出去兩個。search_rules(query, k) 只做檢索,不叫模型,回條號和原文。ask(question, mode, max_steps) 問一題,回答案和出處,agent 模式被攔下來的話會說。
最省事的寫法是在 MCP server 裡直接 from day24_service.main import _run_agent。不用先開服務,也少一跳網路。
我寫到第三行就停了。這樣一來,MCP 那條路不經過 Day 25 的 request id,不經過 Day 27 的帳本,也不經過 Day 28 用環境變數設的硬上限。這三樣東西最該管的,偏偏就是外面的 agent,因為它會呼叫幾次不是我決定的。
所以 MCP server 寫成這支服務的 HTTP 客戶端,跟 curl、跟網頁一樣走前門。它自己也設一個步數預設值,但只准模型往下調:
if mode == "agent":
    # 呼叫端可以要更少,不能要更多。服務那邊還有一層硬上限
    body["max_steps"] = min(max_steps or MAX_STEPS, MAX_STEPS)
    body["max_wall_ms"] = MAX_WALL_MS
這一層擋不住刻意繞過的人,誰都可以直接打 HTTP。真正擋得住的是服務自己的 DAY24_AGENT_MAX_*,MCP 這邊只是讓正常使用的模型不會一開口就要到最大值。
寫成 HTTP 客戶端還有一個我事先沒想到的好處。FastAPI 的 TestClient 本身就是一個 httpx.Client,測試裡把它塞進 MCP server,工具就直接打在測試用的 app 上,不用開服務,也不會打到 OpenAI。
Day 29 文末留了一個問題:別人的 agent 呼叫我的檢索工具時,要查哪份文件由誰決定?我那天的看法是,這屬於權限,不該讓模型自己填。服務的 /ask 有 source 欄位,交出去的工具就沒有:
## tool search_rules  params=['query', 'k']
## tool ask  params=['question', 'mode', 'max_steps']
看得到哪份文件,由啟動 MCP 的人在設定檔裡用 TRUSTRAG_MCP_SOURCE 決定。花費上限和時間上限也沒開出去。有一個測試專門檢查參數表裡沒有這幾個欄位,我猜最可能把它們加回去的是三個月後嫌麻煩的我。
工具說明是另一個容易被當成註解隨便寫的地方。FastMCP 會把 docstring 原封不動送給模型,模型決定要不要呼叫、要呼叫幾次,能參考的就這幾行。所以 ask 的說明大半在講什麼時候不要用它:
    """問一題公司工作規則的問題,回答案與它根據的條文。

    mode="pipeline"(預設):查一次、答一次,快又便宜,大部分問題用這個就夠。
    mode="agent":讓規章服務自己決定要查幾次,適合要比對好幾條的問題,
    但比較慢也比較貴。你自己已經是 agent 的話,通常不需要再叫另一個 agent。
    回傳如果寫「被攔下來」,照那一句的意思處理,不要原樣再問一次。
    """
「你自己已經是 agent 的話」這句來自 Day 20 的結果:agent 跟寫死管線答對一樣多(24 比 24),貴 4.4 倍。外面一個 agent 再叫我這邊一個,等於兩層迴圈各自決定要查幾次。模型會不會聽這句,我沒有把握。
search_rules 的說明則多寫了一件我自己一直知道、所以從沒寫下來的事:向量檢索一定回得出「最接近的 k 條」,就算規章根本沒規定也一樣。問健身房,它照樣回三條,只是三條都跟健身房無關。以前讀結果的是我,現在是別人的模型。
測試全綠之後,我用真的 MCP client 走了一遍 stdio:開服務,讓 client 把 MCP server 叫起來,列工具,再逐一呼叫。全程命中快取,沒有打到 OpenAI。
其中一題是「公司有健身房或運動補助嗎」,agent 模式,上限 2 步。規章裡沒有這條,它是 Day 21 那組陷阱題之一。回給模型的第一版長這樣:
(被攔下來,停在第 3 步:查詢步數到了上限,已經被要求用手上的資料直接作答。答案可能不完整。)

目前查詢結果中未找到有關公司健身房或運動補助的相關條文。建議向人資部門進一步確認具體政策。

根據的條文:

[work_rules.md] 第 40 條(住宿標準)……
[work_rules.md] 第 41 條(出差餐費與日支費)……
[work_rules.md] 第 38 條(出差申請)……
(後面還有病假、保密義務、人事資料,共 6 條)
答案沒錯。錯的是「根據的條文」這個標題,是我寫的。
citations 這個欄位從 Day 24 就在契約裡。pipeline 放檢索撈到的前 k 條,agent 放它查過的每一條,兩者都不保證答案有用到。我看 JSON 的時候心裡清楚這件事,所以從沒覺得有什麼不對。到了要翻成中文給模型讀,我順手打了「根據」兩個字。外面的模型讀到,下一句很可能就是「依據第 40 條住宿標準……」。
同一段還有第二處:上限 2 步,卻寫「停在第 3 步」。Day 28 的做法是讓凍結的 agent 走完兩步後,再逼它交卷一次,交卷那次算第 3 步。欄位值是對的,翻成一句話就像上限沒生效。
兩處都改成講它實際做了什麼,網頁上一模一樣的寫法也一起改掉:
(被攔下來,查了 2 次:查詢次數到了上限,已經被要求用手上的資料直接作答。答案可能不完整。)

目前查詢結果中未找到有關公司健身房或運動補助的相關條文。……

服務查到的條文(不一定每一條都跟答案有關):
契約裡的欄位名是寫給程式看的,交給模型之前要重新翻一次,而翻的時候最容易把自己知道、但欄位沒說的事情加進去。 別人的模型會不會誤會,測試證明不了。我能做的只有一個測試,確保陷阱題的回傳裡不再出現「根據」兩個字。比較像樣的解法是在契約裡加一個欄位,記下答案實際引用了哪幾條,但那要改生成那段的 prompt,今天沒做。
Day 28 的上限有三種。步數到了還是會有答案,只是可能不完整。錢或時間到了,answer 是 null,但會附上停下來之前查到的條文。後兩種最容易出事:模型看到答案是空的、底下又有幾條條文,很自然就總結成「規章裡沒有規定」。昨天那篇也碰過這件事,agent 查不到的東西,它會當成不存在。
所以每一種停下來的原因,我各寫了一句話給模型,錢和時間那兩句都明講「不代表規章裡沒有答案」。
錯誤也照同一個想法處理。服務沒開時,模型最需要知道的是這不是查無資料;參數錯了,改完再問就好;服務自己出錯,重問同一句沒用。Day 25 定的錯誤形狀有 code、message、request_id,MCP 這層把它接成一句話:
Error executing tool ask: invalid_request:question:String should have at least 1 character(request_id=90d36771)請修正參數後再呼叫。
request_id 我沒拿掉。使用者回報時貼這串給我,我就能在服務的 log 裡找到同一次請求。
網頁是 Vite 開的 Vue 3 專案,放在 day30_web/:
day30_web/src/
  api.js                    只有這個檔案知道 URL 和線路格式
  composables/useAsk.js     一次問答的狀態:答案、出處、有沒有被攔下來、錯誤
  composables/useHealth.js  頂部那顆燈,讀 /healthz
  components/AskForm.vue、AnswerCard.vue、CitationList.vue
  App.vue
api.js 照著 contracts.py 寫,錯誤包成 ApiError,帶著 code 和 request_id。元件裡沒有一行 fetch。
開發時 Vite 在 5173、服務在 8024,瀏覽器會擋跨來源。我沒去 FastAPI 開 CORS,而是用 Vite 的 proxy 把 /ask、/search 轉過去。上線時 npm run build 直接輸出到服務的 static/,由 FastAPI 掛在 /ui/,一樣同源。build 出來的檔案也放進版控,只想跑後端的人不用裝 Node。
export default defineConfig({
  plugins: [vue()],
  base: "/ui/",
  build: { outDir: "../day24_service/static", emptyOutDir: true },
  server: { proxy: { "/ask": API, "/search": API, "/sources": API } },
});
要動腦的是串流。瀏覽器內建的 EventSource 只能發 GET,/ask 是 POST,所以得自己讀。我把它寫成 async generator,讀到 \n\n 就吐一個事件出去:
while ((cut = buf.indexOf("\n\n")) >= 0) {
  const block = buf.slice(0, cut);
  buf = buf.slice(cut + 2);
  const event = /^event: (.*)$/m.exec(block)?.[1];
  const data = /^data: (.*)$/m.exec(block)?.[1];
  if (event) yield { event, data: data ? JSON.parse(data) : {} };
}
composable 那邊只剩一個 for await,citations 到了先畫出處,token 到了接進答案。agent 不串流(Day 26 定的,它中間吐的 token 不是最終答案),所以畫面上的等待不一樣,要等整包回來。
狀態裡有個欄位是寫到一半才加的,叫 hasAnswer。原本空字串就代表還沒有答案,但 Day 28 的金額和時間上限會讓 answer 回 null,意思是這一題沒有答案,跟第一個字還沒到是兩回事。前者要顯示「(沒有答案)」,後者什麼都不顯示:
state.hasAnswer = body.answer != null;
state.answer = body.answer ?? "";
還有取消。問了第二題,第一題的串流要真的斷掉,不然畫面換了,連線還掛著,服務照樣把答案生完、照樣付錢(Day 26 的標題就是這件事)。所以每次送出前先 abort 上一個請求,離開頁面時也 abort。這只對串流有效,它是 async 產生器,斷線會變成 aclose()。agent 那條是同步 handler,前端取消了,服務端還是會跑完,能停住它的只有 Day 28 的上限。
同一題陷阱題在網頁上長這樣,右邊那 6 條就是「查過,但跟答案無關」:
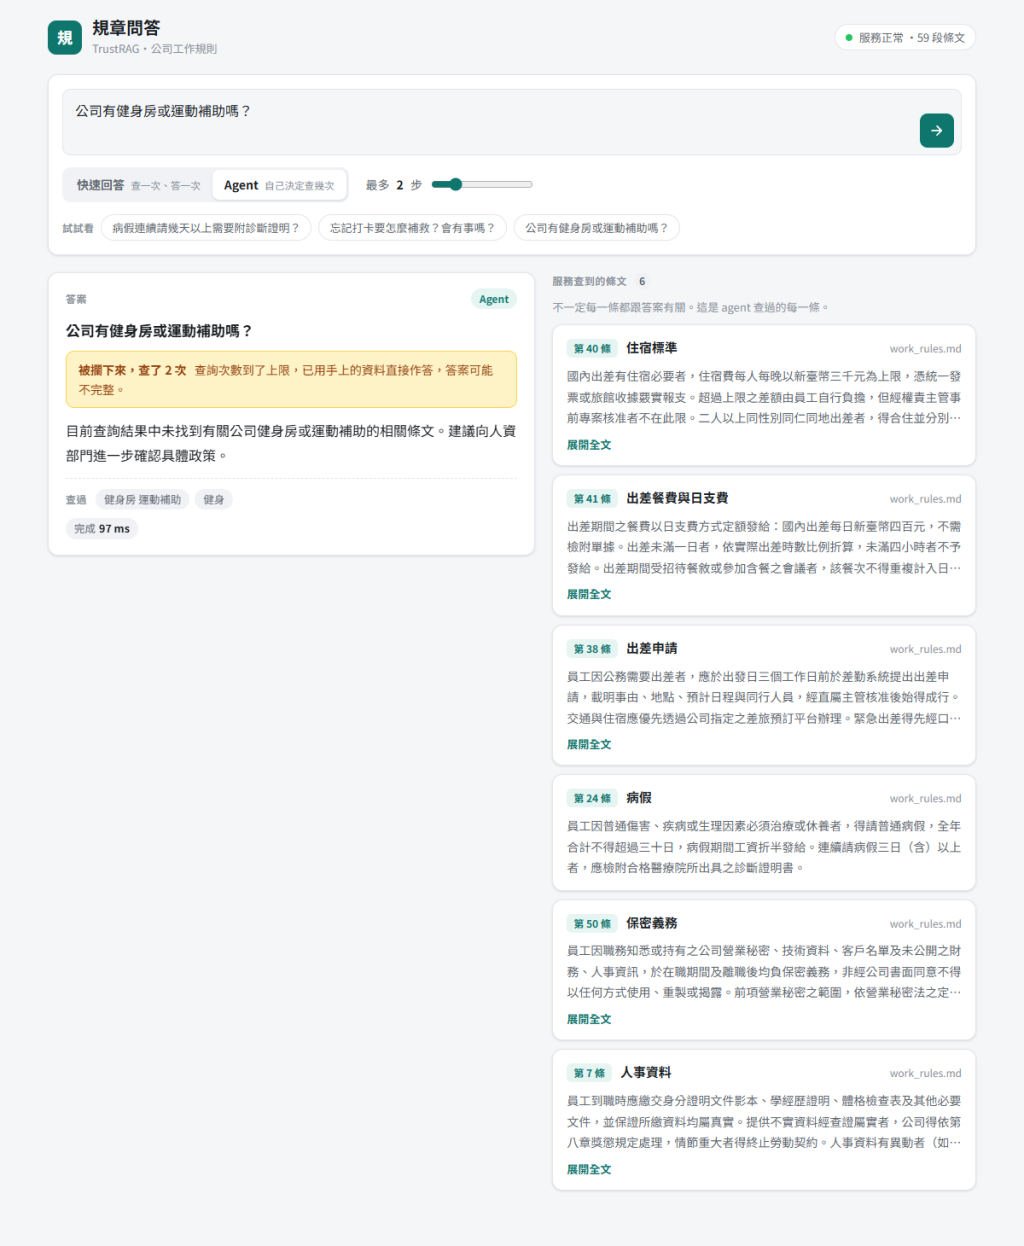
規章問答網頁:agent 模式問健身房補助,被攔下來查了 2 次,答案是查不到,右邊列出 6 條服務查到的條文](day30_ui_agent.png)
截圖用的題目都在快取裡,一般模式那張是出處 28 ms、第一個字 32 ms、完成 32 ms。真的叫模型時,Day 26 量到的是出處 219.2 ms、第一個字 850.1 ms。
測試從 85 個變成 98 個(其中 8 個要 Redis),新的 13 個在 test_handover.py。網頁那個要多走一步:build 出來的 HTML 只剩一個殼,得順著它找到 JS,再確認裡面打的是相對路徑 /ask、沒有寫死 127.0.0.1。其餘 12 個檢查交出去那一層講了什麼、沒講什麼。答案對不對,前面已經測過。
回頭看這 30 篇,我們從 AI 的相關知識到 RAG 和 Agent ,由於第一次參賽再加上對 AI 沒那麼熟,因此一大半的文章都是由 Claude 代勞,但品質就一定會參差不齊,這個我下次參賽會注意盡量自己寫。同時,也謝謝願意看得讀者,希望對大家有幫助。


 iThome鐵人賽
 看影片追技術