
第 1 層:事實層。
第 0 層處理的是「規則」。這一層處理的是另一種東西。事實。
而這兩者的失效方式完全不同。
舉一個例子:
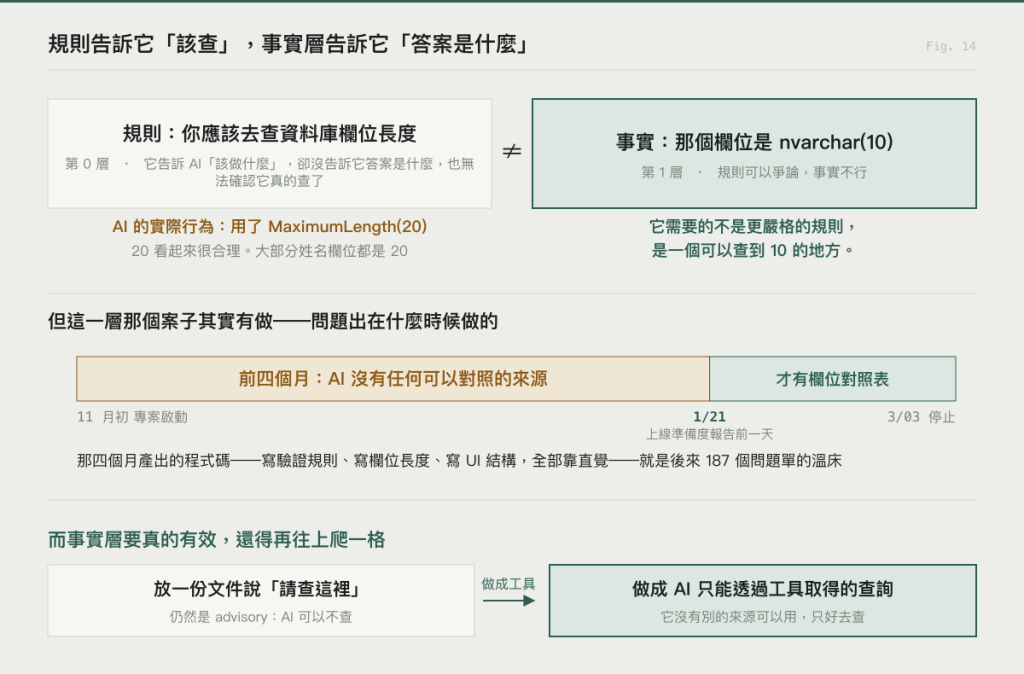
AI 設定了 MaximumLength(20),但資料庫欄位是 nvarchar(10)
這不是規則問題。沒有任何一條規則叫做「欄位長度不可以設 20」。20 這個數字本身沒有對錯,錯的是它跟資料庫不一致。 檢查清單裡確實有一條「欄位長度必須對照資料庫」。但那是一條規則,它告訴 AI「你應該去查」,卻沒有告訴它查到的答案是什麼,也沒有辦法確認它真的查了。
所以 AI 就延用了原來的數字。20 看起來很合理。大部分姓名欄位都是 20。它需要的不是更嚴格的規則,是一個可以查到 10 的地方。
事實層就是那個「可以查到 10 的地方」。single source of truth。常見的內容:
它跟第 0 層的差別在於:第 0 層是規則(該怎麼做),第 1 層是事實(實際是什麼)。 規則可以爭論,事實不行。所以事實層比規則層具體得多,也可靠得多。
這一層那個案子其實有做,問題出在什麼時候做的。欄位對照表的建立日期是 1 月 21 日。上線準備度報告的前一天。
而專案是 11 月初啟動的。
前四個月,AI 沒有任何可以對照的來源。 它寫驗證規則、寫欄位長度、寫 UI 結構,全部靠直覺。那四個月產出的程式碼,就是後來 187 個問題單的溫床。
所以事實層有一個很現實的結論:
它的價值幾乎完全取決於「什麼時候建立」。
專案末期才建的事實層,只能拿來做事後對帳,防不了任何東西。
這裡要講清楚一件事,免得高估了這一層。
事實層本身仍然是 advisory 的。
你把欄位規格寫成一份 markdown 放在 repo 裡,AI 還是可能不去讀它。它跟第 0 層一樣依賴自願配合。只是配合的內容從「遵守規則」變成「去查資料」。
那要怎麼讓它真的被查?
這是我認為第 1 層最重要的演進方向,也是這兩年才變得可行的事:
把事實層從「文件」做成「AI 必須呼叫的工具」。
差別在哪?
具體的場景長這樣:
當 AI 要寫
MaximumLength(...)的時候,工具鏈強制它先呼叫getColumnSpec("使用者資料", "姓名"),得到nvarchar(10)。沒查就不能往下做。
可能的設計:
| 工具 | 用途 |
|---|---|
legacy-schema |
查舊系統的欄位規格 |
legacy-behavior |
查舊系統某頁面/某流程的實際行為 |
ui-spec |
查 UI 設計稿規範(直接讀 HTML) |
column-mapping |
查欄位的業務含義與新舊映射 |
這些現在都可以用 MCP(Model Context Protocol)server 實作。
理論講完,講一個我最近在另一個進行中的案子看到的實作。那個專案的設定檔裡掛了一個 code graph 的 MCP server。意思是:AI 不用靠 grep 去猜「這個方法被誰呼叫」「這個類別的相依是什麼」。它可以直接查詢程式碼的結構圖。
這件事的價值不只是省時間。回想 Day 09 講的第三個場景:
「後端成功但前端失敗」的問題,第一時間判斷是要調某個框架的緩衝上限。
那個判斷在一般專案是對的,但這個專案的 client 是手動建的 bean,
那個設定完全不會生效。
那正是一個「事實」問題,不是「規則」問題。
如果 AI 能查到「這個 bean 是在哪裡、用什麼方式建立的」,它就不會做那個推論。它做那個推論,是因為它只能靠 prior。事實層工具化,本質上是在削減 AI 需要用 prior 補空白的面積。 這跟 Day 09 那個原因是直接對應的。
最後講一個很少人提、但我看過真實案例的問題:
單一真相自己會過期。
有一個案子的迭代日誌裡有一條,標題就叫「單一真相自己過期」。他們建了一份配置的單一真相檔,結果那份檔案裡的版本號,跟實際的建置檔對不上了。你立了一個「以它為準」的東西,然後它錯了。而所有人都還在照著它走。 這比沒有那份檔案更危險。沒有的時候,大家至少會去查真的東西。
所以事實層需要配一個東西:一致性檢查 。定期(或每次改動時)比對「單一真相宣稱的」和「實際的」是否一致,不一致就擋。
而那已經是第 3 層的事了。
這也說明了一件事:這幾層不是各自獨立的,它們互相支撐。第 1 層需要第 3 層來確保自己不腐化。
明天講第 2 層:流程閘道。那一層要講一個我認為很多團隊做錯的事。agent、skill、subagent 都配了,但時序錯了,所以沒效。


 iThome鐵人賽
 看影片追技術