

你是否曾想過:
我們身體裡的每一個細胞(不論是大腦神經元、心肌細胞還是血液白血球),藏在細胞核裡的 DNA 說明書都是一模一樣的。
那麼,為什麼大腦細胞能發出電訊號,心臟細胞會跳動,而血液細胞能運輸氧氣?更讓人頭痛的是:為什麼有些基因突變,在血液檢測裡看起來完全正常,到了腦細胞裡卻會引發致命的癲癇?
答案就藏在佔據基因組 98% 的非編碼區裡。今天我們將揭開「順式調控元件」與「組織特異性」的神秘面紗,看看 AI 模型如何破解這套生命密碼!
假使將能製造蛋白質的 2% 編碼區比喻為「零件藍圖」,那麼剩下的 98% 非編碼區就是控制這些藍圖何時啟用、產量開多大的「自動化控制面板」。在這塊面板上,最重要的控鍵被稱為順式調控元件:
| 元件名稱 | 白話比喻 | 核心功能 | 如果開關壞掉(發生變異)會怎樣? |
|---|---|---|---|
| 啟動子 (Promoter) | 電源總開關 | 緊鄰基因開頭,決定是否開始轉錄 RNA | 基因完全無法啟動,導致蛋白質零件直接缺席 |
| 增強子 (Enhancer) | 音量放大旋鈕 | 可遠距離作用,大幅提升特定基因的表達量 | 在需要大量蛋白質的關鍵發育期,零件產量嚴重不足 |
| 沉默子 (Silencer) | 靜音按鍵 | 抑制基因表達,防止特定細胞製造出錯誤的蛋白質 | 該安靜的基因被異常啟動,引發細胞功能混亂或癌變 |
這些控制按鈕需要靠細胞內的轉錄因子(Transcription Factors, TFs)——就像是一雙雙專門按按鈕的手——來進行精準操作。當變異發生在這些調控區域時,它不會破壞蛋白質零件本身的結構,而是把控制面板上的按鈕砸壞了,導致零件在錯誤的時間或地點被製造出來。
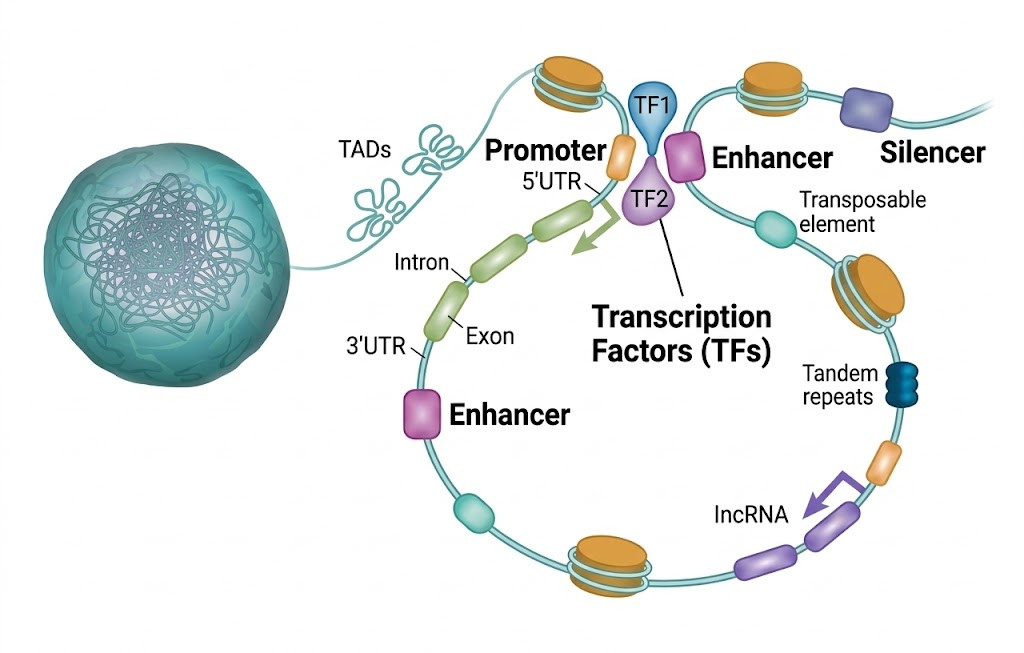
圖 1|非編碼變異的功能分類與致病機制示意圖
引用自 French & Edwards, The Role of Noncoding Variants in Heritable Disease, Trends in Genetics (2020).
回顧 Nature 論文中那個震驚生醫界的真實案例:一名出生僅 6 週的嬰兒頻繁發作癲癇,常規的全基因組測序與血液 RNA 檢測都找不到病因。
為什麼血液 RNA 檢測會完全失靈?答案就是組織特異性(Tissue Specificity)。
雖然全身細胞的 DNA 序列相同,但不同器官使用的「增強子開關」與「轉錄因子」卻完全不同。
這名幼兒在 DNM1 基因深層內含子(Deep Intronic)帶有一個隱蔽的突變:
這就是非編碼區最狡猾的地方——空間與時間的生物學魔法。如果只拿血液做檢測,永遠找不到病因。
在 AlphaGenome 誕生前,科學家主要依賴 PhyloP 或 CADD 等傳統評分工具。這些工具的核心邏輯是演化保守性(Conservation):如果一段 DNA 序列從老鼠、黑猩猩到人類都長得一模一樣,代表它很重要;如果這裡發生突變,傳統工具就會給出高危險分。
但這種方法有兩個致命盲點:
沒有機制解釋,實驗室研究人員就無法設計針對性的細胞實驗來驗證,導致變異永遠被卡在「意義不明(VUS)」的清單中。
在進入專案實作、撰寫程式呼叫 API 或進行資料清洗之前,最重要的一步,就是先翻閱讀官方資料。了解 Google DeepMind 團隊是如何設計出 AlphaGenome Atlas 這座巨型基因預計算地圖的。
1. 官方 Blog(應用案例): Google DeepMind Blog — AlphaGenome Atlas
2. 論文全文 / 預印本(完整技術細節與實驗數據 PDF): AlphaGenome Atlas Paper (PDF)
現在看清了基因暗物質的運作邏輯與傳統工具的死胡同。接下來將正式進入系統選型階段,探討為什麼在茫茫技術海中,AI 代理平台是消化這些巨量複雜醫學數據的最佳解方!
後續實作部分將採用「先以 Google AI Studio 打造零程式碼原型(MVP),再逐步拆解工程實作」的策略,符合現代 AI 產品開發的 "Fail Fast, Iterate Faster"(快速驗證,敏捷迭代) 模式。


 iThome鐵人賽
 看影片追技術