
Ray Data 已經把資料載入交給 CPU operator,GPU actor 也只負責計算,GPU 為什麼還會停下來等?
排除前一天遇到的 worker 啟動與 report 匯出問題後,Nsight timeline 終於呈現出這份 workload 的執行節奏:一段 H2D,接著一組矩陣乘法,再停一下,才輪到下一批。約 1.81 秒的觀測範圍內,有 566 ms 沒有 kernel 執行。
其中有些空檔正在搬資料,有些連搬資料都沒有。要知道 Ray Data 哪裡還能改進,得先看清楚這兩種空檔出現的位置。
實驗用一個簡化的推論工作負載,觀察資料如何從 CPU 送到 GPU。四個 CPU workers 準備 32 批 NumPy 資料,每批以 40 ms 的等待模擬載入,再建立陣列;一個 GPU actor 接收 batch,執行 H2D、9 次矩陣乘法,最後把一欄結果搬回 CPU。
Ray Data CPU operator
  └─ 每批建立 2048 × 8192 FP32 array,約 64 MiB

Ray Data GPU actor
  └─ H2D → 9 × matmul → D2H
每批輸入是 2048×8192 的 FP32 array,大小為 64 MiB。矩陣乘法使用固定的單位矩陣,讓每批工作量一致;這是資料管線實驗,並非完整 AI 模型的推論 benchmark。Trace 裡的事件數量也符合這個設定:
| profile 裡的事件 | 實際數量 | workload 預期 |
|---|---|---|
| H2D copy | 32 | 32 批輸入,每批一次 |
| D2H copy | 32 | 32 批輸出,每批一次 |
| 主要 GEMM kernel | 289 | 32 × 9,再加 1 次 warmup |
| 全部 kernel | 324 | GEMM 加上 warmup、fill 與輸出轉換 |
實驗使用一張 NVIDIA B200。機器共有八張卡,但 actor 透過 CUDA_VISIBLE_DEVICES 只看得到分配給它的那張,因此這份 trace 的 CUDA 活動記成 device 0。
nsys-ai 的 gpu_idle_gaps、memory_transfers 與 pipeline_bubble_metrics 分別整理 kernel 空檔、資料搬移與沒有 GPU 活動的時間。這份 profile 從第一個 kernel 到最後一個 kernel 共 1811.19 ms,其中 566.38 ms 沒有 kernel 執行,約占 31.3%。
| 觀測口徑 | 時間 | 代表什麼 |
|---|---|---|
| kernel span | 1811.19 ms | 第一個到最後一個 kernel,包含初始化與 warmup |
| kernel active | 1244.81 ms | 至少有一個 kernel 在執行 |
| H2D copy wall time | 339.49 ms | GPU 正在搬 2.147 GB 的輸入資料 |
| pure bubble | 約 226.8 ms | 這份 trace 沒有記錄到 kernel 或 memcpy 執行的時間 |
GPU 的運算單元與 copy engine 可以各自工作。沒有 kernel 執行時,GPU 仍可能在搬資料,因此 kernel idle 不等於整張 GPU 完全沒事做。這份 trace 的 H2D 與 kernel 都在 stream 7,兩者的時間交集是 0 ms,所以約 566 ms 可以拆成:
沒有 kernel 的 566 ms
  ├─ 339.6 ms:有 copy、沒有 kernel
  └─ 226.8 ms:kernel 與 copy 都沒有,是真正的 pipeline bubble
32 次 H2D 共搬了 2.147 GB,花費 339.49 ms,等效頻寬約 6.3 GB/s。D2H 只回傳一欄結果,32 次合計約 0.11 ms,對 device 上的搬移時間影響很小。也就是說,沒有 kernel 的時間裡,約六成確實花在搬資料。
copy_ms 的定義是 copy 的時間聯集;若其他 workload 已有 copy 與 kernel 重疊,就不能直接從 kernel idle 扣掉 copy_ms。此時要合併 kernel 與 copy 的時間區間,才能算出真正的空白。
除了初始化,gpu_idle_gaps 還找到 32 個介於 5–50 ms 的 kernel 空檔。把 timeline 放大到第 8、9 批,可以看見它們實際卡在哪裡:
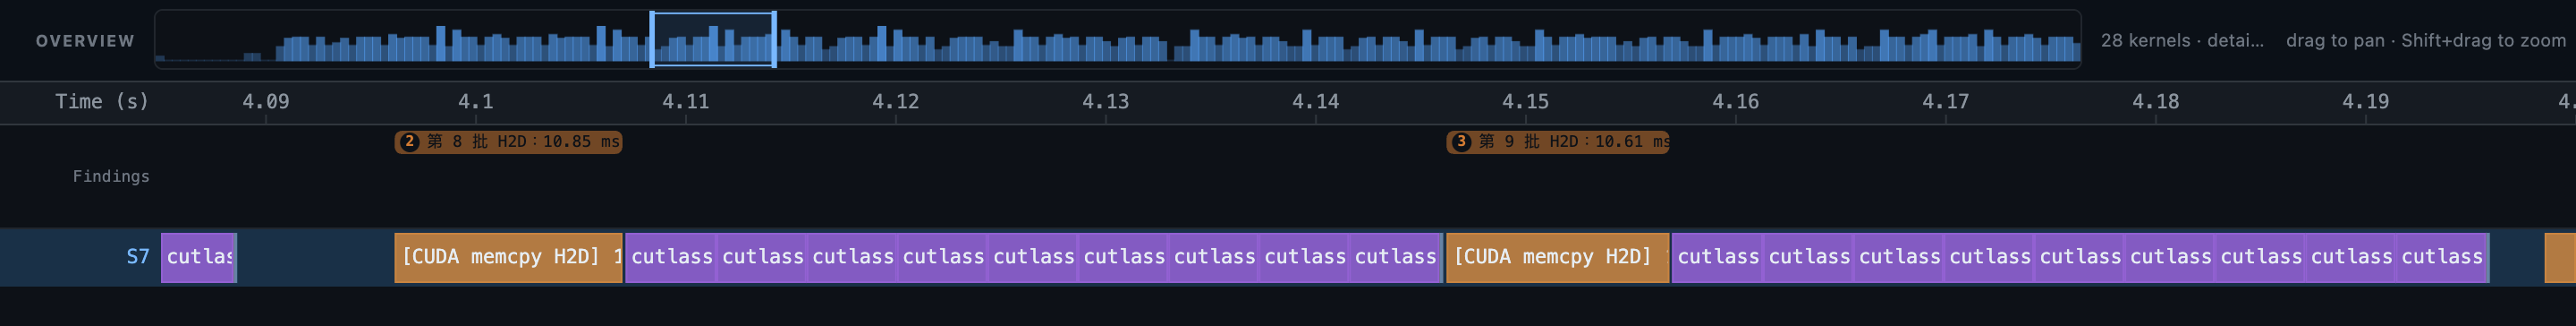
圖 1:patched_split.sqlite 的 nsys-ai timeline 實際畫面,範圍為 4.085–4.200 秒。S7 是 device 0 的 stream 7;橘色是 H2D,紫色主要是 GEMM。上方 overview 的框線標出這個時間窗在整份 profile 中的位置。兩批都呈現「先搬資料、再計算」,沒有跨批次的 copy/compute overlap。
| 事件 | Trace 時間(秒) | 持續時間 |
|---|---|---|
| 第 8 批 H2D | 4.096127–4.106976 | 10.850 ms |
| 第 8 批的 9 個 GEMM | 4.107122–4.145879 | 約 38.758 ms |
| 第 9 批 H2D | 4.146218–4.156830 | 10.612 ms |
| 第 9 批的 9 個 GEMM | 4.156950–4.195719 | 約 38.769 ms |
第 8 批算完後,第 9 批才開始搬進 GPU。中間雖然幾乎沒有額外停頓,下一批仍然得付出約 10.6 ms 的 H2D,之後才能開始約 38.8 ms 的計算。這種「搬完才算、算完才搬下一批」的順序,讓運算單元每批都會空出一段時間。
主要 GEMM 單次平均約 4.31 ms,每批的 9 次計算也很接近。這次觀察指向的是 batch 之間的資料交接。若下一批能提早準備,就有機會讓這段 H2D 變短,或讓部分準備工作與上一批計算同時進行。
不是每個 batch 邊界都只有 H2D。把時間窗移到 4.555–4.610 秒,可以看到另一種情況:上一批已經結束,下一批卻還沒開始搬。
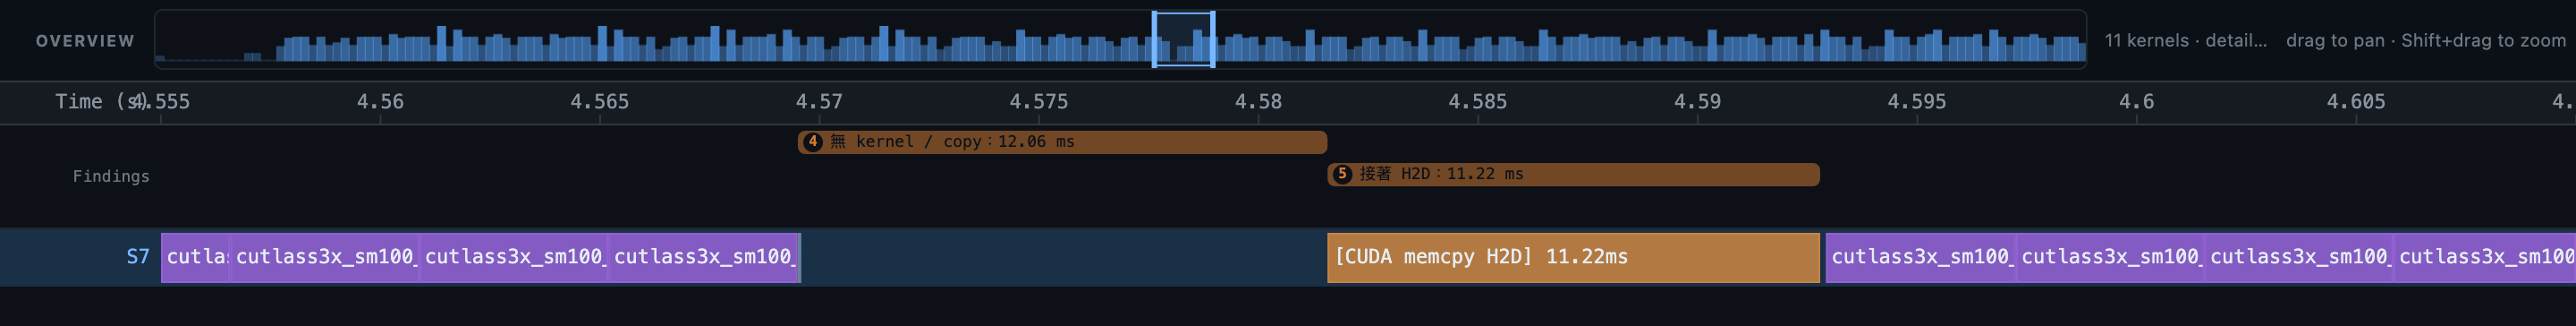
圖 2:前一批 D2H 在 4.569505 秒結束,下一批 H2D 到 4.581567 秒才開始。中間約 12.06 ms 沒有 kernel 或 copy;接著才是約 11.22 ms 的 H2D。同一段 kernel gap,包含了兩種不同的時間成本。
這個差別會影響改善方向。縮短 H2D,處理的是橘色長條;若想連前面的空白一起縮短,還要追查 batch 何時準備好、何時交到 GPU actor,以及 host 端是否正在做轉換或等待。
目前這份 profile 只錄 GPU actor,沒有 CPU workers 的完整載入時序。因此,圖 2 能證明 GPU 當時沒有 kernel/copy 活動,卻還不能證明它是在等 CPU loader。回查 Ray 的程式碼時,這兩件事必須分開。
剩下的空白也不全是 batch 交接。最長的一段約 86.5 ms 出現在第一個 GEMM 之前:
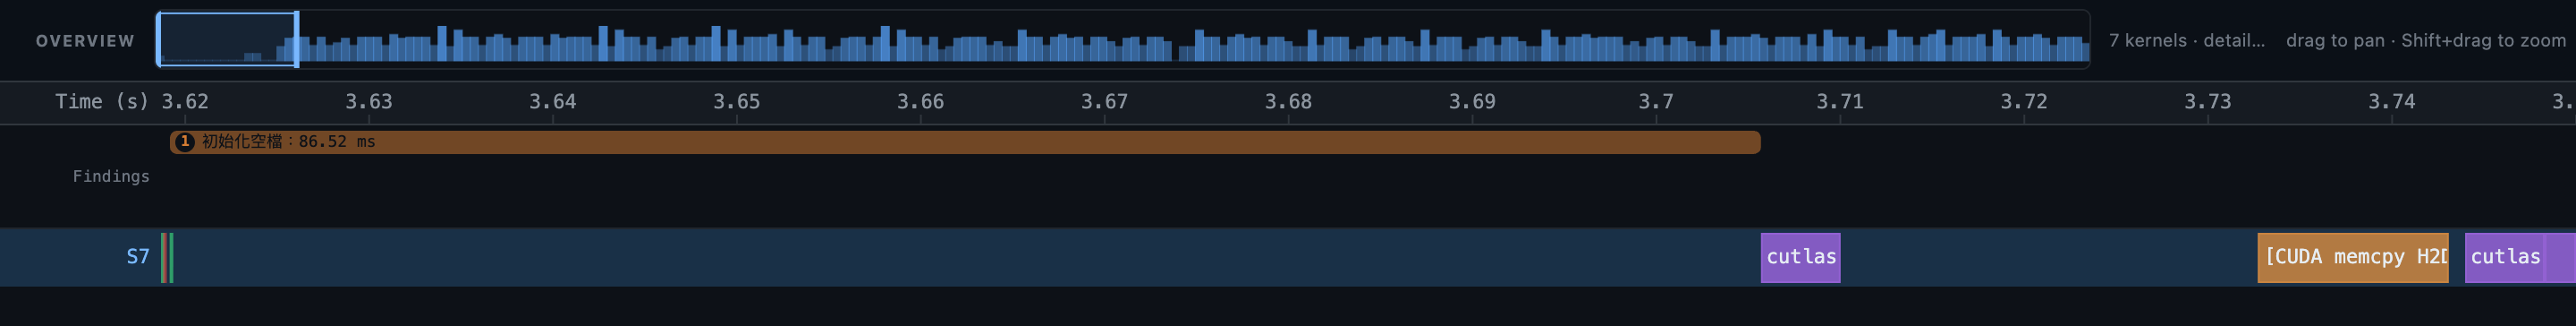
圖 3:約 3.619–3.750 秒的初始化時間窗。這張圖顯示的是 GPU 活動;另對照同一時段的 CUDA API 記錄,可以看到 library/module loading。這段成本不能當成每批都會出現的等待,也不能直接外推成持續執行時的改善空間。
至此,約 566 ms 的 kernel 空檔就有了更具體的分類:每批固定出現的 H2D、部分 batch 邊界額外出現的空白,以及初始化。接下來要優先追的是前兩者,因為它們發生在資料持續送入 GPU 的過程中。
回到第 8 批,對照同一時間窗的原始 NVTX 記錄,還有一個容易看錯的地方:CPU NVTX forward 標記只有約 0.196 ms,D2H 卻長達 38.704 ms;GPU 真正的 D2H copy,則只有約 0.0035 ms。
PyTorch 預設以非同步方式提交 GPU 工作。CPU 很快就能把 9 次矩陣乘法排進 stream,離開 forward 區塊,再進入 .cpu();但結果必須等前面的 GPU 計算完成,才能搬回主機。因此這裡長長的 D2H 標記,包含了等待前面 GEMM 完成的時間。PyTorch 的 CUDA semantics 也說明了這種非同步提交與跨裝置複製時的同步行為。
對齊兩邊的時戳,就會發現 CPU 已進入 D2H 區塊時,GPU 仍在執行 GEMM。CPU NVTX 表示的是程式停留在哪個區塊,GPU activity 才是裝置實際在算或在搬的時間。這裡的 CPU 時間來自原始 NVTX_EVENTS;本次使用的 nsys-ai timeline NVTX 列是 GPU 投影區間,不能拿它的寬度當成 CPU 停留時間。
map_batches 的實際路徑為什麼拆了 CPU operator,GPU 還是得等 H2D?因為前面的 operator 準備好的是 NumPy array,GPU 需要的則是 device tensor。
Ray 的 map_batches planner 會建立 BatchMapTransformFn。執行時,它的 _pre_process() 先呼叫 batch_blocks(),把收到的 blocks 切成 batch 並轉成指定格式;接著 _TransformingBatchIterator 逐批呼叫使用者函式(UDF)。這份 workload 的路徑如下,原始碼版本為 c8466ab8:
blocks 已交給 GPU actor task
  → batch_blocks:切 batch、format、必要時複製
  → _TransformingBatchIterator
  → Predict.__call__
      → torch.tensor(..., device="cuda")
      → forward
      → D2H
關鍵在 batch_blocks() 的輸入已經是 fetched blocks。它的 docstring 也明確寫著,這個函式本身不負責 block prefetch。更重要的是,GPU UDF 要到 __call__() 裡才把 NumPy array 轉成 CUDA tensor;因此這次 H2D 一定發生在「batch 已經準備好」之後、「forward 可以開始」之前,直接落在 consumer 的 critical path。
max_tasks_in_flight_per_actor=4 允許多個 Ray task 提前送進 actor,但它不會自動把 NumPy batch 搬到 CUDA。這次也沒有啟用 enable_true_multi_threading,UDF 的執行受限於單一執行緒。Task 能提前排隊,並不表示下一批 tensor 已經準備好給 GPU 使用。
iter_torch_batches 把資料準備放在哪裡?Ray Data 的 iterator 路徑其實已經有一套可參考的 pipeline。iter_torch_batches() 把流程拆成:
prefetch blocks
  → resolve
  → blocks_to_batches
  → format / collate thread pool
  → restore order
  → finalize(例如搬到 GPU)
  → consumer
外層再用 iter_threaded() 執行整條 fetch pipeline。當使用者設定 pin_memory=True 時,pinning 會包在 collate 階段;finalize_fn 則負責把 tensor 搬到指定 device。換句話說,consumer 呼叫 next() 時,有機會拿到已經在背景完成準備的 tensor,而不是進入 consumer 後才開始做 NumPy → pinned → CUDA。
這讓資料準備有機會與使用者的計算同時進行。對這次的 GPU actor 而言,也可以考慮相同方向:把 NumPy 轉換、pinning 與 H2D 視為一個 staging 階段,在當前批次執行時,先處理下一批。
兩條路的差異也不是單純少一個參數。iter_torch_batches 是資料的消費端,tensor 交給同一個 consumer;map_batches 則是可重試、可 fusion、會產生新 Dataset block 的轉換算子。如果要讓 GPU actor 提前持有 device tensor,還要一起定義 ordering、buffer ownership、取消與 retry 的生命週期,不能直接把 iterator 的實作整段搬過來。
從原始碼看,至少有三個不同層次的解法:
| 方向 | 適用情境 | 優點 | 限制 |
|---|---|---|---|
改用 iter_torch_batches |
Dataset 最後就是交給單一 training/inference consumer | 現成支援 prefetch、pin memory 與 device finalize | 不適合還要繼續組 Ray Data operator 的流程 |
先支援 TorchInference |
使用 Ray 管理的 Torch inference 介面 | collate → H2D → process_on_device → D2H 邊界清楚,改動面較小 |
只能涵蓋 TorchInference 使用者 |
在通用 map_batches 加 staging hook |
想讓一般 GPU callable class 也受益 | 能直接處理這次 workload | dtype、輸入型別、fusion、retry 與生命週期都更複雜 |
這個版本的 TorchInference wrapper 依序執行 collate、H2D、compute 與 D2H,兩次 transfer 都使用 non_blocking=False。由於 CPU tensor 與 GPU tensor 的邊界明確,這是一個範圍較小的改善位置。若要涵蓋本例的一般 callable class,則可在 batch_blocks 產生 batch 後、UDF 呼叫前加入 staging。
Pinned memory 是固定在主機記憶體中的 page-locked buffer,能作為非同步 H2D 的來源;但把現有 NumPy 資料放進 pinned buffer,本身就需要 CPU 複製。若這一步仍在 UDF 開頭同步執行,GPU 只是換成等待 CPU copy,總時間不一定會縮短。PyTorch 的 pin memory 教學 也提醒,手動 pinning 的成本必須一起考慮。
比較有機會的安排,是在 GPU 計算第 N 批時,由背景執行緒準備第 N+1 批。要進一步讓 H2D 與計算重疊,還需要硬體支援、pinned source、不同 CUDA streams,以及足夠早的資料交付。NVIDIA 的非同步搬移說明 列出了這些條件。
框架也必須管理資料的生命週期:來源 buffer 得保留到 H2D 完成,下一批不能覆寫 UDF 還在用的輸入,取消與重試時則要收掉尚未完成的背景工作。這些條件決定了 staging 應該放在哪個層級,也適合在 Ray Data 的 design issue 中和維護者一起討論。
今天從 timeline 看見,每批 H2D 都沒有與計算重疊,部分 batch 之間還有額外空白。對照 Ray Data 的資料路徑後,一個值得嘗試的方向是:讓 GPU 計算當前批次時,就先準備下一批資料。
明天會動手修改程式,再用相同的 workload 重新 profile,比較 GPU 的空檔和整體執行時間,看看這個方向是否真的有效。若確認有改善,就把修改、測試與量測結果整理成 PR,貢獻回 Ray。
batch_blocks 原始碼(c8466ab8)
plan_udf_map_op 原始碼(c8466ab8)
c8466ab8)
iter_torch_batches


 iThome鐵人賽
 看影片追技術