
昨天看到的 Ray Data pipeline,已經把資料載入和 GPU 計算拆成不同 operator。不過,一般 map_batches UDF 收到 NumPy batch 後,還得自己把資料搬到 GPU;這份 workload 的下一批輸入,也沒有提早在背景完成 pinned staging。
今天就來改這一段:在 Ray Data 把 batch 交給 GPU UDF 之前,加上一條背景執行緒,先準備下一批資料,再重新錄 profile。
第一輪測量看到了改善。同樣的輸入資料量與矩陣乘法工作量,H2D 時間減少 81.4%,第一個到最後一個 kernel 的時間跨度縮短 16.8%。但原先期待的 H2D/compute overlap,量出來仍然是 0 ms。這是相對於原本設定的效果,還不能回答它是否比調整過 concurrency 的原版 Ray 更快。
先把今天的定位講清楚:這是一次完整的「改一段程式碼 → 用 nsys-ai 重新驗證 → 看清楚好在哪、又還差什麼」的迴圈,而不是一張準備送出的 PR。後面會看到,這個修改確實讓某些事件變短,但要真正貢獻回 Ray,還得補上正確性測試、和既有設定做公平對照,並收掉現在還沒重疊的那一段。今天先把成果與限制都攤開,讓「值得向社群提出的問題」自己浮現。
為什麼有 copy stream,也有 non_blocking=True,兩者還是沒有重疊?這次得把 GPU timeline 和 CPU 端的 CUDA API 放在一起看。
這次在 Ray 原始碼裡加入一個實驗性的 PinnedPrefetch,位置在 batch 切分、格式轉換之後,UDF 收到資料之前。它只預取一批,不讓兩個模型 UDF 同時執行:
原本:取得 NumPy batch → UDF 內 H2D → 計算 → 回傳結果

修改後:
  背景執行緒:準備 batch N → 提交 N 的 H2D → 等待搬移完成
  UDF 執行緒:取得 N → 啟動 N+1 的背景準備 → 執行 N 的計算
背景工作包含建立獨立的 CPU 副本、轉成 pinned tensor,再透過專用 CUDA stream 搬到 GPU。UDF 端的差異如下,計算和輸出路徑維持相同:
# 修改前:Ray 傳入 NumPy array,UDF 才開始搬資料。
x = torch.tensor(batch["x"], device="cuda:0")

# 修改後:實驗性的 staging layer 已完成搬移與 stream 交接。
x = batch["x"]  # CUDA tensor

# 兩組都執行相同的計算與 D2H。
for _ in range(9):
    x = x @ weight
out = x[:, 0].to("cpu", non_blocking=False)
prototype 暫時透過 ActorPoolStrategy(pinned_staging=True) 啟用。這是本次實驗新增的參數,不是 Ray 已發布的 API;開啟後,UDF 收到的也從 NumPy array 變成 CUDA tensor,使用者必須配合調整 UDF。
目前僅支援同步 map_batches、batch_format="numpy"、正整數 batch size、num_gpus=1 與 zero_copy_batch=False,並將 actor call concurrency 固定為 1、停用 operator fusion。這樣可以先測試「背景準備輸入」的效果,不必同時處理多個 UDF 的模型狀態與 stream 競爭。
非同步搬移增加了一個責任:CPU buffer 必須活到 H2D 完成,CUDA tensor 也不能在計算還沒用完時被回收或覆寫。
producer 在 copy stream 記錄 event,接著呼叫 ready.synchronize()。這個等待發生在背景執行緒;上一批的 GPU 計算仍可繼續。Future 只有在 H2D 完成後才回傳,因此 pinned source 可以安全釋放。
consumer 再對目前的 stream 做 wait_event(),並替收到的 tensor 呼叫 record_stream()。前者建立使用前的依賴,後者讓 PyTorch allocator 知道 tensor 還會被這條 stream 使用;record_stream() 本身不負責等待資料搬完。這版 producer 已經等過 event,consumer 的 wait_event() 保留的是明確的交接關係。PyTorch 的 CUDA stream 說明也區分了這兩個責任。
另外,只有 consumer 會推進上游 iterator,背景執行緒只接收已取出的 batch。每批使用獨立儲存空間,提前結束或重試時,則先等待 producer 收尾。這些限制避免上游 UDF 意外換到另一條 thread,也避免未完成的 H2D 仍在讀取已釋放的記憶體。
這裡沒有省掉所有 CPU copy。實作仍是先建立可寫、連續的 CPU 副本,再呼叫 pin_memory();planner 只是略過原本額外的 writable-batch copy,把副本的建立交給 staging layer。要不要直接複製進預先配置的 pinned buffer,是後續可以再測的方向。
Day 28 的 workload 只有 32 批。這次要測 task 內的預取,因此重新建立成對實驗:每個 CPU block 放四批資料,共 32 個 blocks、128 批。兩組都採用這個配置,不能拿昨天的短 profile 直接當今天的 baseline。
| 共同條件 | 設定 |
|---|---|
| GPU | 一張 NVIDIA B200,actor 內記為 device 0 |
| Ray | 同一個原始碼基底 c8466ab8,比較關閉/開啟 prototype |
| 輸入 | 每批 2048 × 8192 FP32,64 MiB;共 128 批、8 GiB |
| 計算 | 每批 9 次矩陣乘法,權重為固定的單位矩陣 |
| 上游載入 | 4 個 CPU workers,每批模擬 40 ms 載入並建立陣列 |
| GPU UDF | 1 個 actor、同時 1 次呼叫,不開 true multi-threading |
| 輸出 | 每批把結果的一欄搬回 CPU |
這是固定工作量的資料管線實驗,不是完整 AI 模型的推論 benchmark。
四批合計約 256 MiB,target_max_block_size 設為 512 MiB,讓本次資料配置保留一個 task 內多批輸入的機會。PinnedPrefetch 是在每次 GPU map task 裡建立的;如果 task 只有一批,就沒有下一批可以提前準備。
這是整套 prototype 與原路徑的比較,不是只改 pin_memory 一個變因。除了輸入搬移位置,內部 copy、UDF 執行緒包裝與 fusion 設定也有調整。若要拆出每項修改各自帶來多少收益,還需要另外做對照實驗。
兩份 profile 分別是 final_split.sqlite 與 final_staged.sqlite。用 nsys-ai 比對整份 trace 的工作量,再以 memory_transfers、gpu_idle_gaps 和 pipeline_bubble_metrics 拆開搬移與空檔;局部時序則回到 timeline、CPU NVTX 和 CUDA runtime events 核對。
要重跑這組實驗,可以使用同一份公開的 workload_staged.py,依下表選擇模式。連結固定在同一個資料集版本,避免程式或 profile 更新後對不上:
| 程式參數 | Ray 設定 | 對應 profile |
|---|---|---|
--mode split --profile --blocks 32 |
c8466ab8 基底,關閉 staging |
final_split.sqlite |
--mode staged --profile --blocks 32 |
同一基底加上 prototype patch,開啟 staging | final_staged.sqlite |
表中是依封存程式整理的重跑參數,不是當時終端機指令的逐字紀錄。兩組的 actor call concurrency 都是 1。
例如,先確認整體差異與搬移量,再打開修改後的 timeline:
nsys-ai diff final_split.sqlite final_staged.sqlite --gpu 0 --format json
nsys-ai skill run memory_transfers final_split.sqlite --format json
nsys-ai skill run memory_transfers final_staged.sqlite --format json
nsys-ai timeline-web final_staged.sqlite
先看事件數量:兩邊都有 128 次 H2D、128 次 D2H,以及 1284 個 kernels。其中主要 GEMM 都是 1153 次,等於 128 × 9,再加一次 warmup。H2D 總量同為 8 GiB,換成十進位約 8.59 GB。
程式也檢查輸出總列數為 262,144,並取前 8 列做 allclose。這可以做基本的完成度與數值檢查,但還不能證明所有輸出都正確:每列輸入都是 1,也不足以抓出 batch 重複或順序錯誤。若要正式提交修改,還需要帶不同識別值的資料和完整輸出比對。
下面沿用 Day 28 的口徑:從第一個 kernel 到最後一個 kernel,包含初始化與 warmup。它是 actor trace 的 kernel span,不是整個 Ray job 的端到端時間。
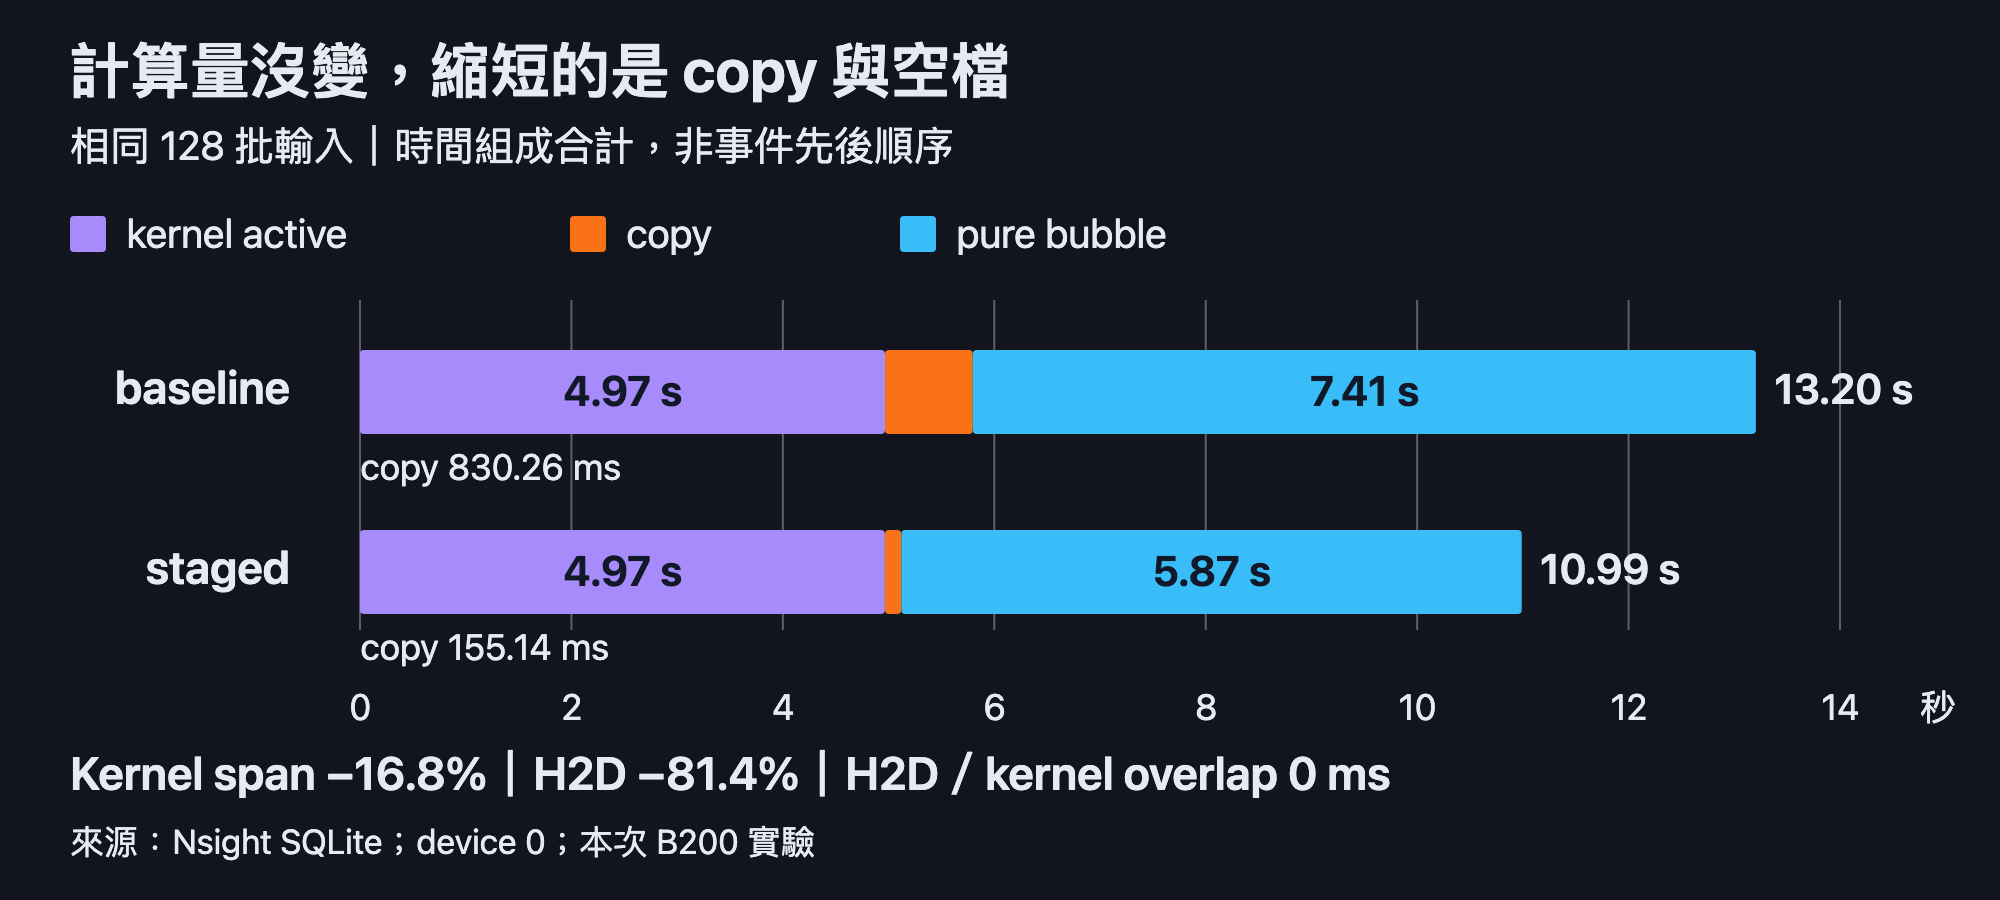
圖 1:依 Nsight SQLite 的實際事件區間整理。長條是各類時間的合計,不代表事件的先後順序;copy 包含 H2D 與很短的 D2H。兩份 trace 都沒有 copy/kernel 重疊,因此可以排成互斥的時間組成。
| 指標 | baseline | staged |
|---|---|---|
| H2D duration 合計 | 829.81 ms | 154.68 ms |
| H2D 等效頻寬 | 約 10.35 GB/s | 約 55.53 GB/s |
| kernel active | 4966.33 ms | 4965.45 ms |
| kernel span | 13204.18 ms | 10989.16 ms |
| 沒有 kernel 的時間 | 8237.85 ms(62.4%) | 6023.71 ms(54.8%) |
| pure bubble | 7407.59 ms(56.1%) | 5868.57 ms(53.4%) |
| H2D/kernel 時間交集 | 0 ms | 0 ms |
kernel active 幾乎沒變,H2D 則少了約 675 ms。Nsight 的 memory kind 也確認:baseline 的來源是 pageable memory,staged 改成 pinned memory。對這份 workload 而言,改變 staging 路徑後,搬同樣的資料所需時間確實縮短了;表中的頻寬是 bytes 除以 device copy duration,沒有把 CPU copy、pinning 或配置時間算進去。
pure bubble 指這份 actor trace 沒有記錄到 kernel、memcpy 或 memset 的時間,從約 7.41 秒降到 5.87 秒。這不代表整台機器或其他程序的 GPU 活動也停止了,更不能只憑空白就斷定是在等上游 loader。
從時間組成來看,copy 少約 0.675 秒,pure bubble 少約 1.539 秒,加上幾乎不變的計算時間,對應到 kernel span 少約 2.215 秒、縮短 16.8%。若另以第一批計算開始到最後一批計算結束為界,排除前面的初始化與 warmup,則是約 13.006 秒對 10.723 秒,方向也一致。這兩種範圍都不是單批 latency。
先從修改後的 GPU timeline 看第 5–8 批。計算在 stream 7,這個 task 的 H2D 在 stream 17:
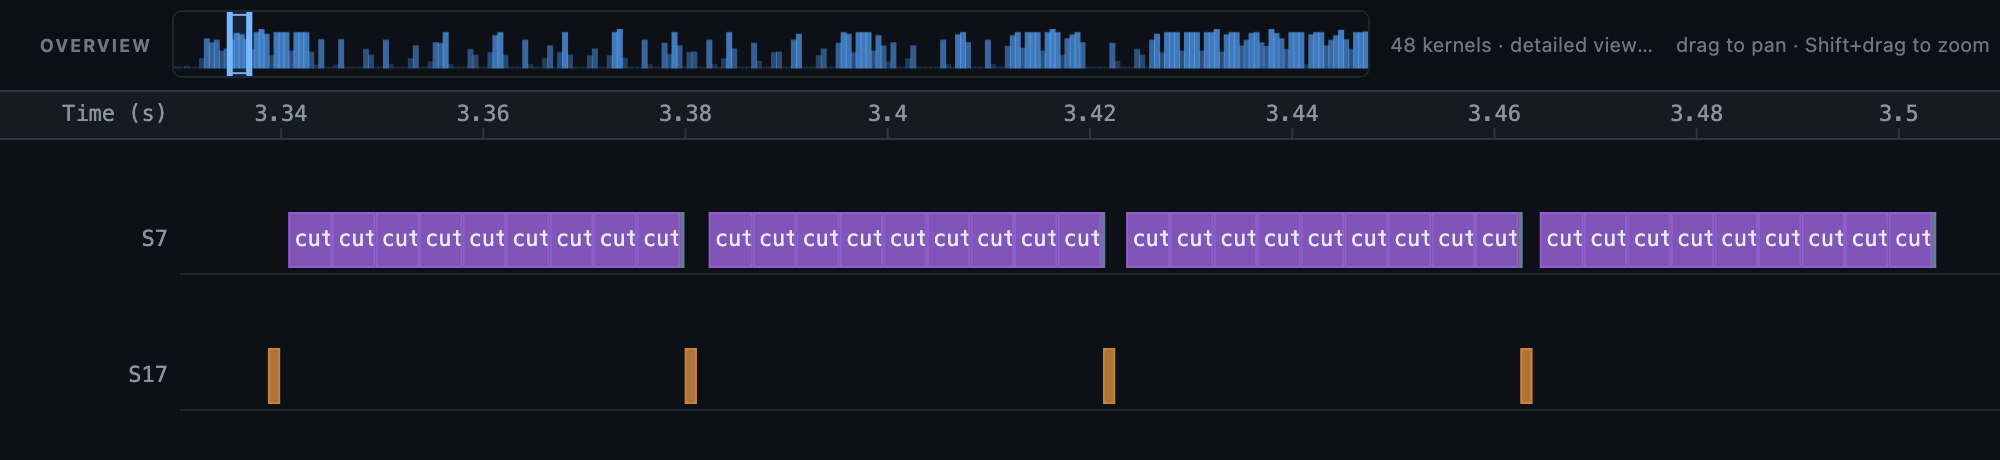
圖 2:final_staged.sqlite 的 nsys-ai 實際畫面,範圍為 3.330–3.510 秒,只顯示這段的 stream 7、17。橘色 H2D 變短了,但沒有與紫色計算長條重疊。
回頭看 CPU NVTX,128 段 ray::collate_pin 中,有 96 段和 GPU kernel 的時間區間相交,交集合計約 2.517 秒。這裡使用的是 CPU 上原始的 NVTX range,不是把它投影到 GPU 後的範圍。它支持的是「背景 copy/pinning 與 GPU 計算同時進行」,不能改寫成「H2D 已被計算遮住」。
原本很容易猜:是不是 CPU 準備太慢,所以 H2D 趕不上?有些批次確實如此,但第 5、6 批提供了另一個線索。
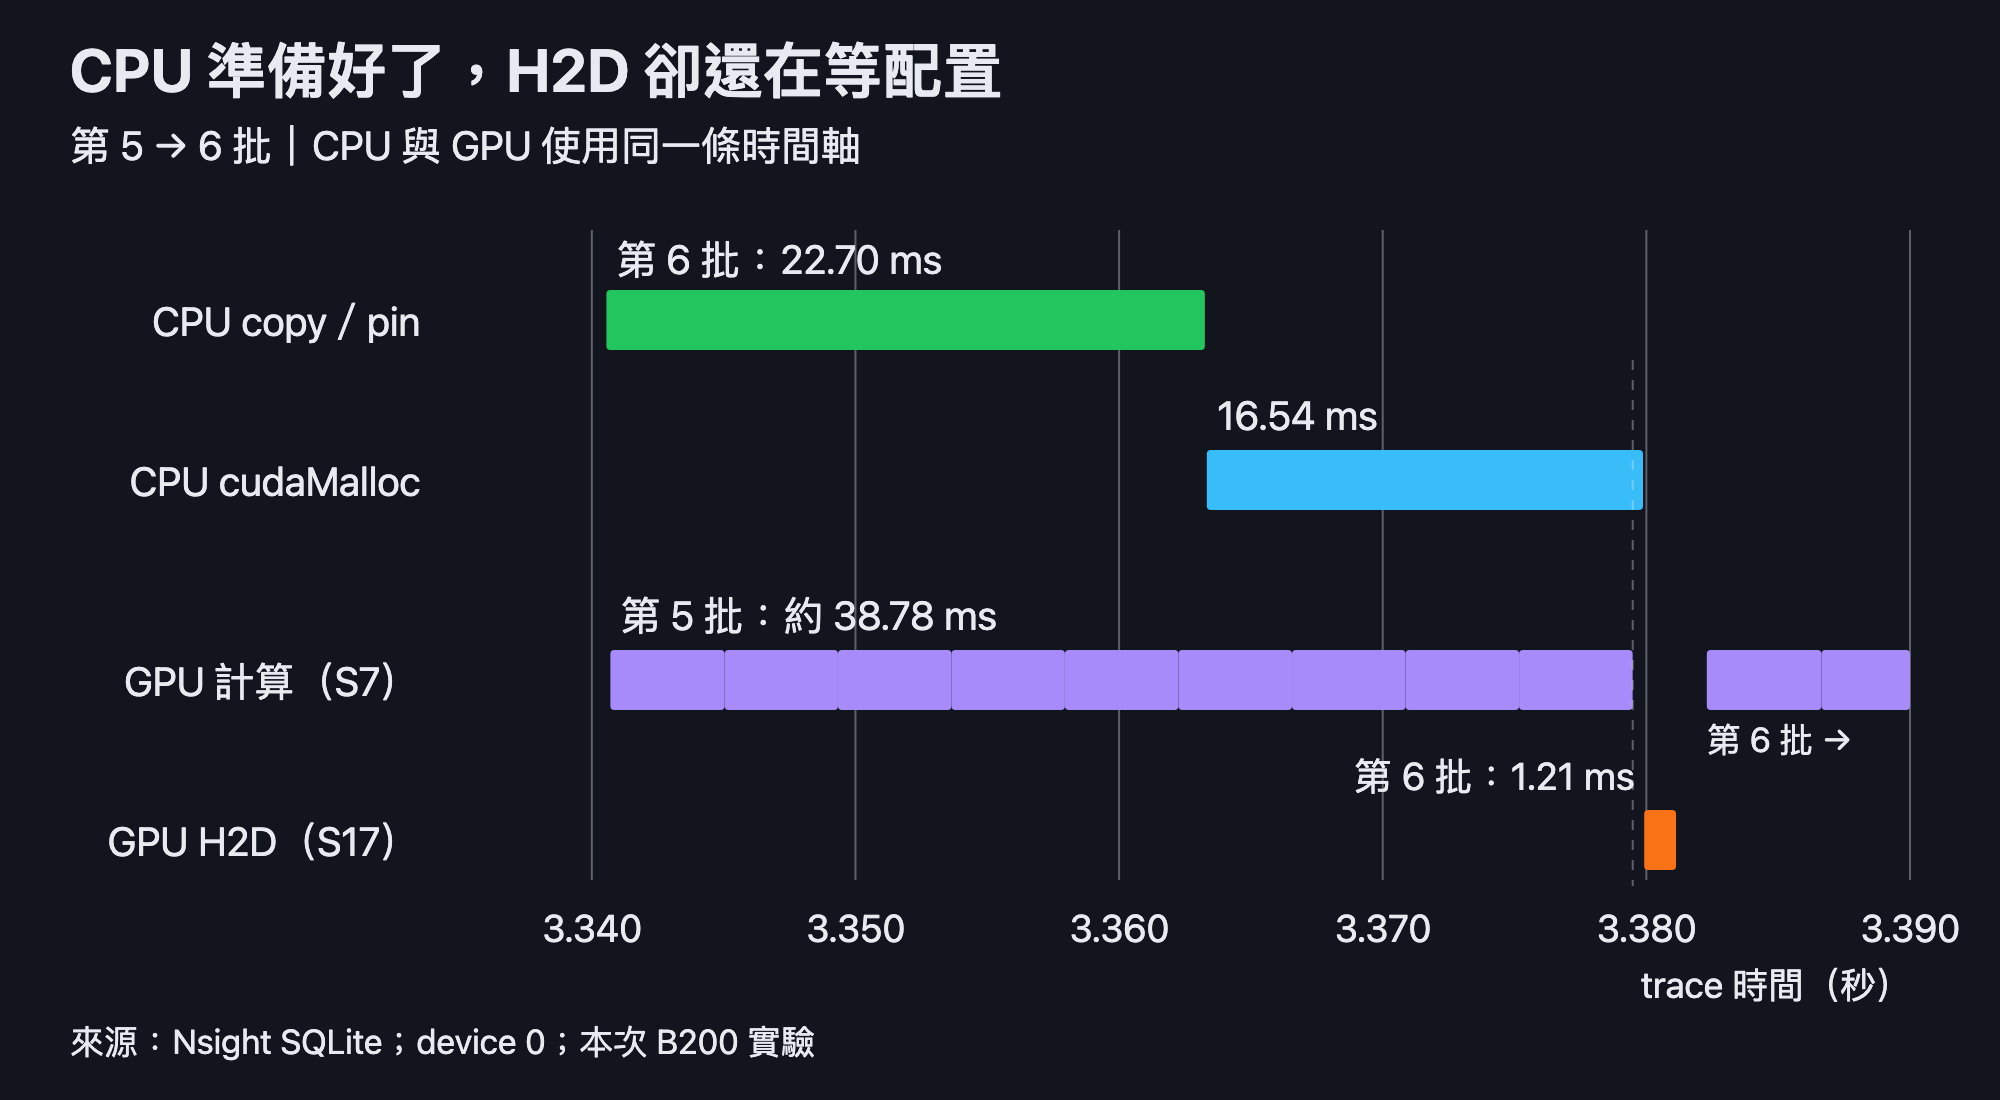
圖 3:從同一份 SQLite 的 CPU NVTX、CUDA runtime 和 GPU 事件重繪,統一使用 trace 時間。上方是 CPU 工作,下方是 GPU 執行;cudaMalloc 長條表示 CPU API 呼叫持續時間,不是 GPU copy。
| 事件 | Trace 時間(秒) | 持續時間 |
|---|---|---|
| 第 5 批 GPU 計算區間 | 3.340704–3.379483 | 約 38.78 ms |
| 第 6 批 CPU copy/pin | 3.340553–3.363253 | 約 22.70 ms |
第 6 批 H2D 路徑內的 cudaMalloc |
3.363328–3.379872 | 約 16.54 ms |
| 第 6 批 device H2D | 3.379918–3.381127 | 約 1.21 ms |
第 6 批的 CPU copy/pin 在第 5 批計算結束前約 16 ms 就完成了,但 .to(device, non_blocking=True) 還需要取得 device 儲存空間。這次呼叫走到了 cudaMalloc,直到第 5 批計算結束後才返回,接著才提交 H2D。
因此,至少在這個窗口,不能把沒有 overlap 解釋成「CPU copy/pin 花光了時間」。配置記憶體也是搬移路徑的一部分。NVIDIA 的文件將 device memory allocation 列為可能造成隱含同步的操作,這份 trace 的時序與這個機制相符;但若要確認消除配置等待後能恢復多少 overlap,仍需要再做對照實驗。CUDA Programming Guide:Implicit Synchronization
這也不是只在初始化發生一次。128 個 ray::H2D CPU ranges 裡,共包含 62 次 cudaMalloc 呼叫。不過 PyTorch 有 caching allocator,不能因此推論每次 .to() 都會直接呼叫 cudaMalloc;應以實際 CUDA API 記錄為準。
下一個值得測的修改,是讓儲存空間提早準備好,再用 copy_() 搬入既有 buffer,觀察 H2D 能不能更早發出。但通用 UDF 可能保留輸入 tensor,不能擅自重用或覆寫它。固定兩塊 buffer 的做法,需要先定義誰擁有資料,以及什麼時候才算用完。
整份 trace 的 kernel gap 分布也有變化:
| kernel gap 大小 | baseline | staged |
|---|---|---|
| 1–5 ms | 1 | 70 |
| 5–50 ms | 99 | 26 |
| 大於 50 ms | 30 | 34 |
短空檔變多、中型空檔變少,符合部分批次交接變快的結果。但大於 50 ms 的空檔並沒有減少。光看它們的數量接近 32 個 tasks,還不能把原因歸到 task 邊界。
這份 staged trace 有 32 條 H2D streams,每條連續搬四批,對得上 prototype 每個 task 建立一個 prefetcher/copy stream 的方式。沿著 128 次 Predict::staged 呼叫逐批核對,可以把 127 個批次交接分成:
| 修改後的批次交接 | 交接次數 | kernel 空檔合計 | 其中大於 50 ms |
|---|---|---|---|
| 同一組四批內 | 96 | 約 3037 ms | 20 |
| 跨到下一組四批 | 31 | 約 2720 ms | 12 |
這張表不含初始化與 warmup,也不含同一批內的 kernel gap,所以不能直接與上表的 34 次相比。重點是:跨 task 的等待值得處理,但同一個 task 內仍有不少長空檔。
目前只能說,task-local prefetch 確實無法提前準備下一個 task 的第一批;至於剩下的等待各有多少來自 CPU copy/pin、配置記憶體或上游交付,還要補更多觀測。尤其沒有 CPU workers 的完整 timeline,不能把剩餘空白全部叫做「資料載入太慢」。
GPU trace 用來解釋時間花在哪裡,但 profiler 本身也可能擾動時序。整條 pipeline 是否變快,還要看不開 profiler 的執行結果。這次各跑五次,計時範圍是 materialize(),包含 CPU 載入、actor 啟動與 warmup,不含後面的 report flush 等待。
| 模式 | 五次執行紀錄(秒,取一位小數) | 中位數 |
|---|---|---|
| baseline | 21.9、22.5、23.5、38.1、21.0 | 22.5 秒 |
| staged | 24.2、14.7、18.6、16.3、12.0 | 16.3 秒 |
中位數約縮短 27.6%,但兩組都有明顯變異。這是共享主機上的五次測試,不能直接當成所有 Ray Data 工作負載都能得到的加速幅度,也還不足以精確分辨環境干擾與修改效果。比較合理的結論是:這輪端到端時間有改善跡象,而成對 profile 提供了搬移變短、CPU 準備與計算重疊的具體證據。
還有一組對照要補上:不修改 Ray,只把 max_concurrent_calls_per_actor 從 1 調到 2,會怎樣?
這裡仍保留 enable_true_multi_threading=False,不是讓兩個模型 UDF 同時執行。max_tasks_in_flight_per_actor 也都維持 4。新錄的兩份原版 Ray profile 中,128 段 Predict::split 的 CPU NVTX range 都沒有互相重疊,確認這次模型呼叫仍是依序執行。
9 月 14 日另外重跑三組:相同的 B200、Ray 基底、128 批輸入與計算量,每組五次不開 profiler,再各錄一份 profile。這是新的測量輪次,不能把它和前面 9 月 11 日的數字混在一起算加速比。
| 配置 | 不開 profiler 的 materialize() 中位數 |
單份 profile 的 kernel span | H2D 合計 |
|---|---|---|---|
| 原版 Ray,calls=1 | 12.20 秒 | 9.149 秒 | 1071.15 ms |
| 原版 Ray,calls=2,UDF 仍依序執行 | 9.59 秒 | 6.193 秒 | 976.94 ms |
| prototype,calls=1 | 9.31 秒 | 6.283 秒 | 154.61 ms |
三份 profile 都有 128 次 H2D、相同的 8 GiB 搬移量與 1284 個 kernels,kernel active 約 4.96 秒,H2D/kernel 交集也都還是 0。表中的 kernel span 來自另外錄製的 profile,不是中位數那一次執行的時間。
只調整既有 concurrency,就能消除不少等待;prototype 的 H2D 雖然更短,kernel span 卻沒有比這組原版 Ray 更短。 不開 profiler 的中位數也只差約 0.28 秒。原版兩組採交錯順序測量,prototype 則接著測;考慮共享主機的變異和每組只有五次,還不能把這點差距當成穩定的額外收益。
因此,第一輪分析仍能說明「這份修改讓哪些事件變短」,卻不足以回答「使用者是否需要修改 Ray」。後者得把既有設定一起放進來比較。
目前的結果支持繼續改善 staging 路徑,但還不能把第一版當成完成的優化。沿著 profile 裡的線索,我們又做了兩個候選版本,分開檢查 CPU copy 與配置時機:
pin_memory()」中間的那次複製。copy_() 搬進已配置的空間,嘗試避免在計算進行到一半時才碰到配置等待。提早配置只用在不經 custom collator、已知 NumPy 輸入形狀與型別的路徑。如果形狀還要經過 collator 才能確定,就維持在背景執行緒配置。每批也仍使用獨立的 CUDA 儲存空間,不會為了重用 buffer 而覆寫 UDF 保留的輸入。
前面用來量測的第一版,已通過三個 mock 測試與一個 B200 CUDA 測試。加入提早配置的候選版本則通過了 10 項非 GPU 測試,另外四項 CUDA/Ray pipeline 測試尚未執行,也還沒有新的 profile。因此,前面的 81.4% 與 16.8% 都是第一版的結果,不能算成這兩項新修改的收益。
後續會先補齊 GPU 正確性測試,再和調整過 concurrency 的原版 Ray、第一版 prototype 一起重測。除了 H2D 與 kernel span,也要看端到端時間和記憶體用量,確認改善是否穩定,以及少一次 copy、提早配置各自帶來多少效果。
今天在 Ray Data 的 GPU UDF 前加入背景 pinned staging。第一輪實驗中,H2D 時間減少 81.4%,kernel span 縮短 16.8%,但 copy/compute 仍未重疊。補上既有 concurrency 的對照後,也發現不少等待不必改 Ray 就能改善,目前還不能說 prototype 比調整過的原版更快。
nsys-ai 整理了前後差異,timeline 則幫助我們追到 CPU copy 與配置等待,找到下一輪修改的方向。接下來會繼續改善這段輸入路徑,補齊正確性與取消/重試測試,等確認效果後,再把可重現的程式、profile 與修改整理給 Ray 社群,逐步貢獻回去。
明天是系列最後一天,會回頭整理這三十天的分析方法:如何從一份 GPU profile 出發,逐步找到程式碼裡可驗證、也能和其他開發者討論的改善方向。
map_batches planner:本次實驗基底 c8466ab8
pin_memory() 與 non_blocking 的使用方式


 iThome鐵人賽
 看影片追技術