

昨天我們成功在 JMeter 上傳併發測試中,證明了前面寫的保護api的功能將 3 秒超時引發的錯誤率從 53% 降至 0%,並透過 Grafana 發現真正的瓶頸在於外部網路 I/O 延遲。
這時大家可能有個非常直覺的疑問:
既然 bottleneck 是網路延遲,那我把 從 3 秒放大到 15 秒(甚至 30 秒),給外部網路充裕的時間傳輸,不就不會發生超時了嗎?
今天我們就來嘗試一下放寬 Timeout 究竟是效能救星還是另一場悲劇的開端呢?
話不多說今天先來做實驗再回頭說理論!
要調整timeout的設定我們目前有三個地方需要調整:
S3Config.java — Netty async client 的底層網路 timeout(connectionTimeout / readTimeout / writeTimeout)
S3Config.java — SDK override 的 apiCallAttemptTimeout / apiCallTimeout
public S3AsyncClient s3AsyncClient() {
  return S3AsyncClient.builder()
    .region(region)
        .credentialsProvider(DefaultCredentialsProvider.create())
        .httpClientBuilder(NettyNioAsyncHttpClient.builder()
            .maxConcurrency(100) // Netty 併發連線數上限
            .connectionTimeout(Duration.ofMillis(15000))
            .readTimeout(Duration.ofMillis(15000))
            .writeTimeout(Duration.ofMillis(15000))
        )
        .overrideConfiguration(configuration -> configuration
            .apiCallAttemptTimeout(Duration.ofMillis(14000)) // 略低於 Netty timeout,讓 SDK 先觸發
            .apiCallTimeout(Duration.ofMillis(15000)))       // 給 HEAD Double-Check 一點空間
        .build();
    }
因為三層的關係如下:
connectionTimeout/ writeTimeout   ← Netty 底層,最先觸發
        ↓
apiCallAttemptTimeout             ← SDK 單次嘗試上限
        ↓
apiCallTimeout                    ← SDK 整體呼叫上限(含重試)
        ↓
slowCallDurationThreshold
昨天的壓測中我們發現,100並發上傳的過程中,沒保護的上傳API錯誤率高達53%,主要問題是等待時間超過,所以我們強制將timeout放寬至 15 秒,接著就要來測試,重新docker compose up --build一次(因為有做程式碼的調整所以要重新建立image),再打開 JMeter 對上傳 API 發射100並發
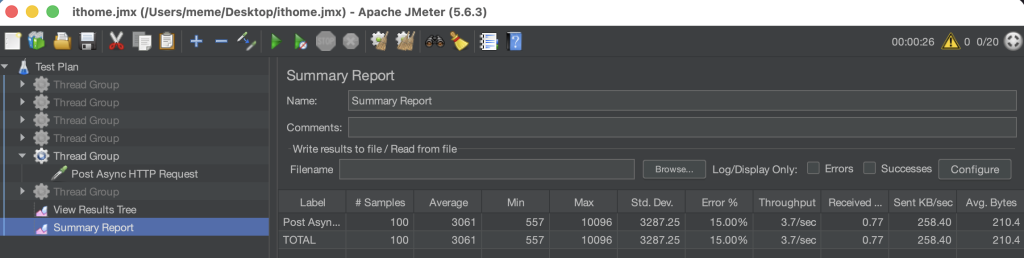
透過Jmeter的結果發現錯誤率下降到15%!代表昨天timeout的結論真的是瓶頸,還有失敗就代表時間還是不夠長,不過我們不可能一昧地調長等待時間,使用者是會生氣的!
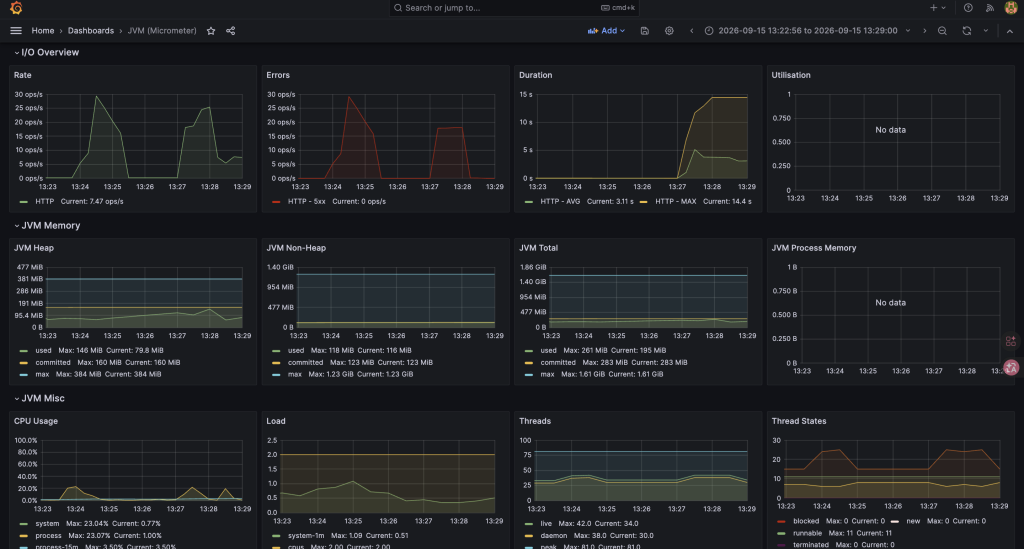
我們來看看監控記錄會發現CPU < 30%、Heap 只有 117MB,系統卻在噴錯?有15%失敗率,因為在放寬 Timeout 的情況下,卡在背景等待網路 I/O 的 TCP Socket 在記憶體中佔用極小、也不消耗 CPU 算力。
傳統的硬體監控會給我們「系統很閒」的假象,但底層的 Socket 連線池與通道(Channel)早已在背景被長時間鎖死無法釋放!這也證實了:高可用系統不能只看硬體資源,更必須透過背壓(Backpressure)與 Fail-Fast 限速釋放連線!
所以回過頭來看看為什麼我們不能無限制地放寬 Timeout?原因有三:
在 HTTP 世界中,使用者點擊上傳後,超過 3 秒沒有回應就會開始感到焦慮,超過 10 秒就會認定系統卡死並開始瘋狂重整頁面。放寬到 15 秒雖然讓後端數據看起來錯誤率下降了,但實際上是讓使用者在手機前白白卡住死等 15 秒!我們在刷社群的時候等個三五秒就受不了了,如果有一個按鈕就要等15秒,根本沒人要用了!
在我們的 15 秒 Timeout 實驗中,依然產生了 15% 的失敗。這代表:當網路壅塞或 S3 機房回應慢時,單純延長等待時間並不能解決物理上的網路丟包或 S3 速率限制(503 SlowDown)。失敗只是說明「15 秒依然不夠長」,但我們不可能設成無限大!
這也是最可怕的後端災難:放寬 Timeout 會讓每一個失敗或卡住的連線,在背景多佔用 Socket 資源 15 秒才肯釋放!
如果放寬timeout或是提升連線池其實都可以降低錯誤率,但又不能開太大會造成socket負擔,那摩最佳組合到底是多少呢?現在為了讓大家理解Timeout 與連線池的物理關係,我們引入 queuing theory 經典的利特爾法則 (Little's Law):
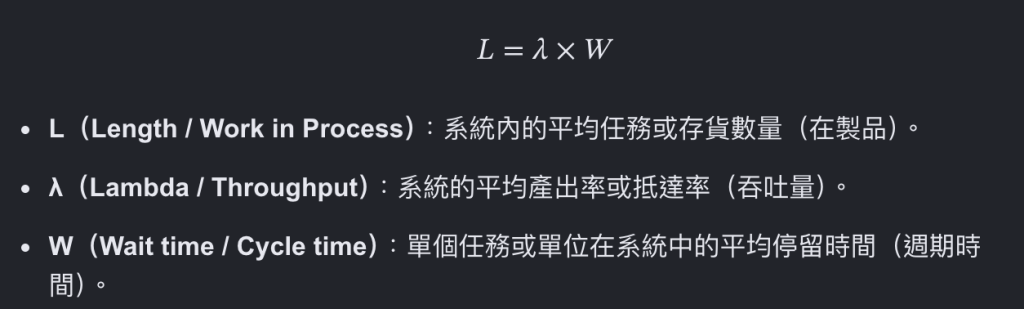
(我打不出這些符號先用截圖的XD,參考gemini 摘要)
假設我們的微服務目標吞吐量 lambda = 100 RPS :
我們可以發現等待時間和背景所需連線數成正比,換言之當把 Timeout 放寬 7.5 倍時,為了維持相同的 RPS,微服務背景必須同時維持 7.5 倍的連線數!
Linux 作業系統對每一個 TCP 連線都有 ulimit -n 開啟檔案限制,如果你的 Netty 連線池(maxConcurrency)或伺服器 Socket 數量沒有跟著放大 7.5 倍,連線池會在幾秒內被全數乾涸,引發更慘烈的排隊延遲與雪崩!
記憶體預算公式:容器記憶體預算 (MB) = 併發連線數 * 單一請求 Buffer 大小 + JVM 基礎開銷
在 Docker 容器設定中:
預估記憶體 = (50 * 5 MB) + 150 MB = 400 MB
我們在 Day 18 將 Docker Compose 記憶體限制設定為 memory: 512M、JVM -Xmx384m 的背後邏輯都是精確計算出來的,絕非憑空捏造!
如果沒有 Semaphore(50) 控流,當 L 暴增到 1500 時: 所需記憶體 = (1500 * 5 MB) + 150 MB = 7650 MB (7.65 GB) 這會直接觸發 Linux OOM Killer,當場把 Docker 容器殺死!
除了連線數暴增,放寬 Timeout 也會直接吞噬 JVM 堆積記憶體(Heap Memory)。
既然放寬 Timeout 是在向未來借債,那正確的架構設計是什麼?
答案是 Fail-Fast(快速失敗)與 Semaphore 背壓控流:
今天透過理論與實作來告訴大家幾件事:
明天我們將為listObject api加入保護措施必且也為其做新舊api的壓力測試,來見證一個完善的服務中在listObject和putObject這兩種最常使用呼叫的api應該要怎麼設計!


 iThome鐵人賽
 看影片追技術