

昨天我們深入剖析了 Timeout 設定與容量規劃的數學公式,證明了盲目放寬 Timeout 只會讓連線池乾涸。
今天,我們要將壓力測試的視角從PUT上傳轉向listObjects 查詢 API,帶大家實作保護型的listObject api,比較「無保護版本」與「具備 Resilience4j 斷路器 + Semaphore 限流的保護版本」在不同壓力條件下的行為差異,揭露當高併發遇上 Netty 連線池上限時,斷路器是如何扮演壓力閥救回系統的!
在 S3 的 API 體系中,列出 Bucket 內物件看似只是一個讀取(GET)操作,但它在生產環境中卻是記憶體與錢包殺手,原因很簡單:
在壓測實驗中,我們發現當對 listObjects 套用 Semaphore(50) 時,1000 個併發請求有 950 個直接被 429 擋掉。這看似保護了系統,卻暴露出了三個致命的架構盲點:
PUT 上傳寫入:具有副作用!如果發生 Timeout 或中斷,會產生孤兒檔案、重複碎片或資料不一致。因此必須用 Semaphore 嚴格控流。List 檔案列表:100% 無副作用(冪等且純讀取)!List 失敗最壞情況就是本次查詢沒拿到,不會在 S3 或資料庫寫入任何髒資料,保護層級與寫入完全不同。PUT 每次都是新的資料:無法跨請求共用快取。List 結果在短時間內高度重疊:1000 個使用者在 1 秒內呼叫 List,看到的檔案列表幾乎完全一樣!如果加上 10 秒的快取(Cache),這 1000 個併發請求在實際上只會打向 S3 1 次! 這比用 Semaphore 硬生生把 950 個人拒之門外(429)要高效且優雅數百倍!我們在service資料夾下,新增一個ListGetway.java的檔案,作為獨立操作的Gateway Bean,邏輯與day說明的 S3PutGateway 一樣 @CircuitBreaker 必須放在獨立的 Bean。
package com.example.s3service.service;

import io.github.resilience4j.circuitbreaker.annotation.CircuitBreaker;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Component;
import software.amazon.awssdk.services.s3.S3AsyncClient;
import software.amazon.awssdk.services.s3.model.ListObjectsV2Request;
import software.amazon.awssdk.services.s3.model.ListObjectsV2Response;

import java.util.concurrent.CompletableFuture;

@Component
public class S3ListGateway {

    @Autowired
    private S3AsyncClient s3AsyncClient;

    /**
     * 實際發出 S3 listObjectsV2 的 method,由 Resilience4j @CircuitBreaker 包裝。
     *
     * 斷路器統計此 method 的失敗率:
     * - 記錄:SdkException(S3 網路/服務異常)與 RuntimeException
     * - 忽略:IllegalArgumentException / NullPointerException(本地參數錯誤)
     *
     * 當失敗率超過 YAML 設定的閾值時,斷路器跳閘,後續呼叫直接觸發 fallback。
     */
    @CircuitBreaker(name = "s3ListCircuitBreaker", fallbackMethod = "s3ListObjectsFallback")
    public CompletableFuture<ListObjectsV2Response> listObjects(String bucket) {
        ListObjectsV2Request request = ListObjectsV2Request.builder().bucket(bucket).build();
        return s3AsyncClient.listObjectsV2(request);
    }

    /**
     * 斷路器跳閘時的 Fallback method。
     * 參數簽名必須與 listObjects 完全一致,末尾多加一個 Throwable。
     * 回傳 failedFuture,讓 S3Service 的 exceptionallyCompose 接手判斷。
     */
    public CompletableFuture<ListObjectsV2Response> s3ListObjectsFallback(
            String bucket,
            Throwable throwable) {
        boolean isCircuitOpen = throwable instanceof io.github.resilience4j.circuitbreaker.CallNotPermittedException;
        if (isCircuitOpen) {
            System.err.println("[" + Thread.currentThread().getName()
                    + "] ⚡ [斷路器 OPEN] List 請求被拒絕: " + throwable.getMessage());
        } else {
            System.err.println("[" + Thread.currentThread().getName()
                    + "] 📊 [斷路器統計失敗] List 失敗原因: " + throwable.getMessage());
        }
        return CompletableFuture.failedFuture(throwable);
    }
}
並且在 S3Service.java中補充加入:
@Autowired
    private S3ListGateway s3ListGateway;
...

 /**
     * 受保護 List 的結果。
     *
     * success=true 代表 List 成功。
     * fallbackMessage 不為 null 代表斷路器已跳閘,直接降級,未發出任何 S3 請求。
     */
    public record ProtectedListResult(
            List<String> keys,
            boolean success,
            String fallbackMessage) {

        /** 正常成功 */
        public static ProtectedListResult success(List<String> keys) {
            return new ProtectedListResult(keys, true, null);
        }

        /** 一般失敗(S3 回傳錯誤) */
        public static ProtectedListResult failed() {
            return new ProtectedListResult(null, false, null);
        }

        /** 斷路器跳閘降級 */
        public static ProtectedListResult circuitBreakerOpen(String message) {
            return new ProtectedListResult(null, false, message);
        }
    }

    /**
     * 非同步保護型列舉(帶有 Resilience4j 斷路器)。
     *
     * 當 S3 連續失敗超過閾值時,Resilience4j 斷路器跳閘(OPEN),
     * 後續請求直接被 s3ListObjectsFallback 攔截,回傳 503 降級訊息,
     * 不再對 S3 發射任何實體請求。
     *
     * List 是讀取操作,不需要 Double-Check 自癒(不像 PUT 存在「成功但
     * 回應遺失」的問題),也不需要 Semaphore 限流(無狀態且無副作用)。
     */
    public CompletableFuture<ProtectedListResult> listFilesAsyncProtected(String bucket) {
        System.out.println("[" + Thread.currentThread().getName()
                + "] 🚀 [LIST 啟動] 開始安全非同步列舉,Bucket: " + bucket);

        return s3ListGateway.listObjects(bucket)
                .thenApply(response -> {
                    List<String> keys = response.contents().stream()
                            .map(S3Object::key)
                            .collect(Collectors.toList());
                    System.out.println("[" + Thread.currentThread().getName()
                            + "] ✅ [LIST 成功] 共 " + keys.size() + " 個物件");
                    return ProtectedListResult.success(keys);
                })
                .exceptionally(throwable -> {
                    Throwable cause = throwable.getCause() != null ? throwable.getCause() : throwable;

                    if (cause instanceof io.github.resilience4j.circuitbreaker.CallNotPermittedException) {
                        System.err.println("[" + Thread.currentThread().getName()
                                + "] ⚡ [斷路器跳閘] " + cause.getMessage());
                        String msg = "⚡ [系統自動降級] AWS S3 服務暫時不可用,斷路器已啟動保護。請稍後再試。";
                        return ProtectedListResult.circuitBreakerOpen(msg);
                    }

                    System.err.println("[" + Thread.currentThread().getName()
                            + "] ❌ [LIST 失敗] " + cause.getMessage());
                    return ProtectedListResult.failed();
                });
    }
加入屬於list的背壓限制,並且新增一個/async/files/protected的有保護的list api
/**
 * List 是無副作用的讀取操作,不需要 Semaphore 限流。
 * 依賴斷路器在 S3 持續失敗時快速降級,回傳 503;
 * 一般列舉失敗回傳 500。
 */
@GetMapping("/async/files/protected")
public CompletableFuture<ResponseEntity<?>> listFilesAsyncProtected() {
    return s3Service.listFilesAsyncProtected(bucketName)
        .thenApply(result -> {
            if (result.fallbackMessage() != null && !result.fallbackMessage().isBlank()) {
                return ResponseEntity.status(org.springframework.http.HttpStatus.SERVICE_UNAVAILABLE)
                    .<Object>body(result.fallbackMessage());
            }
            if (!result.success()) {
                return ResponseEntity.internalServerError()
                    .<Object>body("List failed; please retry later");
            }
            return ResponseEntity.ok().<Object>body(result.keys());
        });
    }
進入resources/application.yml檔案中,在s3底下加入list參數設定,以及在resilience4j底下和s3PutCircuitBreaker同一層的地方加入s3ListCircuitBreaker相關的設定檔
resilience4j:
  circuitbreaker:
    instances:
      s3PutCircuitBreaker:
        ....
      s3ListCircuitBreaker:
        slidingWindowType: COUNT_BASED
        slidingWindowSize: 20
        minimumNumberOfCalls: 10
        failureRateThreshold: 50
        slowCallRateThreshold: 80
        slowCallDurationThreshold: 15s
        waitDurationInOpenState: 15s
        permittedNumberOfCallsInHalfOpenState: 3
        automaticTransitionFromOpenToHalfOpenEnabled: true
        recordExceptions:
          - software.amazon.awssdk.core.exception.SdkException
          - java.util.concurrent.TimeoutException
          - java.lang.RuntimeException
        ignoreExceptions:
          - java.lang.IllegalArgumentException
          - java.lang.NullPointerException
我們只要複製原本的非同步的list api,然後將url最後加入protected即可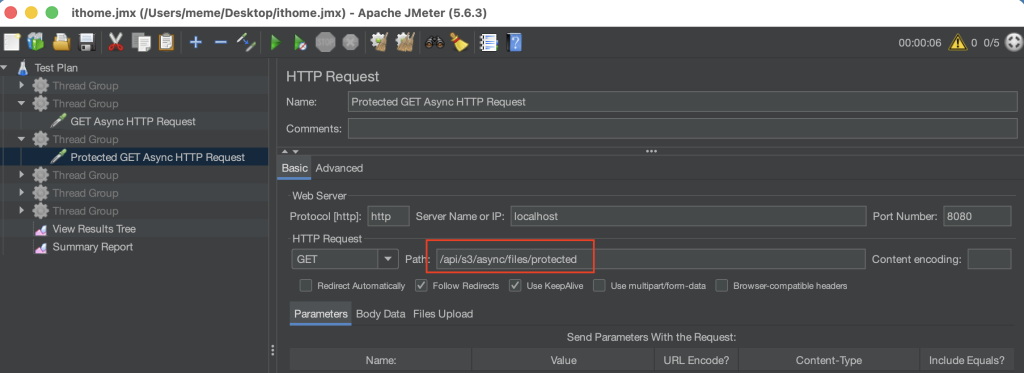
我們實驗考慮兩種狀況 :
我們在容器環境下(1.5 核 CPU / 512MB RAM / Timeout 15s),針對 listObjects 進行不同併發與 2s 混沌延遲下的實彈測試:
| 測試情境 | API 類型 | 總請求數 (#Samples) | 平均延遲 (Avg) | 最大延遲 (Max) | 標準差 (Std. Dev.) | 錯誤率 (Error %) | 吞吐量 (Throughput) |
|---|---|---|---|---|---|---|---|
| 正常無延遲環境 | 無保護 vs 有保護 | 500 次 | ~200ms | ~500ms | 極小 | 0.00% vs 0.00% | ~50.0/sec |
| 混沌延遲 2s (併發 100, 重複 5 次) | 無保護 (裸奔) | 500 次 | 3,845 ms | 15,017 ms | 2,825 ms | 1.00% | 15.8/sec |
| 混沌延遲 2s (併發 100, 重複 5 次) | 保護型 API | 500 次 | 3,780 ms | 15,014 ms | 2,760 ms | 0.40% | 15.5/sec |
| 混沌延遲 2s (併發 200, 重複 5 次) | 無保護 (裸奔) | 1000 次 | 6,162 ms | 15,020 ms | 2,420 ms | 2.00% | 23.3/sec |
| 混沌延遲 2s (併發 200, 重複 5 次) | 保護型 API | 1000 次 | 5,051 ms | 9,579 ms | 966 ms | 0.00% | 31.2/sec |
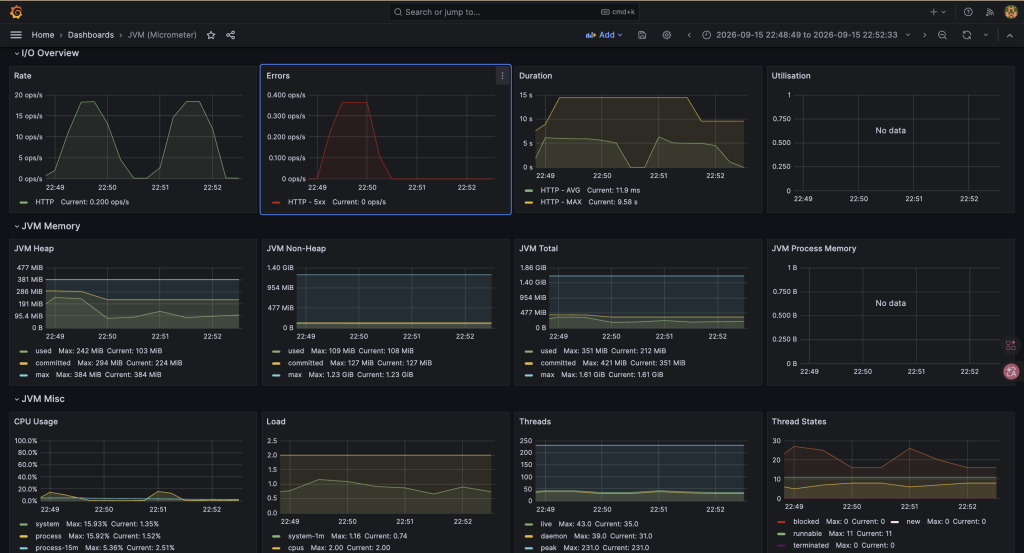
這張圖紀錄延遲兩秒的狀況下,並發200重複五次,第一個高峰是沒有保護的狀況,第二個高峰則是有保護api列出資料的狀況:
雖然本系列受限於篇幅不直接撰寫快取程式碼,但理解快取的架構定位是不可或缺的知識:
Caffeine / Guava Cache / Spring @Cacheable
200ms 直接降至 0.1ms(納秒級),吞吞量瞬間翻倍!Redis / Memcached
經過這幾天的極限壓測與混沌實驗,我們歸納出了雲端原生微服務最核心的八字真言:寫入靠背壓 (Backpressure),讀取靠快取 (Cache)!
PUT 上傳重型寫入:使用 Semaphore 控流 + Resilience4j 斷路器 + HEAD 探針自癒,鎖死硬體邊界,確保不產生髒資料。List 查詢重型讀取:使用 Cache 吸收 99% 的重複流量,避免防禦機制過度干擾讀取體驗。明天先將專案放一邊,一起來思考一下不同的程式語言間會有哪些效能上或底層架構上的差異呢?了解為什麼非同步不是萬靈丹?非同步處理方式也能適用在node.js或python這些高階程式語言上嗎?


 iThome鐵人賽
 看影片追技術