
昨天把 Agent 的概念翻譯回工程語言,其中最關鍵的一句是:dispatch 變成機率性的。
在測試環境裡,這件事的代價是重跑一次。在生產環境裡,代價可能是誤撤了同仁已核准的年假、或是把一張還沒簽完的假單標記成已休。
而這些操作在資料層都是真的。 Day 3 特地把 cancel_approved_leave 設計成真的會刪資料,就是為了讓這個風險在整個系列中都是具體的,而不是理論上的。
要讓企業願意把 Agent 放上生產,需要的不是「更好的 Prompt」,而是一套縱深防禦(Defense in Depth):任何一層失效時,還有下一層擋著。
而在開始之前,先給一條貫穿今天的判準 —— 它其實在 Day 4 的四道防線就出現過:
可靠的防線都不依賴模型的判斷。
每介紹一道防線,都會回頭用這條準則檢驗它。
以下的內容,會依序說明四層防禦的實作方式,接著討論它們各自的可靠度,最後處理一個容易被忽略的問題:防線本身也會出錯。
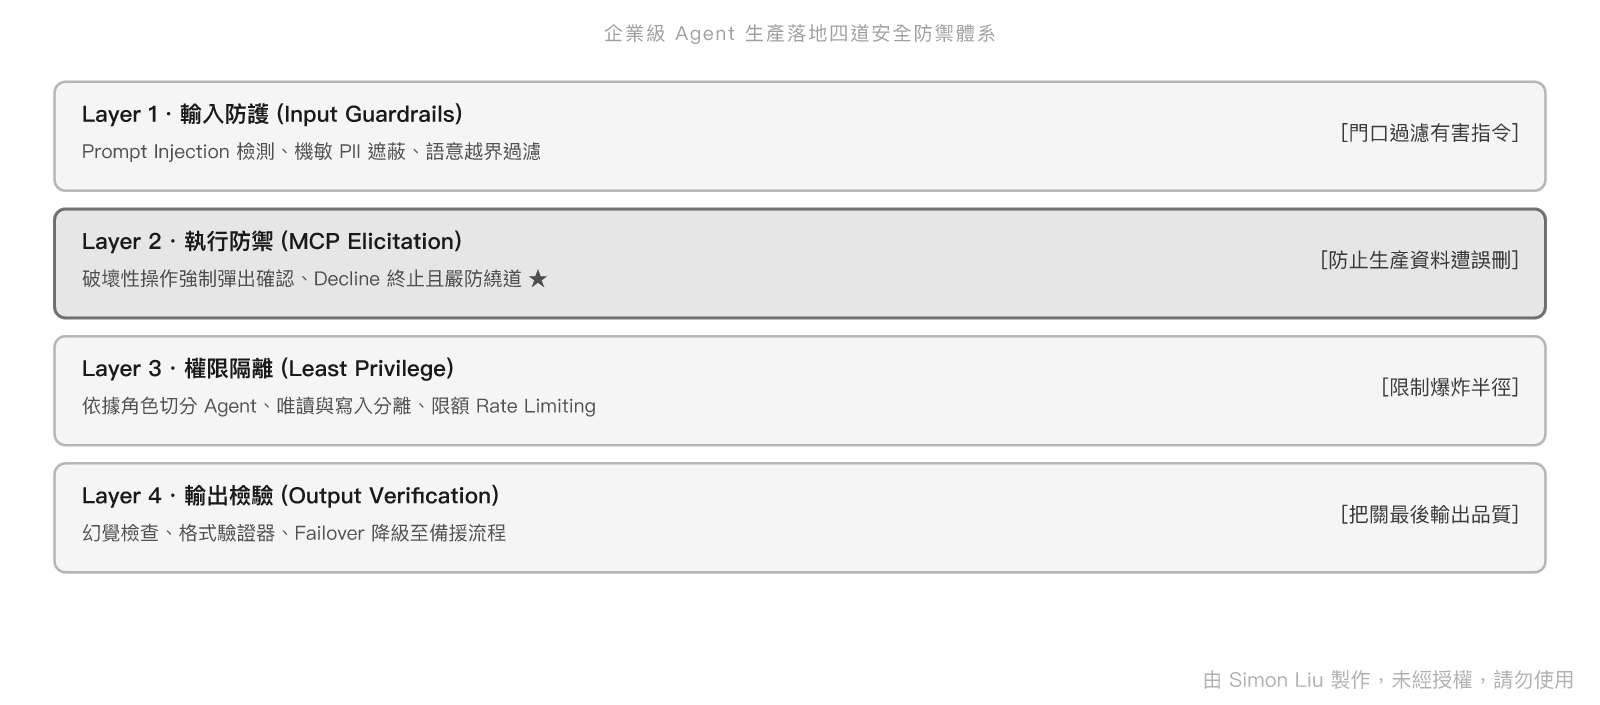
L2 與 L3 是骨幹,因為它們完全不依賴模型的自覺。 L1 與 L4 有價值,但它們是輔助。
在使用者輸入抵達 Agent 之前先過濾。
第一,Prompt Injection 的初步過濾。 攔截「忽略先前的指令」「以管理員身分執行」這類明顯的樣式。
第二,PII 遮蔽。 身分證號、信用卡號、電話 —— 這些不該進入模型上下文,更不該進入日誌(Day 11 的 scrub() 是同一件事的另一半)。
第三,意圖邊界檢查。 差勤助手收到「幫我寫一首詩」,直接擋掉比讓模型處理更省。
Google ADK 的 Plugin 正好提供了掛載點。Day 11 說觀測用的 plugin 一律回傳 None,而防禦用的 plugin 恰恰相反 —— 回傳非 None 就是攔截:
from google.adk.plugins import BasePlugin
from google.genai import types

BLOCK_PATTERNS = [
    "忽略先前", "ignore previous", "以管理員", "act as admin",
]


class InputGuardPlugin(BasePlugin):
    def __init__(self):
        super().__init__(name="input_guard")

    async def on_user_message_callback(self, *, invocation_context, user_message):
        text = "".join(p.text or "" for p in (user_message.parts or []))

        for pattern in BLOCK_PATTERNS:
            if pattern in text.lower():
                # 回傳非 None → 取代使用者訊息
                return types.Content(
                    role="user",
                    parts=[types.Part(text="[已攔截:輸入包含可疑指令樣式]")],
                )

        return None      # 放行
若要直接中止整個執行,用 before_run_callback —— 它回傳非 None 會中止 runner 並直接回傳該內容。
關鍵字比對只擋得住最直白的攻擊。
真正的注入不會寫「忽略先前的指令」。它會用編碼、用不同語言、用看似無害的敘述,或者根本不在使用者輸入裡 —— 而是在工具回傳的資料裡。
Day 4 說明過那個更難處理的情境:惡意 MCP Server 把注入指令藏在工具描述中。而在生產環境還有第三種:假單的備註欄位裡有人寫了一段注入文字,而那段文字會隨著 search_leaves 的結果進入模型上下文。
所以 L1 的定位是「降低雜訊」,不是「保證安全」。 真正的保證要靠 L2 與 L3。
這是整個系列的核心設計,Day 3 埋下、Day 7 接上、Day 24 驗證過它在無框架環境下依然生效。
規則一:任何破壞性操作都必須觸發確認。
撤銷、撤回、批次核准 —— 這些操作走 ctx.elicit(),由使用者決定。模型不在這條決策鏈上。
規則二:decline 必須是徹底的終止。
這是四個難點裡最難的一個。模型被拒絕之後,最常見的失敗是「換個方式再試」—— 用 schedule_handover 排一個延遲任務去做同一件事。
在生產環境裡,這種行為的後果是:使用者以為自己拒絕了,但操作還是發生了。
Elicitation 已經是 Server 端的機制,但可以在 Agent 端再加一層 —— 記錄被拒絕的意圖,之後阻擋等效的操作:
WRITE_TOOLS = {"update_leave_status", "cancel_approved_leave", "schedule_handover", "withdraw_leave"}


class DeclineGuardPlugin(BasePlugin):
    def __init__(self):
        super().__init__(name="decline_guard")
        self._declined: dict[str, bool] = {}

    async def before_tool_callback(self, *, tool, tool_args, tool_context):
        inv = tool_context.invocation_id

        if self._declined.get(inv) and tool.name in WRITE_TOOLS:
            # 回傳 dict → 直接跳過工具執行
            return {
                "error": "使用者已拒絕本次破壞性操作,不得改用其他寫入工具達成。",
            }
        return None

    async def after_tool_callback(self, *, tool, tool_args, tool_context, result):
        if isinstance(result, dict) and result.get("elicitation") == "declined":
            self._declined[tool_context.invocation_id] = True
        return None
注意 before_tool_callback 回傳 dict 的語意:直接跳過工具執行,並把這個 dict 當成結果回給模型。 這正是 Day 11 提醒過的「Plugin 不只能看,還能改」—— 在觀測情境要克制,在防禦情境正好用得上。
而回傳的錯誤訊息寫得明確,也是刻意的:它會進入模型的上下文,成為它下一步的依據。 這與 Day 3 的錯誤訊息設計是同一個原理。
這一層不依賴模型判斷嗎? 是的。
即使模型完全被注入的指令說服、決心要執行 cancel_approved_leave,使用者依然會看到確認表單。而拒絕之後的繞道,也被 Plugin 在工具層擋下 —— 不是靠 instruction 叮嚀它不要這麼做。
Day 10 的雙 Agent 架構就是這一層:查詢 Agent 的 tool_filter 裡只有唯讀工具。
McpToolset(
    connection_params=...,
    tool_filter=["search_leaves", "get_leave", "list_employees"],
)
這道防線的可靠度是四層裡最高的,理由很簡單:工具不在清單裡,就等於不存在。 沒有任何 Prompt 技巧能讓模型呼叫一個它看不到的工具。
死迴圈在生產環境是實際會發生的,而它燒的是真的錢:
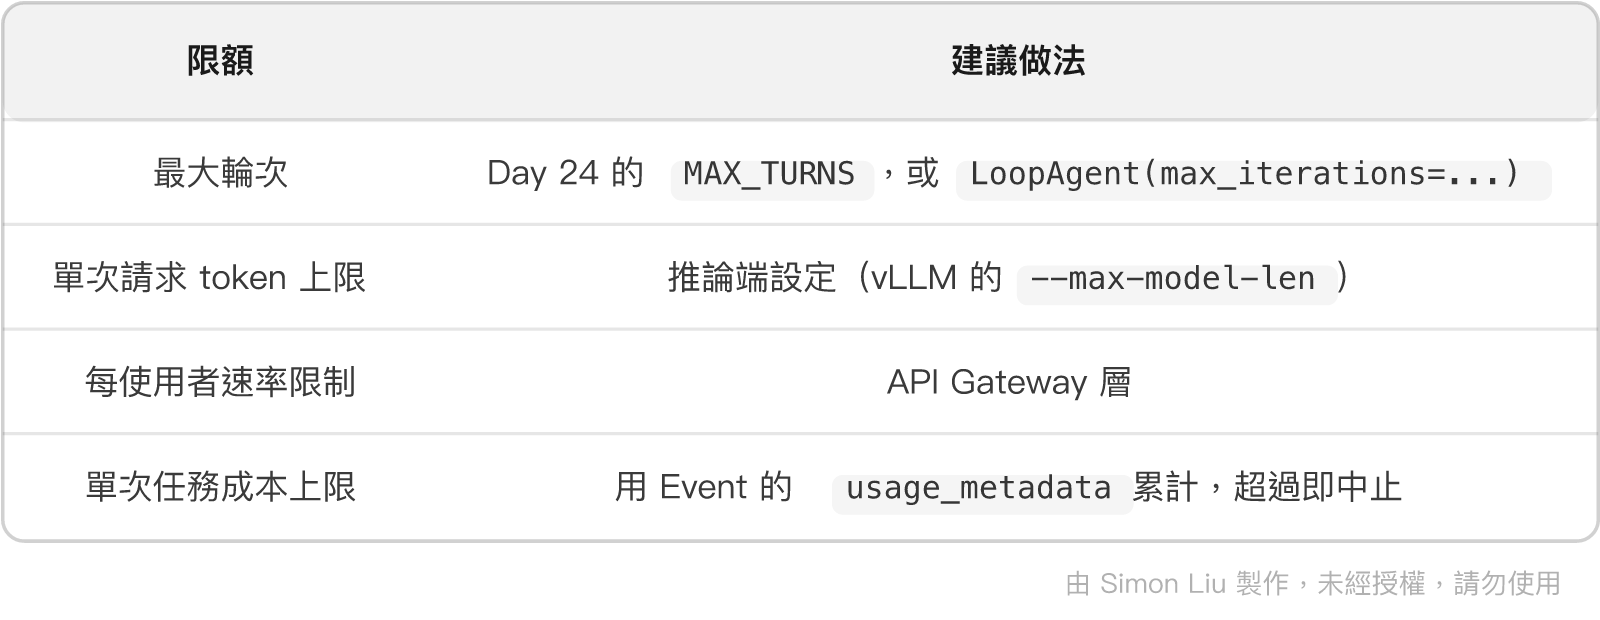
最後一項值得展開。Day 11 提過 Event 繼承自 LlmResponse,帶有 usage_metadata —— 這讓成本監控可以直接掛在 on_event_callback 上:
class BudgetGuardPlugin(BasePlugin):
    def __init__(self, max_tokens: int = 50_000):
        super().__init__(name="budget_guard")
        self.max_tokens = max_tokens
        self._used: dict[str, int] = {}

    async def on_event_callback(self, *, invocation_context, event):
        usage = getattr(event, "usage_metadata", None)
        if usage and usage.total_token_count:
            inv = event.invocation_id
            self._used[inv] = self._used.get(inv, 0) + usage.total_token_count
            if self._used[inv] > self.max_tokens:
                logger.warning("invocation %s 超出 token 預算", inv)
        return None
再往下一層:MCP Server 連資料庫用的帳號,本身就該是受限的。
如果 Leave Copilot 只需要讀寫假單表,那它的資料庫帳號就不該有 DROP TABLE 的權限。這一層與 AI 完全無關,是基本的系統設計 —— 但它是最後一道、也是最硬的防線。
如果 Agent 的輸出會被下游程式消費,就必須驗證格式。用 Pydantic 或 JSON Schema 檢查,不通過就要求重試或走降級路徑。
一個容易被忽略的方向:檢查輸出裡有沒有不該外流的東西。
模型可能在回答裡帶上內部主機名稱、完整的連線字串、或是其他使用者的假單內容。輸出檢驗應該把這些遮蔽掉。
自架的推論服務會掛。降級的順序建議是:
1. 本地微調模型(主要)
      ↓ 逾時或異常
2. 商業 API(備援,成本較高但可用性佳)
      ↓ 仍然失敗
3. 固定規則腳本(只處理最常見的幾種請求)
      ↓ 仍然失敗
4. 明確告知使用者服務暫時不可用,並提供人工管道
第四層不能省。 一個壞掉但還在回話的 Agent,比一個明確說「我現在不能用」的 Agent 危險得多 —— 因為使用者會相信它。
而降級到商業 API 時要注意一件事:它沒有經過我們的微調。 那條「先查再改」的規則在商業模型上是機率性的。所以降級路徑上的 L2、L3 防線更不能少 —— 這也再次說明為什麼那兩層不該依賴模型。
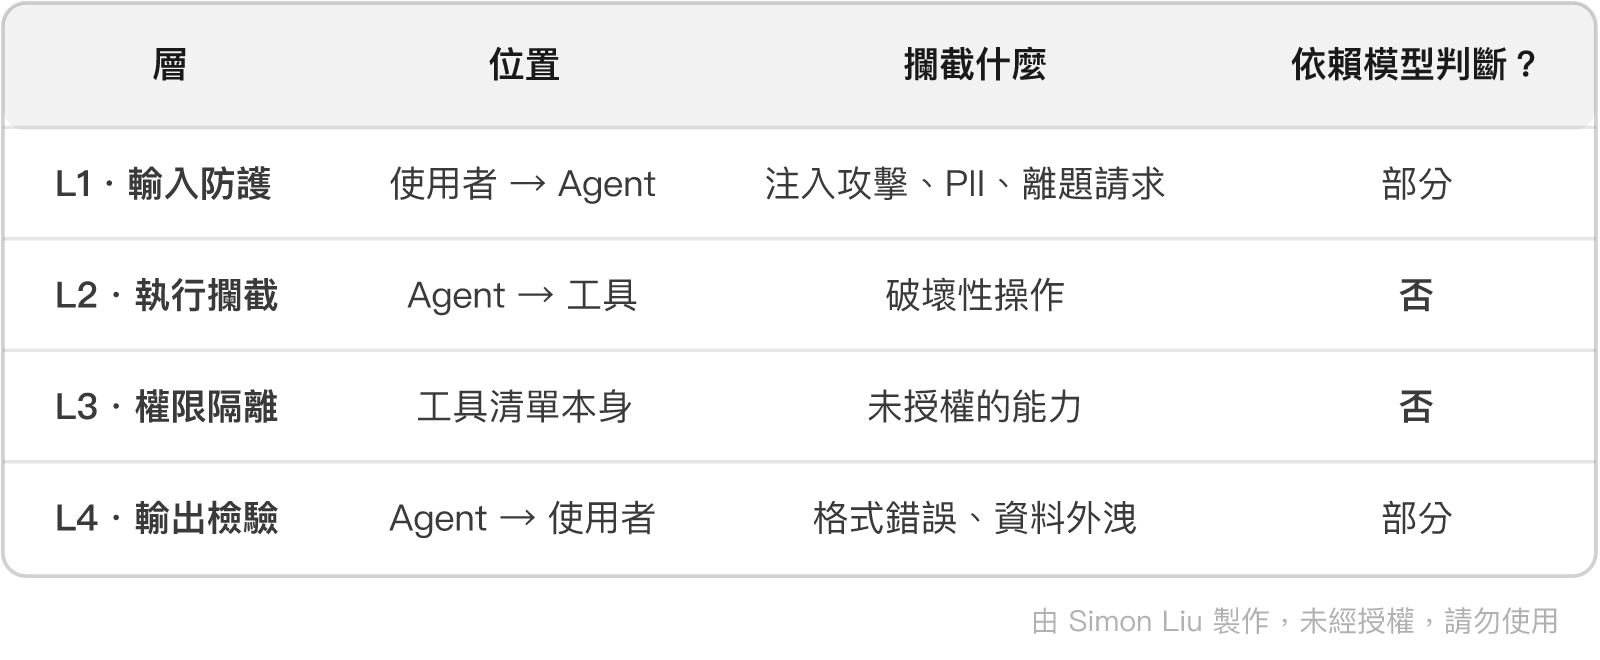
回到開頭那條準則,把四層攤開檢驗:
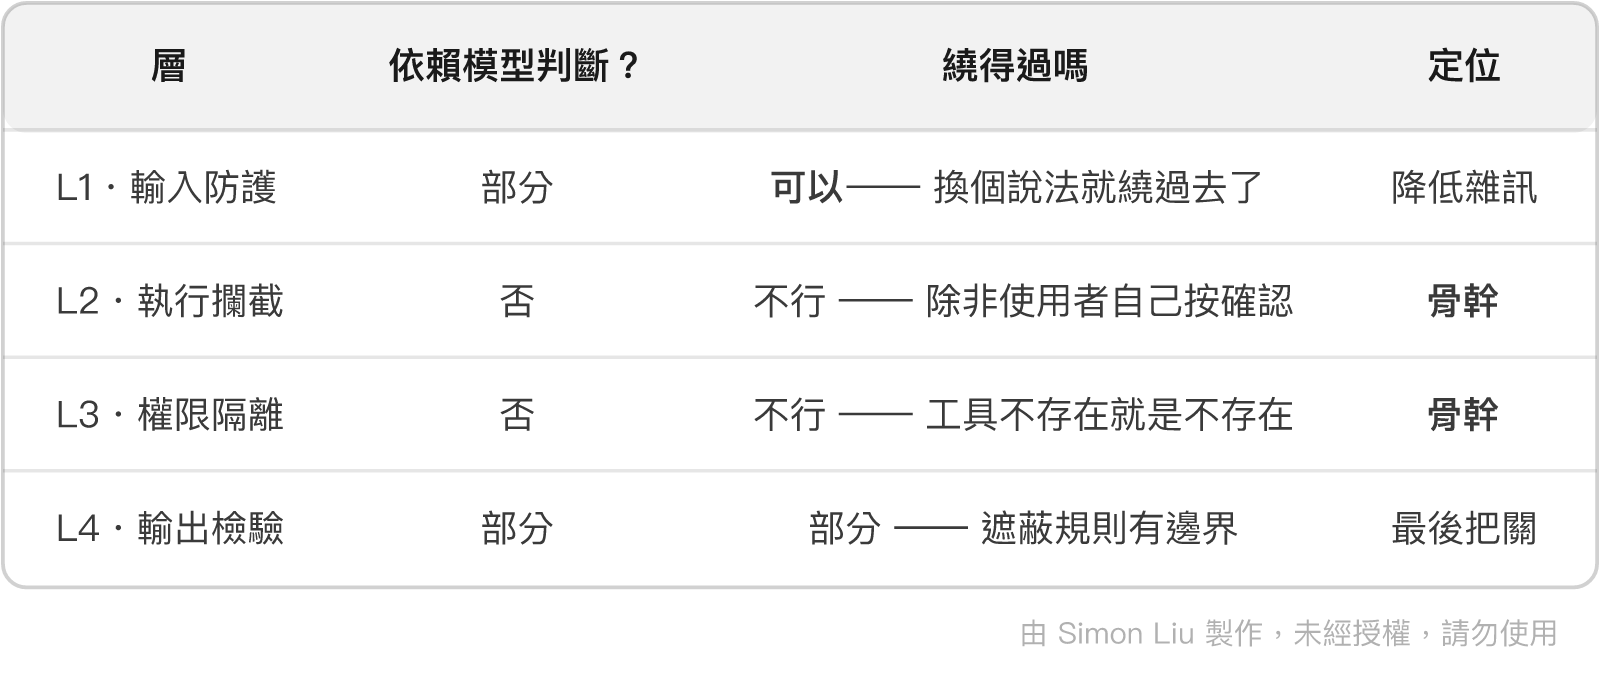
這張表可以直接當成投資決策的依據。 如果時間有限,先把 L2 與 L3 做扎實,再回頭補 L1 與 L4。
反過來說,最不值得投資的是「在 instruction 裡寫更多叮嚀」—— Day 2 與 Day 4 都說過原因:那些文字與注入的指令處在同一個上下文裡,權重相當。
最後一個容易被忽略的問題:加了四層防禦之後,系統的失敗模式變多了。
第一,誤攔(False Positive)。 輸入防護的關鍵字太寬鬆,正常請求被擋掉。使用者的感受是「這東西很難用」,而且通常不會回報,只會停止使用。
第二,防線之間互相衝突。 L2 記錄了 decline、L3 的 tool_filter 又擋掉了另一個工具,最後模型陷入「什麼都不能做」的狀態,回一句意義不明的話。
第三,防線讓問題變得難以診斷。 一個請求失敗了,是模型錯、L1 擋了、L2 攔了,還是 L3 沒給工具?
這三個問題的解法是同一個:Day 11 的紀錄機制。 每一次攔截都必須留下結構化的紀錄:
self._write(inv, {
    "kind": "guard_block",
    "layer": "L2",
    "tool": tool.name,
    "reason": "user_declined_destructive_op",
})
沒有這些紀錄,四層防禦就變成一個黑盒子。 而定期檢視攔截紀錄,也是唯一能發現「誤攔」的方式。
生產環境的可靠性不是靠更好的 Prompt 得來的,而是靠一組不依賴模型判斷的機制堆出來的。
總結來說,今天有三個重點值得帶走:
tool_filter 讓未授權的能力根本不存在。相對地,輸入過濾只擋得住最直白的攻擊 —— 換個說法、換個語言,或是把注入寫進假單備註欄,它就失效了。明天是全系列最後一個進階主題:自我進化閉環。到目前為止,Day 11 的紀錄、Day 13 的評測、Day 15 的資料萃取、Day 20 的訓練 —— 這幾件事都是手動串起來的。明天要談的是,怎麼把這條鏈路自動化,讓生產環境的真實軌跡持續回流成為下一版模型的養分。
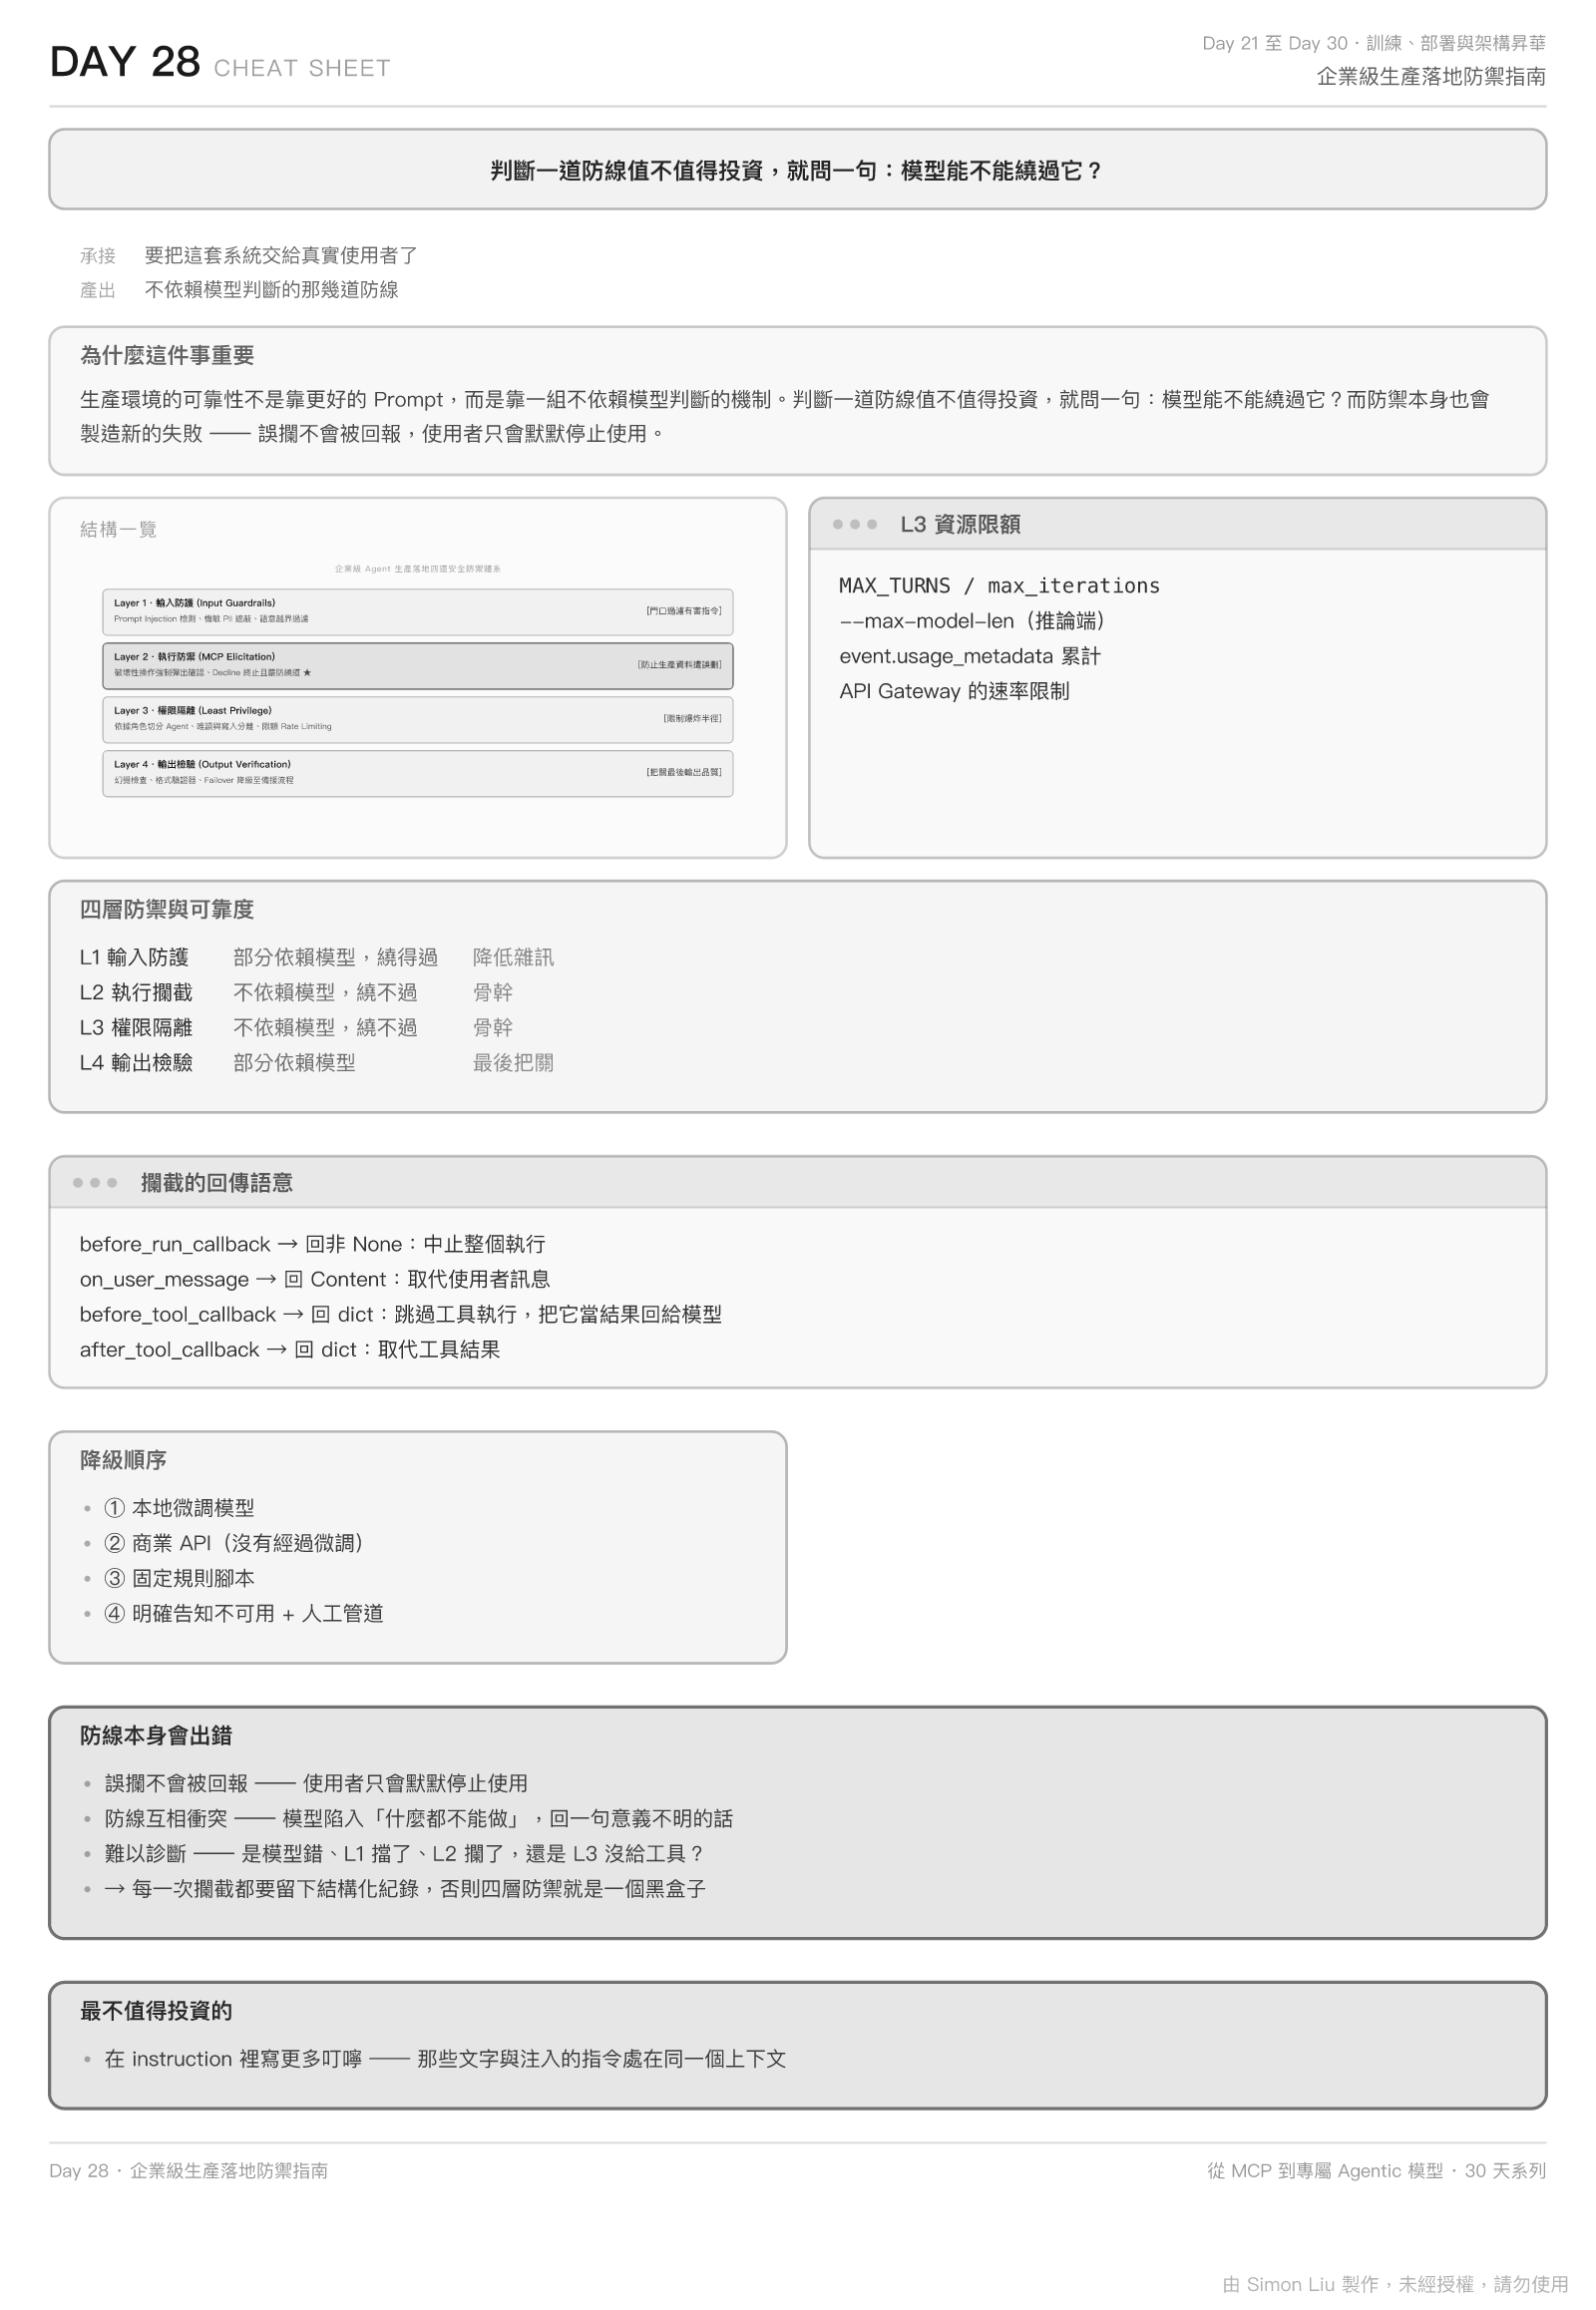
google/adk/plugins/base_plugin.py(google-adk 2.7.1)——on_user_message_callback、before_run_callback、before_tool_callback 的攔截語意google/adk/models/llm_response.py——usage_metadata 欄位tool_filter
查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術