
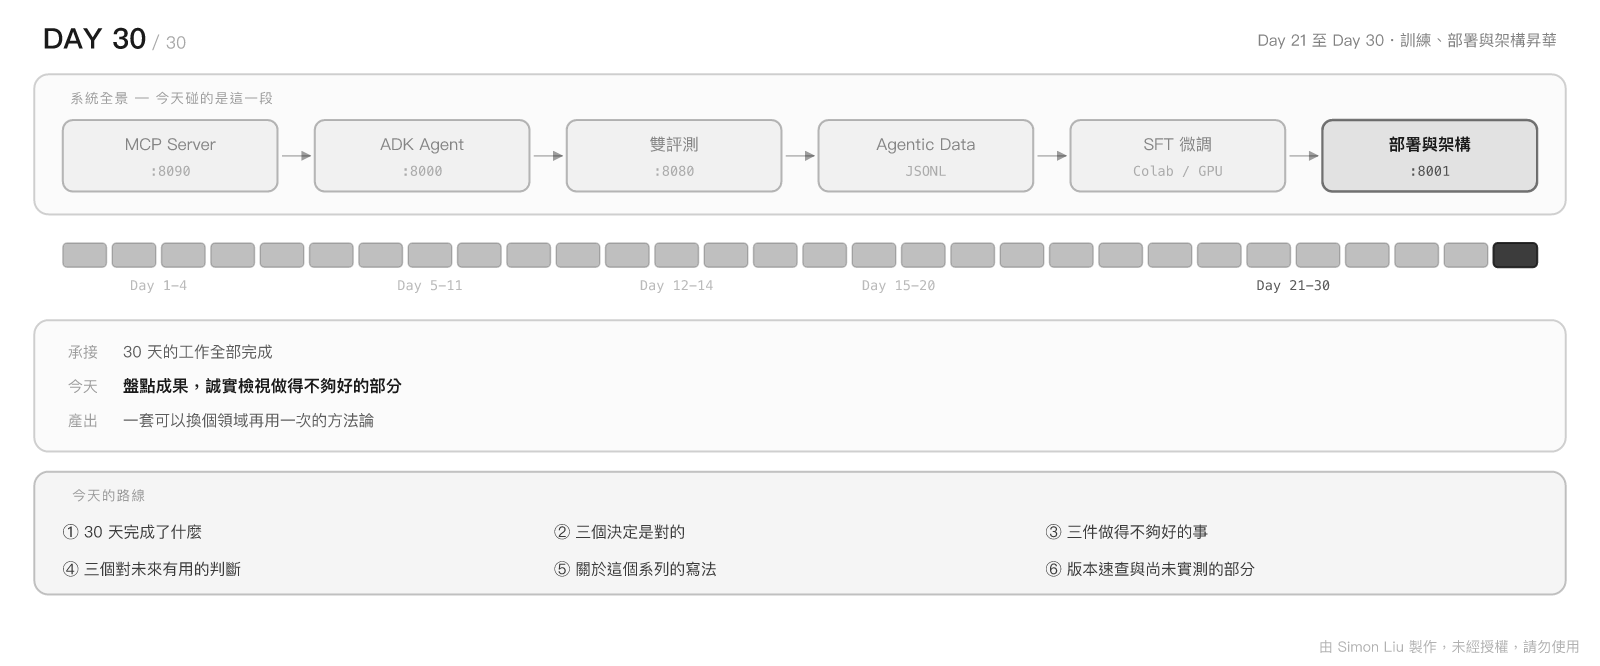
30 天前,第一篇文章寫下的目標是:
打造一個原生擅長操作特定工具的專屬 AI 模型,並且用數據證明它比通用模型強。
不是「介紹 MCP」,不是「教您寫 Agent」—— 那些只是路上的站點。真正的終點是 Day 23:同一組測試案例、同一把尺,量出微調前後的差距。
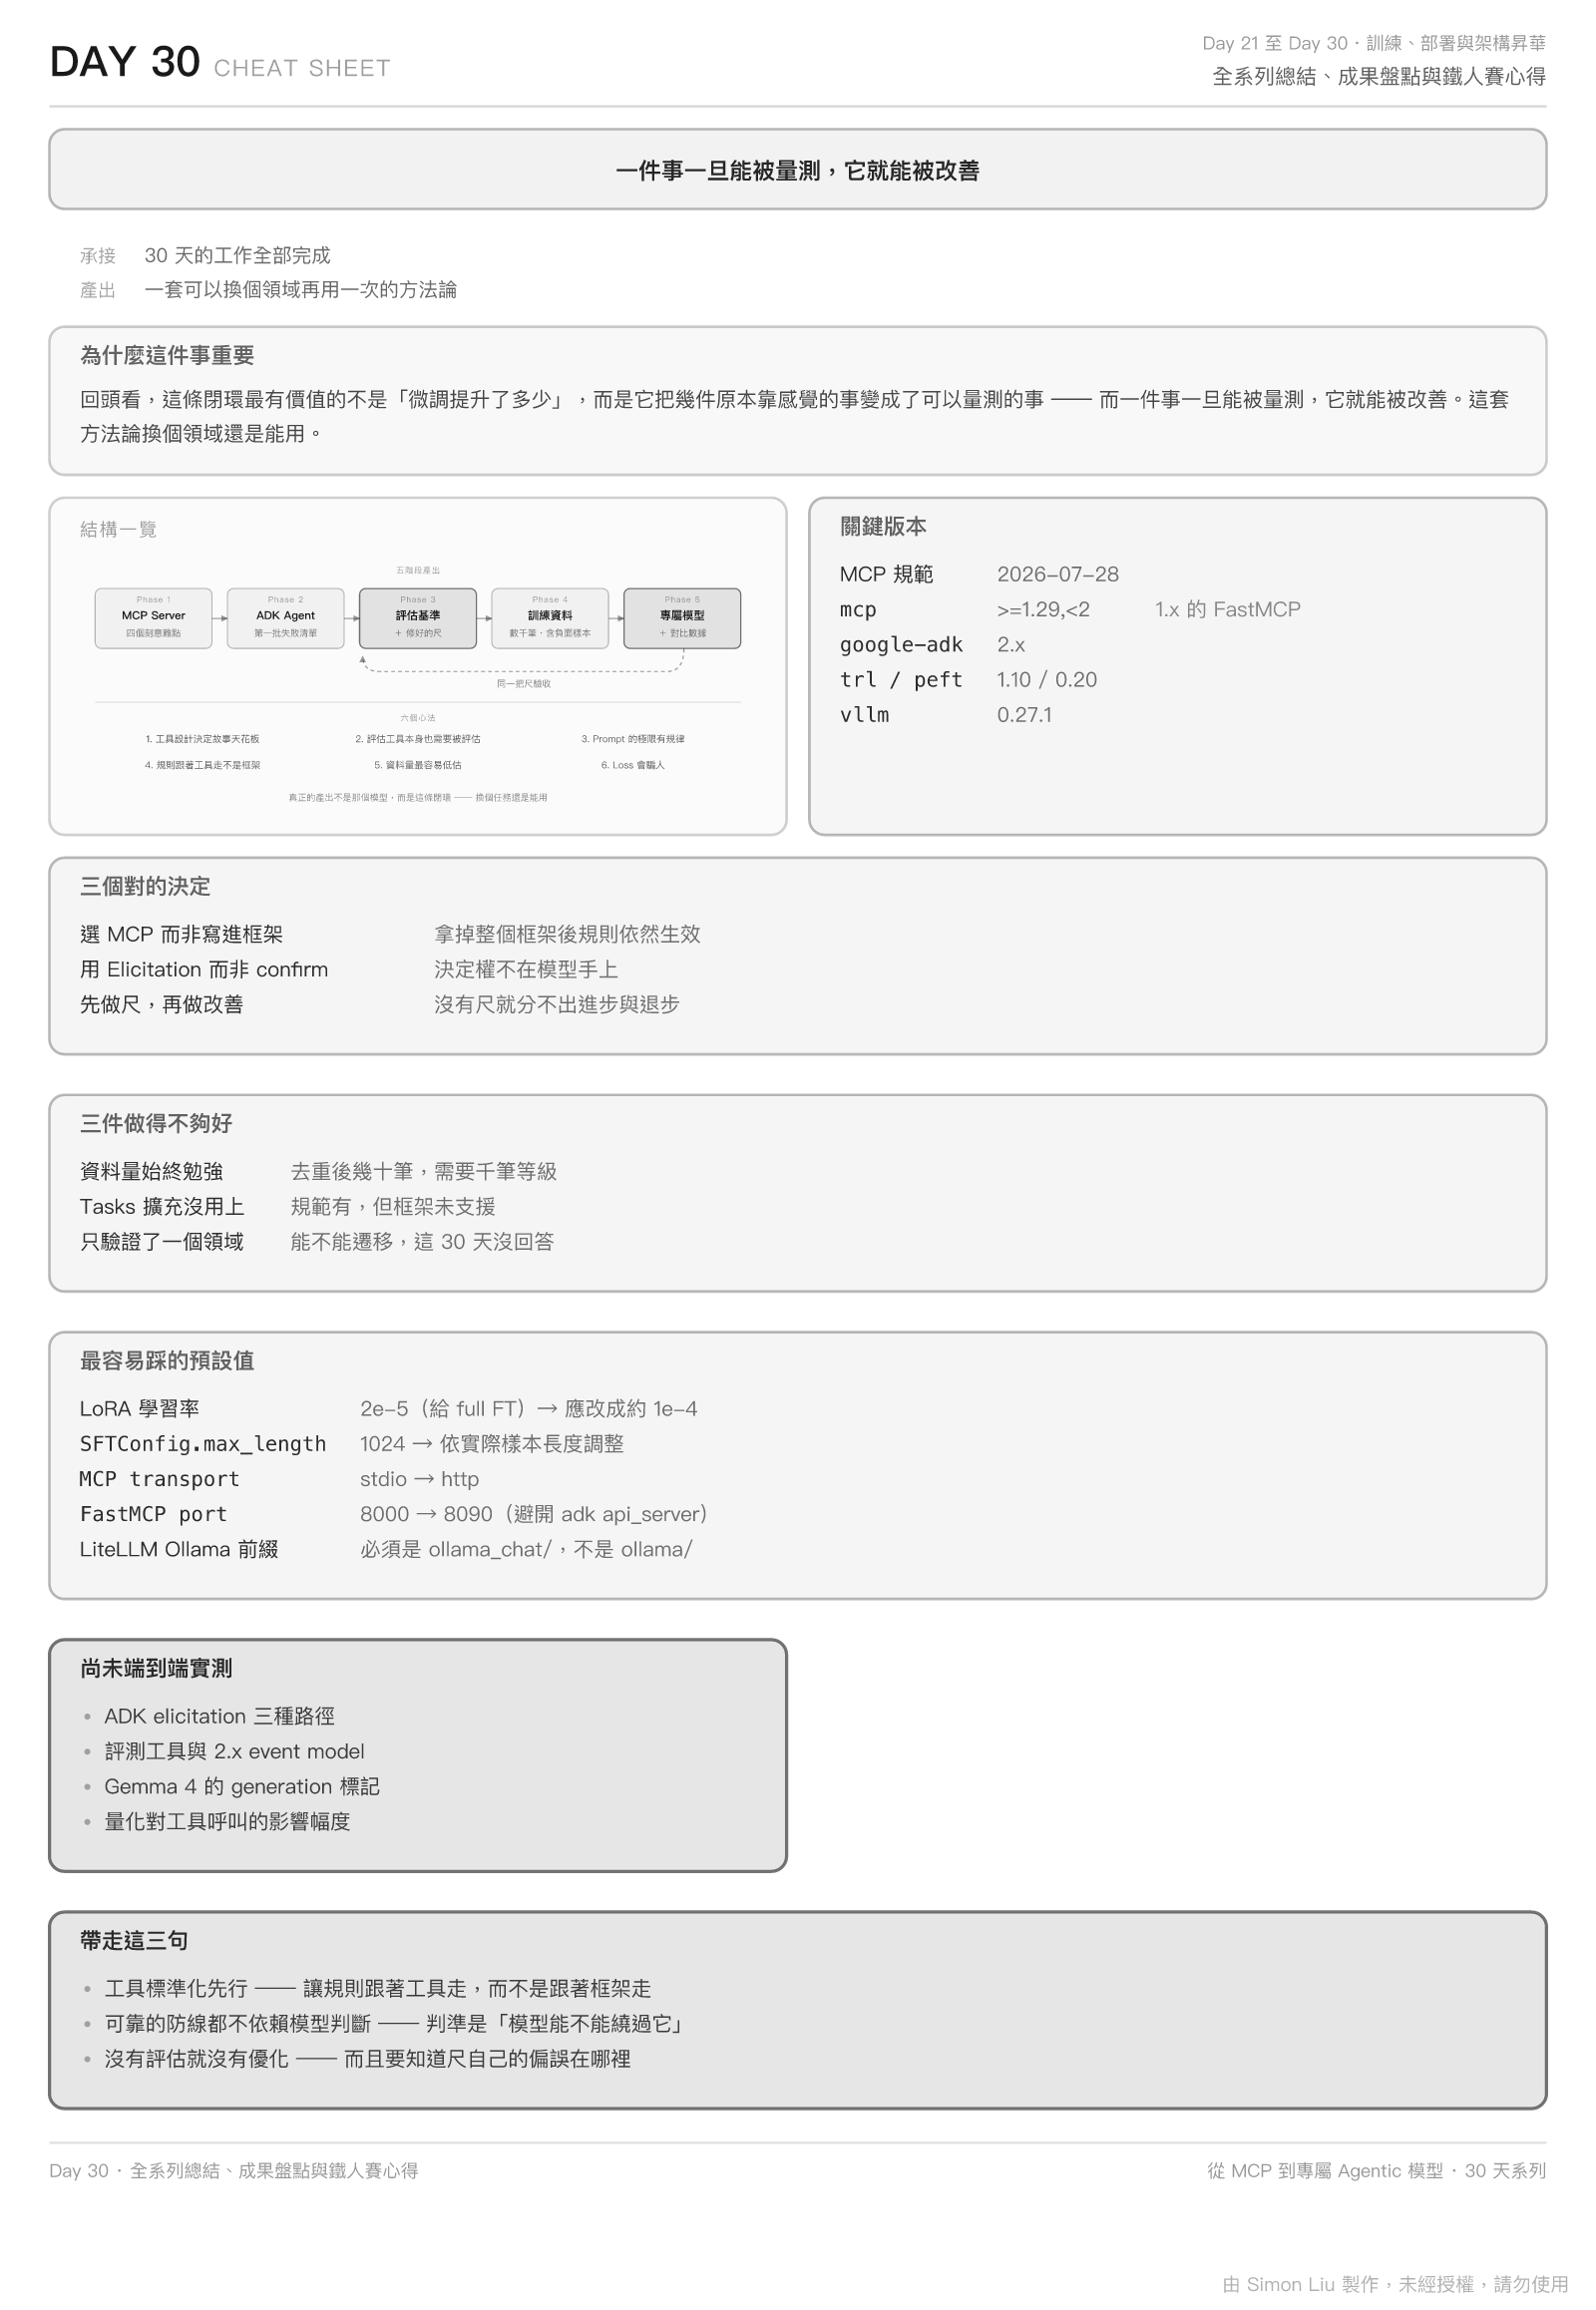
今天要做三件事:盤點這條閉環實際完成了什麼、誠實檢視哪些地方做得不夠好,以及留下幾個對未來有用的判斷。
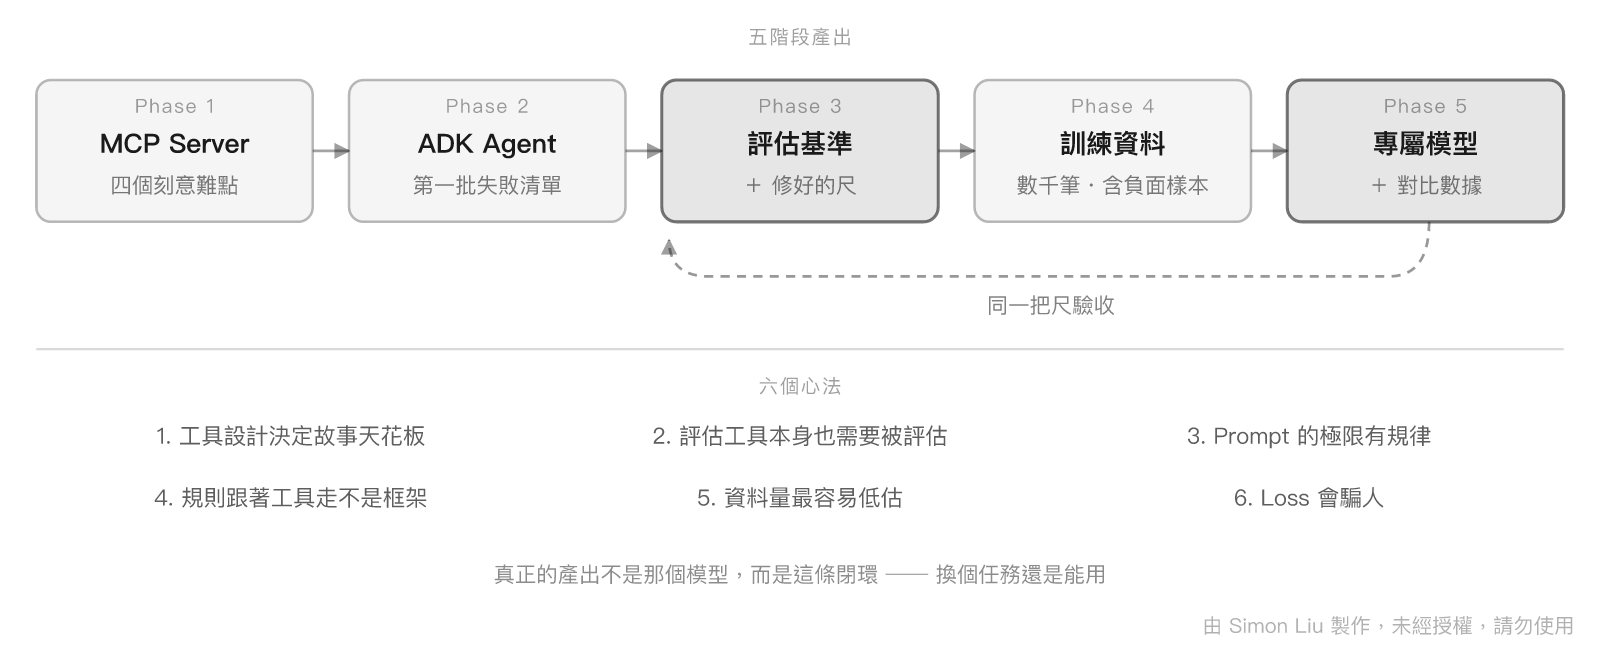
Day 1 至 Day 4・Agent 概念與 MCP 基礎
建立了 Agent 的心智模型與 MCP 的架構認識,然後用 FastMCP 實作了一個包含九個工具的 Leave Copilot MCP Server —— 並在裡面刻意植入了四個難點。
那四個難點是整個系列成立的前提。如果示範工具是「查天氣」那種等級,基座模型本來就叫得對,Day 23 就展示不出任何提升。
Day 5 至 Day 11・打造 Google ADK Agent
從框架導覽做到 Multi-Agent 與 Tracing。這個階段真正的產出不是「一個能跑的 Agent」,而是一批結構化的失敗軌跡 —— 捏造 ID、狀態跳級、拒絕後繞道、日期格式錯誤。
Day 12 至 Day 14・品質評估體系
打造了兩把尺:ADEval 量自訂任務的軌跡正確性,Twinkle Eval 量標準 Benchmark 的通用能力。並且在 Day 13 發現了 ADEval 自己的盲點 —— 集合語意量不到順序 —— 然後動手把 ordered subset 補上。
Day 15 至 Day 20・資料集準備與微調準備
從 Event 日誌萃取軌跡,面對「去重後只剩幾十筆」的現實,用四種手法擴增,處理 loss mask、基座選型、Colab 工具鏈與訓練前檢查,最後跑完 SFT。
Day 21 至 Day 30・訓練、部署與架構昇華
踩坑、部署、三方對決驗收,然後把框架拆掉驗證架構決定,最後六天延伸到 Flow vs Agent、設計模式、概念對照、生產防禦與自我進化架構。
把它畫成一句話:
MCP 標準化工具 → Google ADK 打造 Agent → 雙評測量出不足
      ↑                                        ↓
   驗收成果 ←── 微調模型 ←── 從評測軌跡萃取訓練資料
注意那條回流的線。 評測不只是流程的終點,它同時是訓練資料的來源,也是驗證成果的尺 —— 這是整個系列的骨架。
這個決定在 Day 24 兌現。 把 Google ADK 整個拿掉、用八十行原生 Python 重寫之後,「必須先查詢才能更新」這條規則依然生效、Elicitation 依然運作。
因為規則從來就不住在框架裡 —— 它住在 MCP Server 的實作與模型的權重裡。
這件事的實際價值是:您保有選擇權。 換框架、換模型、換部署方式,工具那一層都不用動。
confirm 參數如果破壞性操作的確認是靠工具參數(confirm=True)或 dry_run 模式,那麼決定要不要確認的人就是模型。安全機制建立在被監管者的自覺上,在架構上是不成立的。
Elicitation 把這個決定權交還給使用者,而模型完全不在那條決策鏈上。
這也讓難點 ② 成為整個系列最有價值的一個測試項 —— 因為它量的不是「模型會不會用工具」,而是「模型會不會尊重使用者的拒絕」。
Day 12 至 Day 14 花了三天什麼功能都沒加,只在建立評測體系。當時最自然的衝動是「先改改 Instruction 應該就好了」。
但沒有尺,就無法判斷任何改動是進步還是退步。 而 Day 15 之後的整個微調計畫,都建立在「能量出差距」這個前提上。
更重要的是 Day 13 那個發現:評測工具自己的盲點,比模型的錯誤更危險。 我們差一點就用一把量不到順序的尺,去衡量一個本質是順序的問題。
寫技術系列最容易的事,是只寫成功的部分。這裡誠實列出幾個不足。
Day 15 就算清楚了:50 個案例 × 3 次 × 60% 通過率 × 2.5 筆 ≈ 225 筆,去重後只剩幾十筆。而讓模型穩定學會一組工具的慣例,經驗上需要千筆等級。
Day 16 用四種手法擴增到數千筆,但合成資料的多樣性終究不如真實資料。這是整個系列最大的技術妥協。
如果有機會重來,我會在 Day 5 至 Day 11 就投入更多時間累積真實軌跡 —— 讓 Agent 在更多樣的情境下跑更久,而不是急著進入評測階段。
2026-07-28 版規範定義的 Tasks 擴充,理論上非常適合 cancel_approved_leave 這類可能跑很久的操作。但它是這一版才獨立出來的機制,官方的 Extension 支援矩陣連追蹤欄位都還沒有 —— 整個生態系都還沒走到那裡,所以只能留作 Future Work。
這反映一個現實:規範定義了,不代表框架支援。 而這個落差在快速演進的領域裡是常態,不是例外。
整個系列繞著 Leave Copilot 這一組九個工具。「微調能讓模型學會工具慣例」這個結論,在這個領域成立 —— 但它能不能遷移到工具數量更多、語意更複雜的場景,這 30 天沒有回答。
Day 14 引入 BFCL 的部分算是一個間接的檢查(泛化的函式呼叫能力),但那不等於在另一個真實領域驗證過。
如果只能從這 30 天帶走三句話:
不要在個別 Prompt 裡修修補補。用 MCP 把工具介面與安全確認標準化,讓規則跟著工具走。
這件事的回報不是立即的,它在您換框架、換模型、或是要把同一組工具接到第二個應用時才會出現 —— 而那一刻它會省下大量的時間。
這句話在 Day 2、Day 4、Day 10、Day 26、Day 28 反覆出現,因為它是這個系列最核心的一條原則。
tool_filter、Elicitation、Server 端驗證之所以可靠,正是因為它們在模型的決策範圍之外。相對地,寫在 Instruction 裡的叮嚀會被 Prompt Injection 直接繞過 —— 因為兩者處在同一個上下文裡,權重相當。
判斷一道防線值不值得投資,就問一句:模型能不能繞過它?
微調之前必須先有客觀的尺,而且那把尺必須被凍結。
但更進一步的體會是:要知道尺自己的偏誤在哪裡。 ADEval 的七項指標各自有偏誤,Day 12 花了一整天說明它們 —— 知道自己正在看哪一個角度,比看到一個高分更有價值。
最後說一句寫作上的原則,因為它影響了整個系列的形狀:這個領域三個月就過時一輪,所以每一項技術細節都標了來源與查證日期。
一篇沒有標日期的技術文章,讀者無從判斷它還能不能用。而版本相容性的坑更是必須明講 —— 像是「這個套件要明確釘在哪個範圍」這種細節,照官網預設文件寫會直接踩雷,卻不會出現在任何教學文裡。
至於實驗數據,文章裡看到「待填」是刻意的。抄一組別人的數字很容易,但那對讀者沒有價值,對我自己也是。
下一節把這些散落在 30 天的版本資訊集中起來,方便日後核對。
這個系列涉及大量版本敏感的 API,而這個領域三個月就會過時一輪。把散在 30 天裡的版本資訊集中在這裡,方便日後回頭核對。
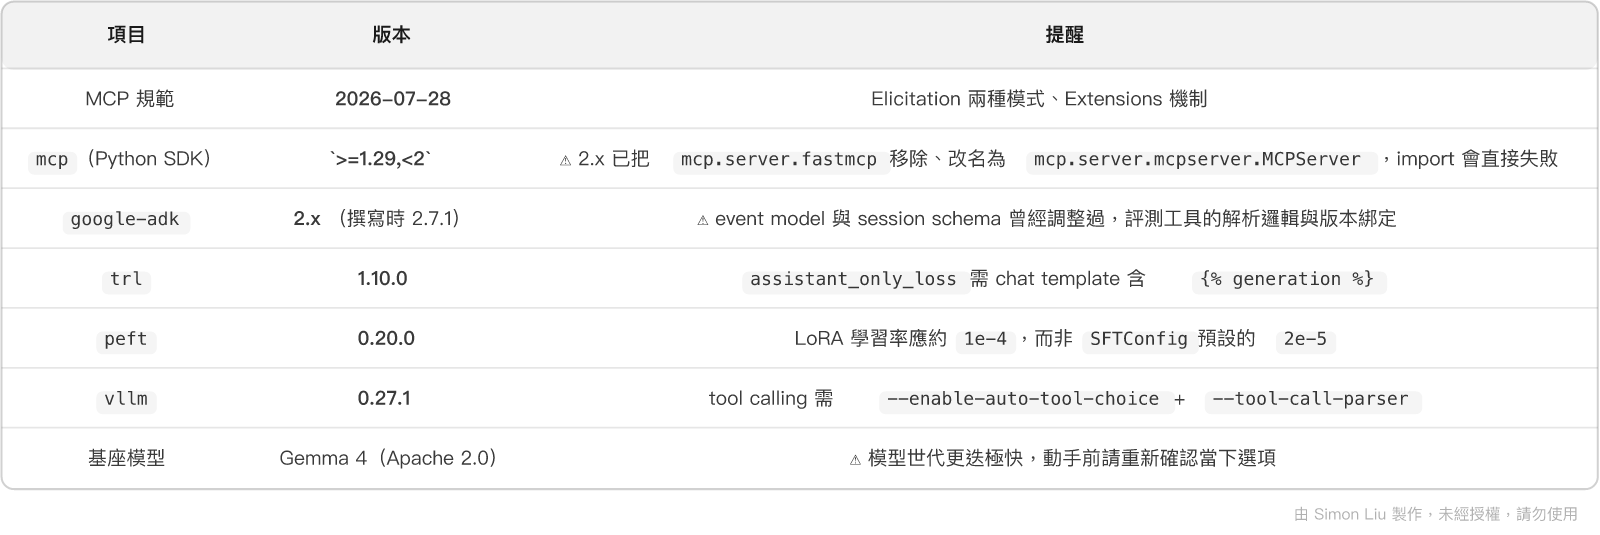
這幾項的共同特徵是:用預設值不會報錯,但結果會不對。
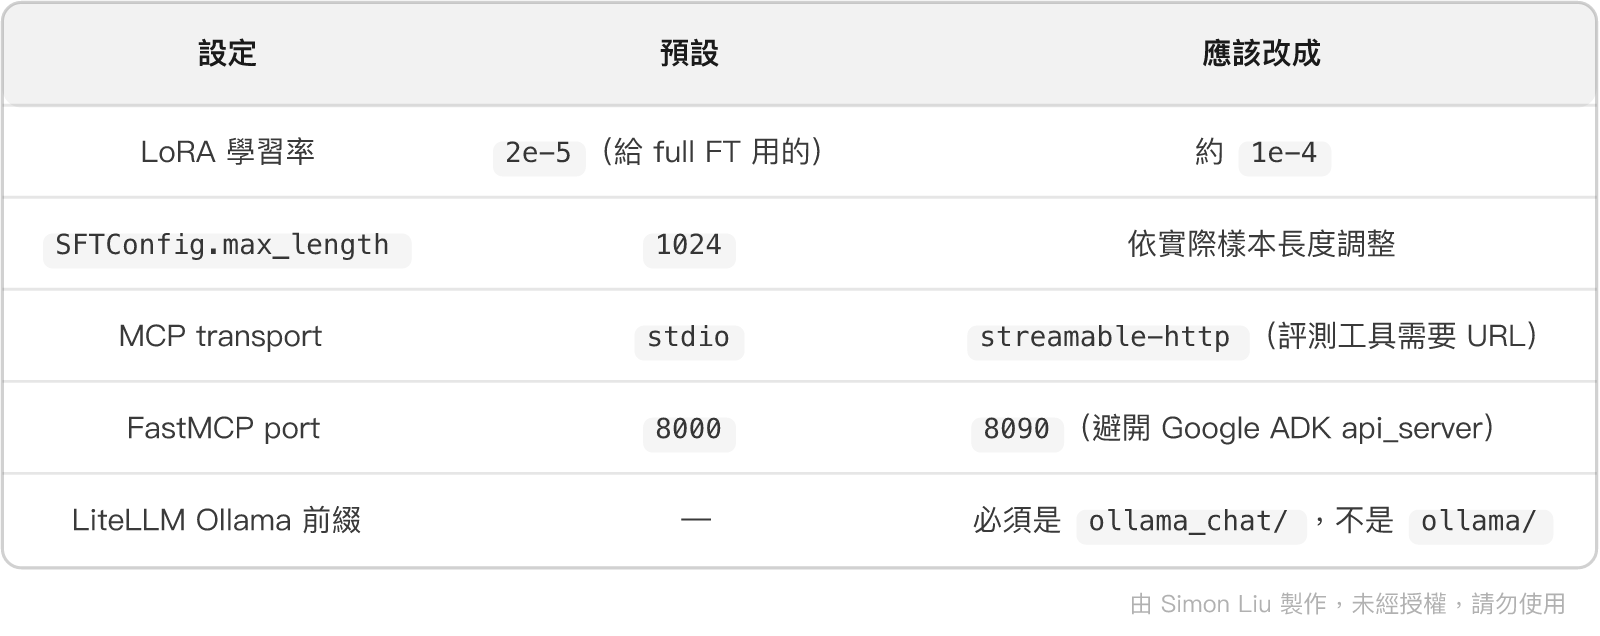
寫技術系列最容易的事,是把「文件上這樣寫」講成「我跑過了」。以下這幾項在撰寫時是基於文件與原始碼推論,實作時請優先自行驗證:
elicitation_callback 的完整行為 —— 原始碼確認有支援,但 accept/decline/cancel 三種路徑需要實跑{% generation %} 標記每篇文章末尾的「參考來源」都標了查證日期。 看到日期比您現在的時間早很多時,請務必重新確認 —— 特別是標了 ⚠ 的那幾項。
30 天前設定的目標是跑通一條閉環。現在回頭看,這條閉環最有價值的部分其實不是「微調讓分數提升了多少」,而是它把幾件原本靠感覺的事變成了可以量測的事:
而一件事一旦能被量測,它就能被改善。 這大概是這 30 天最實在的收穫。
至於這條路的下一步 —— Day 29 談的自我進化閉環是其中一個方向,但它需要的不只是自動化,還需要把人的判斷放在正確的位置上。那會是另一個 30 天的題目了。
感謝每一位讀到這裡的朋友。這個系列的所有程式碼、圖表與查證來源都會持續維護,如果您在實作過程中遇到問題,歡迎在 Linkedin 上找我討論。
祝各位在打造專屬 Agent 的路上,都能量出屬於自己的那條曲線。
各篇的技術來源與查證日期,標註在每一天文章末尾的「參考來源」段落。關鍵版本資訊彙整在本篇第 VII 節,環境建置與 port 規劃見 Day 1。
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術