
真實 Issue 很少把邊界條件、受影響檔案和測試方式寫齊。如果看完兩句話就開始改碼,速度也許快,漏掉的部分卻會在 Review 時加倍奉還。今天練習在動手前把一個 Issue 轉成有順序、能驗收的計畫。
Issue 寫的是:「編輯任務後,清單上的標題有時還是舊的,請修好。」這句話至少有四個未知:儲存是否真的成功、清單資料從哪裡來、是否有快取、錯誤時畫面怎麼回饋。若沒有先確認,就可能只在前端強制重新整理,把真正的寫入失敗藏起來。
給 ChatGPT 的指令是:「請只根據 Issue,列出你需要問的問題、可能受影響的資料流程、驗收案例與風險。沒有 Repository 時請明確標出假設。」給 Codex 的指令是:「只讀目前 Repository,找出編輯任務到清單更新的實際流程;列出可能修改的檔案、可重現問題的測試、風險與最小實作順序。暫不修改。」
兩份計畫不必長得一樣。ChatGPT 可能擅長提醒產品行為的缺口,Codex 應該能引用真實檔案與測試。我要比較的是:哪些假設有來源、哪些案例能實際執行、哪些風險會影響現有功能。對相互矛盾的地方,先回到程式和使用者需求查證,而不是用多數決。
最容易寫出來、也最沒用的計畫是「第一步分析,第二步實作,第三步測試」。真正能幫忙的計畫會指出停下來確認的地方:若資料庫已更新但畫面舊,優先查讀取與狀態同步;若資料庫沒有更新,先查請求與錯誤處理。兩條分支要改的地方不同,不能先承諾同一組檔案。
實作範圍也要有上限。若調查發現問題牽涉共用狀態管理,可能需要比預想更多的修改;這時先回報新的影響範圍,再調整計畫。把擴大範圍當成明確決策,而不是讓它悄悄出現在 diff 裡。這也是人類審核計畫的價值。
一份可執行計畫至少包含:問題如何重現、目前資料流、要改哪些位置、先寫哪個失敗案例、修改順序、驗收與回滾方式。對這個 Issue,合理順序是先確認舊標題出現的條件,再補能重現它的測試,接著修正資料更新或讀取,最後檢查編輯失敗與其他清單操作。順序可以隨證據改,但不能只寫「修好 UI」。
人類在這一步要做的選擇,是決定「畫面何時顯示新標題」:送出後立即顯示,還是等待伺服器確認。這會影響失敗時如何回復畫面。若 PRD 沒說,不能讓 AI 靠習慣自行決定;我會把選擇與理由寫回需求,讓之後的測試有同一個標準。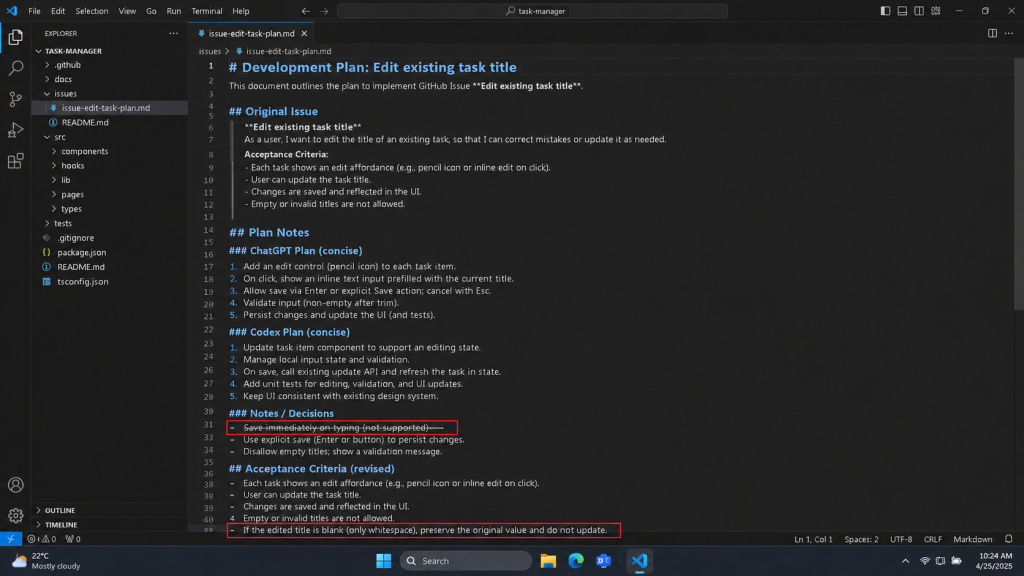
本文形成了比較計畫的欄位與一份預定實作順序,尚未取得真實 Repository 的資料流與測試,因此不能聲稱根因已找到。待兩份計畫實際產出後,我會比較它們是否降低 Day 11 的返工,而不是只比文字看起來是否完整。
先規劃的價值,是讓「我以為」變成可以檢查的假設,讓修改順序服務於驗收。明天開始做一個真正跨畫面、伺服器與資料層的功能。


 iThome鐵人賽
 看影片追技術