

Day 11 的編輯功能即使畫面看起來正常,也可能在純空格、找不到任務或資料庫失敗時出錯。今天的主角不是讓 AI 再多寫幾行程式,而是建立一組能否證實它完成任務的檢查。測試要保護使用者行為,不要只把目前實作原封不動重寫成斷言。
第一組是正常路徑:編輯既有任務後,新標題被保存,清單與重新讀取的資料一致。第二組是輸入邊界:空字串、純空格被拒絕,原標題不變;前後空白依 PRD 裁掉。第三組是失敗路徑:不存在的任務回傳可辨識的結果,資料庫寫入失敗時不顯示假成功。第四組是回歸:編輯後,完成狀態和篩選仍正確。
測試層級要跟風險對應。標題處理規則可以用小範圍單元測試;伺服器端更新要用整合測試確認驗證與資料寫入;畫面上的取消、錯誤提示和成功狀態,則至少要有一次實際操作或適合的互動測試。每一層都只測它能負責的事,避免所有問題都靠昂貴的端到端測試抓。
我會先寫「純空格編輯不得覆蓋原標題」的失敗案例,再請 Codex 修正。這樣可以確認測試真的能抓到缺陷,而不是一開始就永遠綠燈。如果案例在修正前意外通過,要檢查它是否根本沒走到伺服器更新,或測試資料建立錯誤。紅燈、修正、綠燈的過程比最後一張綠燈截圖更有資訊。
例如實作使用某個函式名稱,測試就直接斷言它被呼叫一次,這可能保護了實作形狀,卻沒有保護「空白標題不可保存」的使用者規則。日後重構換了函式,測試會失敗;真正的行為若壞了,測試卻不一定抓得到。我會優先觀察輸入、輸出和資料狀態,再把內部呼叫斷言留給確有必要的邊界。
測試資料也要能隔離。若某個案例依賴前一個案例留下的任務,單獨跑時可能失敗,全部一起跑又碰巧通過。每個重要情境應有可重建的起始狀態,失敗時能看出是哪一步不符合預期。這讓 AI 修正時不必猜測環境殘留,也讓文章讀者能重現。
「根據 Day 11 的驗收條件,先列出目前測試缺口。新增最少但有意義的測試,優先覆蓋純空白、任務不存在與儲存失敗;確認至少一個案例在修正前能暴露問題。再修正實作,執行相關測試並逐項回報結果。不要刪除失敗測試來讓指令通過。」
回報時要包含實際執行指令、測試數量與失敗訊息。若資料庫或瀏覽器環境無法啟動,要清楚說哪些層級沒驗證,並提出可在現有環境做的最小替代檢查。把「沒跑」當成「通過」,會讓後面每個 Feature 的品質基準失效。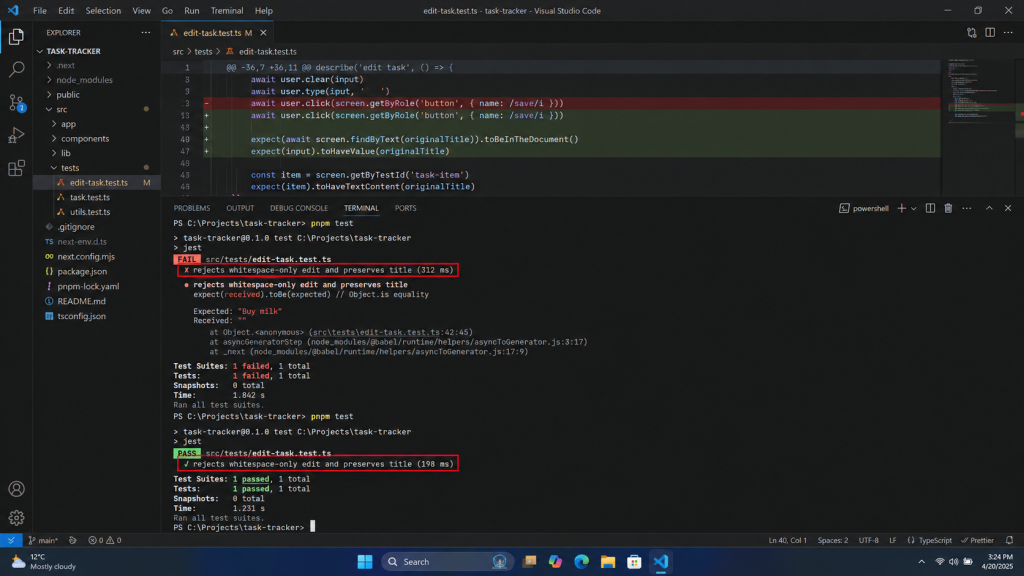
目前完成的是從 PRD 推出的測試矩陣與執行順序,尚未在真實程式上取得紅燈或綠燈。後續若實測發現原本預想的失敗案例抓不到 Bug,也會保留這個失敗,因為它反映測試設計需要修正。
測試真正的價值,是讓一句「我覺得完成了」變成別人可重現的判斷。明天換一個起點:只給錯誤訊息,看看 AI 會如何查原因。


 iThome鐵人賽
 看影片追技術