

開發時最常見的求救訊息是「它壞了」,再附上一段錯誤 Log。這段訊息通常只告訴我們哪裡爆炸,未必說明為什麼爆炸。今天用任務編輯流程設計一個 Debug 實驗:一開始只提供錯誤訊息與重現步驟,不提供我猜的原因或檔名,觀察 ChatGPT 與 Codex 如何縮小範圍。
示範情境是:編輯某筆任務時請求回傳伺服器錯誤,但新增與列表仍正常。真正實測時會貼上完整的、已遮蔽敏感值的錯誤訊息、輸入資料、環境與重現頻率;目前沒有這些資料,因此不能捏造一段堆疊追蹤。先把症狀寫具體,是為了區分「每筆都壞」與「只有特定資料壞」這兩條不同的調查路徑。
給 ChatGPT 的描述是:「只根據以下錯誤訊息與重現步驟,提出最多三個可檢驗的原因。每個原因都寫出支持與反對它的證據,以及下一個最小檢查。不要直接宣稱根因。」給 Codex 的描述是:「先只讀 Repository,找出編輯任務的請求路徑與錯誤來源。列出你查到的程式證據、建議執行的檢查;在確認重現條件前不要修改。」
比較時,我會看它們是否將錯誤訊息當成線索而非答案,是否分辨網路、驗證、資料存取與畫面狀態;也會記錄哪些假設被後續證據推翻。若某個工具一開始就猜中,也要看它能否說明因果關係,而不是碰巧改到讓錯誤消失。
若錯誤只發生在含特殊字元的標題,輸入處理是候選;若所有編輯請求都失敗,路由或資料庫連線更值得先看。調查時我會建立一個簡單表格:假設、目前證據、下一個檢查、檢查結果。每做一次檢查,就更新狀態,不讓舊猜測留在摘要裡繼續影響後續判斷。
這裡也能比較人與 AI 的 Debug 習慣。人類可能先重現、縮小輸入範圍,再查 Log;AI 可能先讀錯誤附近的程式。兩種順序都可能有效,關鍵是能否用最少的檢查排除最多假設。最後不是比誰先說出一個原因,而是比誰能提出證據鏈並留下回歸測試。
修掉表面症狀可能只是把錯誤吞掉,或讓畫面不顯示失敗。真正的根因必須能解釋為什麼特定輸入觸發錯誤、為什麼其他流程正常,且修正後原始重現步驟不再失敗。最好再有一個測試保護同類情境,避免之後重現。若沒有可靠重現,應維持「尚未確認」狀態。
Debug 過程中的觀測也要節制。可以加暫時的診斷輸出,但不能把 Token、密碼或完整使用者資料寫進 Log;完成後移除不必要的臨時輸出。若要查看線上資料,先定義只讀範圍與資料遮蔽方式。診斷證據越多,越需要清楚的信任邊界。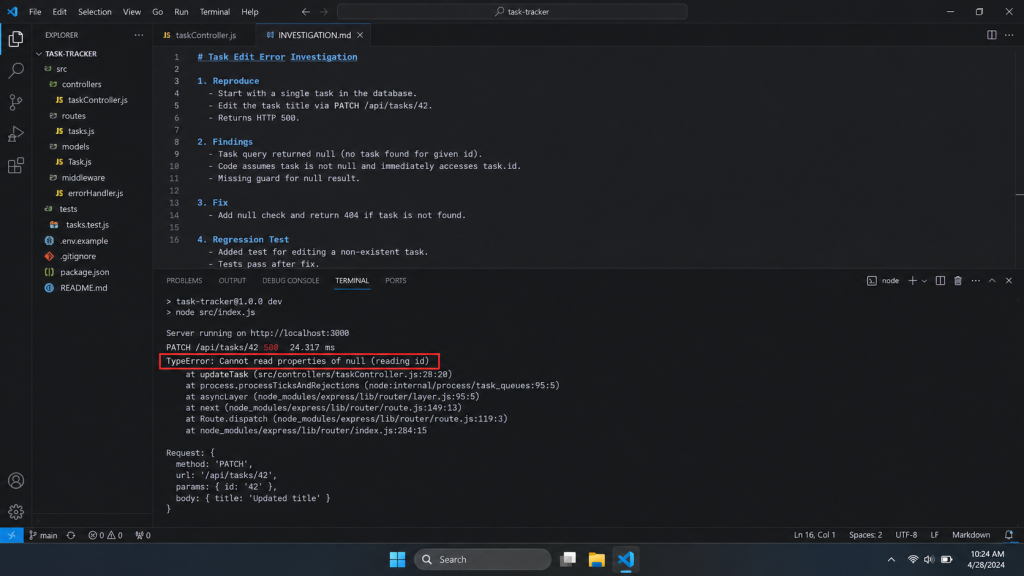
目前建立的是 Debug 實驗設計與根因判定標準,尚無真實錯誤可供兩個工具比較。因此不提供虛構的修復時間、命中率或錯誤堆疊。實測後會保留錯誤猜測和返工,讓文章呈現真實調查,而非事後整理出的直線故事。
一段錯誤訊息是調查的起點,不是結論。明天討論另一種容易讓 AI 亂猜的情況:專案變大後,上下文該怎麼提供。


 iThome鐵人賽
 看影片追技術