
在上一篇中,我們用 Anthropic 官方 SDK 接上了天氣查詢 Tool。那時候我們寫的是一段很單純的線性流程:
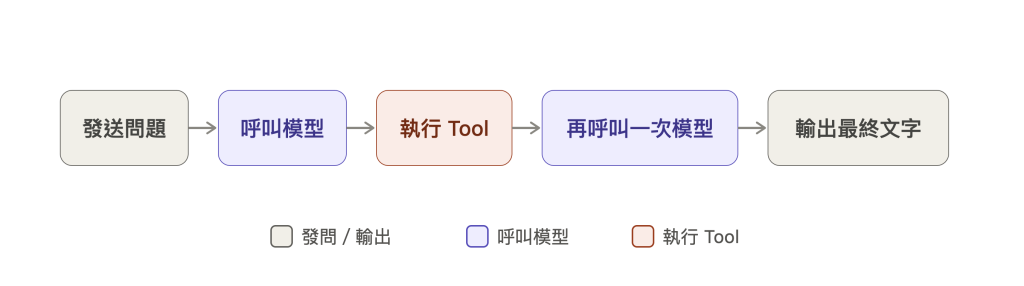
這段程式從頭到尾跑一次就結束了。這種寫法適合單次、固定的工具查詢,但當任務變得更複雜時,線性的程式架構就會遇到瓶頸。
例如下圖展示的流程,任務需要多輪循環與回退:模型查了一次資料發現不足,可能需要再查第二次;或者產生的輸出沒通過規則檢查,需要退回上一步重試。
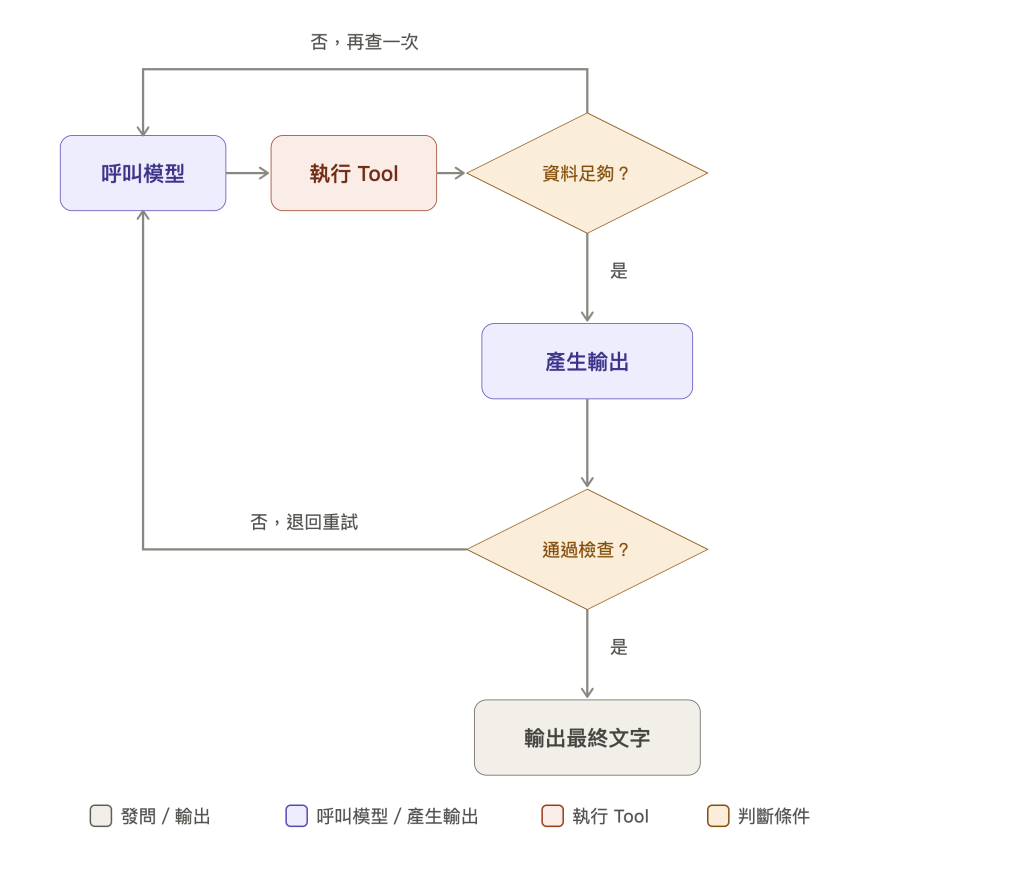
如果繼續用原生的 Python 腳本硬寫,我們就必須引入 while 迴圈,並在裡面手動維護大量狀態Flag(如 current_step、retry_count)與巢狀 if-elif-else。這會讓跳轉邏輯散落在程式碼各處,既看不清整體的執行路徑,每個步驟也因為互相依賴而難以單獨測試。
這正是我們引入 LangGraph 的原因。LangGraph 讓我們不再用混亂的條件跳轉來硬湊流程,而是把多步驟的執行邏輯拆解成一張標準的「狀態圖(State Graph)」。
整個系統只由三個核心元素組成:
上面的流程,改成用 LangGraph 來表示,就會是像這樣:
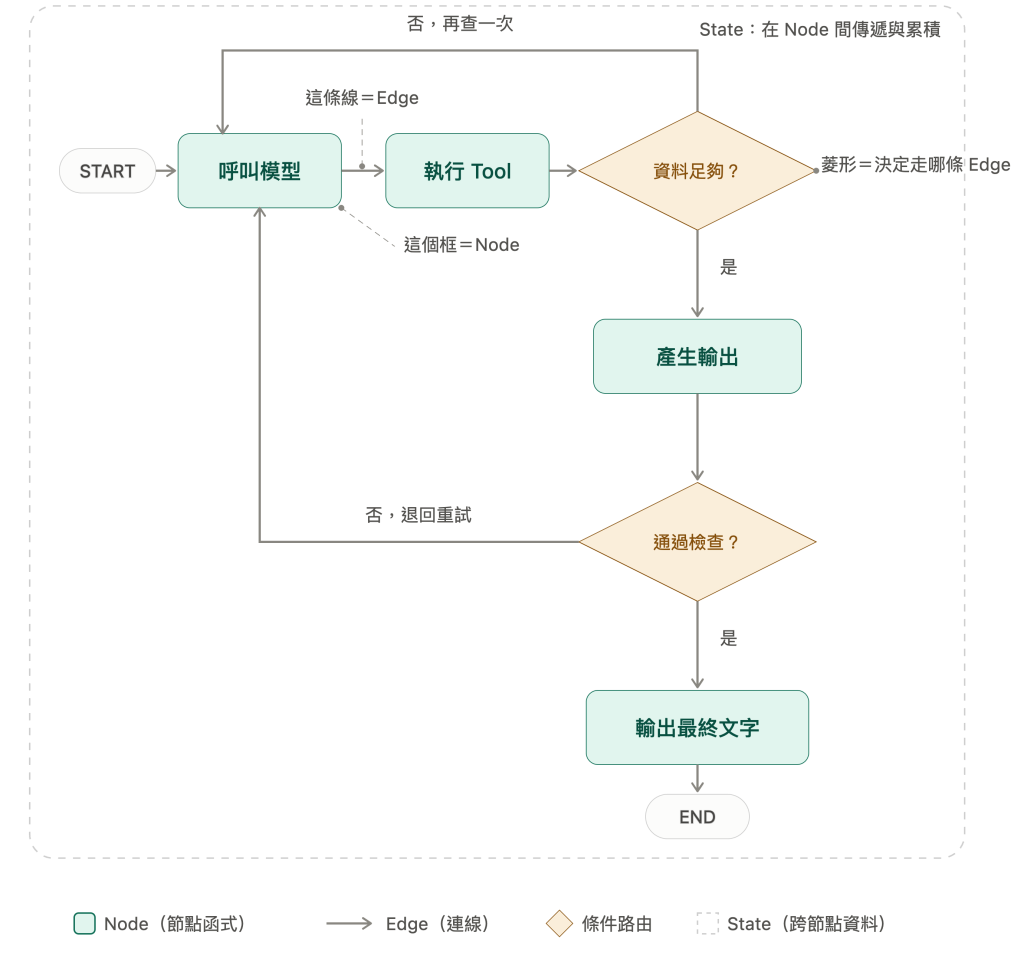
在 LangGraph 中,Node 是圖上的運算單元。它在程式碼中對應一個 Python 函式,專注完成一個步驟(如呼叫模型、調用 API 或檢查規則),並回傳該步驟產生的資料。
每個 Node 執行時都遵守三個步驟:
state,取出自己需要的欄位。def call_model_node(state: AgentState):
# 1. 從 state 拿出需要的資料
user_msg = state["messages"][-1]
# 2. 專心做這個節點該做的事
ai_response = call_model(user_msg)
# 3. 回傳要寫回 state 的新資料
return {"messages": [ai_response]}
一個典型的 Agent 流程,有幾種常見的節點:
每個 Node 都有清楚的職責邊界,節點之間不互相呼叫,也不直接傳遞參數。
有了獨立的節點後,我們需要用 Edge(連線 / 箭頭)把它們串成可執行的流程:
START 進入 call_model,或從 call_model 連至 execute_tool)。generate_output,若不足則連回 call_model 再查一次。節點之間互不認識、Edge 又只負責決定路線,那麼節點 A 算出來的資料,節點 B 要怎麼拿到?
這就是 State(狀態) 的角色。State 是在整張圖中傳遞與累積的共用資料。前一個節點回傳的更新會寫入 State,下一個節點執行時,就能直接從 State 拿到最新更新後的資料。
在定義 State 時,將「對話記錄(messages)」與「業務事實(自訂欄位)」分開存放是一個重要原則:
messages):供模型閱讀的非結構化文字歷史(例如:「我想退貨」、「訂單編號是 ORD-8821」)。order_id: str(提取並驗證過的訂單編號)refund_amount: int(後端查出的具體金額)class AgentState(TypedDict):
# 1. 對話記錄:供模型理解人機溝通語境
messages: list[AnyMessage]
# 2. 業務事實:供程式碼與 API 直接精準操作
order_id: str
refund_amount: int
messages)就好?
state["order_id"] 與 state["refund_amount"] 發送請求。如果全混在文字中,每次都得重新依賴模型從落落長的文字中抽取,既不可靠又容易出錯。把流程拆解成 Node、Edge 與 State 後,為 Agent 程式帶來了三個好處:
LangGraph 把執行拓撲完全抽離:各節點函式只負責具體運算,起點、連線與條件路由則直接透過圖結構集中宣告:
# 宣告狀態圖並註冊節點與連線
builder = StateGraph(AgentState)

# 1. 定義 4 個節點(Node):對應圖中的運算單元
builder.add_node("call_model", call_model_node)
builder.add_node("execute_tool", execute_tool_node)
builder.add_node("generate_output", generate_output_node)
builder.add_node("output_final_text", output_final_text_node)

# 2. 定義固定連線(Edge):對應單向順序執行
builder.add_edge(START, "call_model")
builder.add_edge("call_model", "execute_tool")
builder.add_edge("output_final_text", END)

# 3. 定義條件路由(Conditional Edge):對應依 State 決定的分支與回退
builder.add_conditional_edges(
    "execute_tool",
    check_data_sufficient,                     # 判斷資料是否足夠
    {
        "retry": "call_model",                 # 資料不足,連回模型重新查詢
        "continue": "generate_output",         # 資料足夠,進入下一步
    },
)

builder.add_conditional_edges(
    "generate_output",
    check_output_valid,                        # 判斷是否通過規則檢查
    {
        "retry": "call_model",                 # 未通過檢查,退回模型重試
        "pass": "output_final_text",           # 通過檢查,輸出最終結果
    },
)
所有起點、終點、循環路徑與分支條件都直接呈現在圖的結構宣告中。閱讀或修改程式碼時,只要看圖的組裝區塊,就能掌握整體的執行流程,不必在各個節點內部追蹤跳轉旗標。
節點只專注完成自己的運算,不包含任何流程跳轉程式碼,節點之間也不互相呼叫,只透過 State 交換資料。
這讓每個步驟都能單獨進行單元測試:
execute_tool 節點時,直接傳入測試用的 State,驗證回傳的查詢資料是否正確。call_model 節點時,可以注入 Mock 模型,驗證輸出的 Message 格式。因為任務的所有事實都完整保存在 State 裡,LangGraph 可以在每個節點執行完畢時,自動將 State 快照存入資料庫(例如 SQLite 或 PostgreSQL)。
這帶來兩個關鍵能力:
thread_id),系統就能從中斷點精確載入狀態並繼續執行,不需要重跑前面的前置步驟。理解了「以 State 為中心的流程設計」後,接下來的幾篇,我們將會按步驟繼續介紹LangGraph的這些概念:


 iThome鐵人賽
 看影片追技術