
在上一篇中,我們建立了能維持對話記憶與系統規則的對話程式。但如果只有上下文,模型依然無法跨出純文字回覆的限制。這一篇,我們要為模型配備 Tool(工具調用 / Function Calling),透過為對話程式接入第一個即時天氣查詢 Tool,探討 Agent 呼叫 Tool 的時機、底層運作機制、實作資料流,以及實務上的設計原則。
語言模型擅長自然語言理解與邏輯推導,但面對自身能力邊界時,必須交接給 Tool 處理。實務上主要涵蓋三類核心任務:
在實作之前,先來釐清一項事實:語言模型是無法直接執行工具的,也不能直接執行本地 Python 程式碼。你可以把它理解為:當模型判斷要回答使用者的問題必須執行某項工具時,它並不是自己去跑,而是回覆一段結構化訊息告訴程式:「我需要執行工具 A,參數是 X」。我們的程式碼收到這段要求後,才真正去呼叫對應的函式或 API,取得結果後再交還給模型。
所謂的 Tool Calling,本質就是由應用程式(本地 Runtime)與模型共同完成的五個步驟:
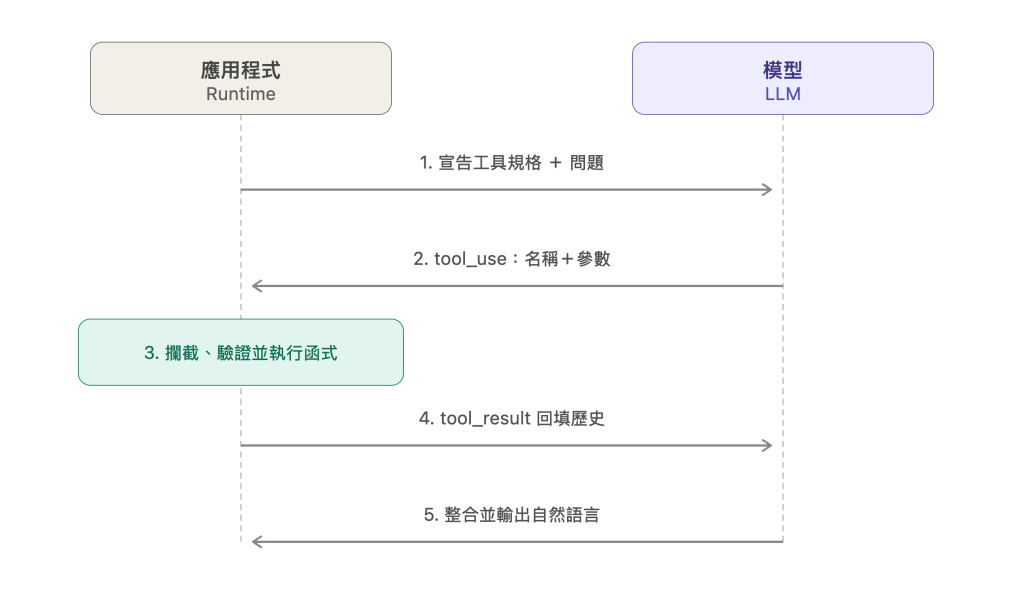
tool_use):模型對照使用者的問題與你提供的工具清單。當它判斷回答問題需要用到清單中的工具時,停止生成一般文字,改為從中選出合適的工具,並從對話中抽取出符合規格的參數值,輸出結構化的調用資料。tool_result):應用程式將函式回傳的資料轉為文字或 JSON,包裝成 tool_result 訊息區塊,追加到對話歷史中再次傳給模型。我們以天氣查詢為例,在 ai-agent-sample/chat-model-basics 中實作一個具備 Tool 呼叫能力的對話程式。我們在範例程式 weather_tool.py 使用 Anthropic Messages API,展示模型如何判斷調用時機、抽取出地點參數,並根據回傳的氣象數據完成回答。
先來看執行結果。進入範例目錄並執行:
uv run chat-with-weather
輸入天氣查詢:
輸入 /exit 結束對話。
你:台中現在天氣如何?
模型要求:get_current_weather({'location': '台中'})
Tool 回傳:{"ok": true, "location": "台中", "temperature_c": 31, "condition": "多雲", "precipitation_probability": 40}
AI:台中目前 31°C,多雲,降雨機率 40%。
首先,定義Tool Schema,也就是我們要告訴模型有哪些工具可以使用。在 weather_tool.py 中,宣告工具的介面規格(Schema)。模型無法直接讀取本地 Python 函式的簽名與型別,因此我們必須先以 JSON Schema 格式,明確定義工具的名稱、用途說明與參數規則:
WEATHER_TOOL = {
    "name": "get_current_weather",
    "description": "取得指定城市目前的氣溫、天氣狀況與降雨機率。",
    "input_schema": {
        "type": "object",
        "properties": {
            "location": {
                "type": "string",
                "description": "城市名稱,例如「台中」。",
            }
        },
        "required": ["location"],
        "additionalProperties": False,
    },
}
這份 Schema 是模型決定工具調用與參數抽取的唯一依據。在撰寫時,description 的精確度直接決定了調用的正確性:
description:模型閱讀使用者的對話時,會依據這段用途說明,來判斷該挑選哪一個工具。若描述過於模糊(例如只寫「查詢資料」),模型可能在面對天氣問題時無法命中,或在無關話題時誤觸調用。description:模型也是依據欄位的說明,決定如何從使用者的口語提問中抽取參數值。例如這裡明確約定「城市名稱,例如『台中』」,模型在看到「這裡現在幾度」搭配前文提及的「我剛到台中」時,就知道該將「台中」抽取出並填入 location,而不是傳入整個句子或空值。required 與 additionalProperties: False:明確要求模型必須提供必要欄位(location),並禁止傳入未定義的額外參數,避免多餘欄位導致本地函式執行失敗。定義完工具後,接著在呼叫 Messages API 時,透過 tools 參數將定義好的工具清單傳入:
tool_request = client.messages.create(
    model=model,
    max_tokens=1024,
    system=SYSTEM_PROMPT,
    tools=[WEATHER_TOOL],
    messages=messages,
)
當模型判斷需要即時氣象時,它不會輸出一般的文字內容,而是在回傳的 content 中包含 tool_use 區塊:
ToolUseBlock(
    type="tool_use",
    id="toolu_01A...",
    name="get_current_weather",
    input={"location": "台中"},
)
模型產生了調用意圖與參數(location="台中"),並附帶一個唯一的 id(例如 toolu_01A...),用來在後續配對工具的執行結果。
模型回傳的 tool_request.content 是一個由區塊組成的清單。應用程式必須先檢查是否有 type == "tool_use" 的區塊:若沒有,代表模型直接產生文字回答,對話流程直接結束;若有,則表示模型提出了調用請求:
# 檢查模型回覆中是否包含 tool_use 區塊
tool_uses = [block for block in tool_request.content if block.type == "tool_use"]
if not tool_uses:
    return messages
確認收到 tool_use 後,應用程式不能直接信任模型給出的內容,必須先驗證工具名稱是否為我們註冊的工具、確認參數型別是否正確,再分派給具體的查詢函式:
def execute_tool_use(block) -> str:
    # 1. 驗證工具名稱
    if block.name != WEATHER_TOOL["name"]:
        raise UnknownToolError(f"未註冊的 Tool:{block.name}")

    # 2. 驗證參數是否合法
    location = block.input.get("location")
    if not isinstance(location, str) or not location.strip():
        return json.dumps(
            {"ok": False, "reason": "invalid_location"},
            ensure_ascii=False,
        )

    # 3. 呼叫具體的業務查詢邏輯
    return get_current_weather(location)
具體的天氣查詢由 get_current_weather 負責。範例中我們直接寫假資料來模擬查詢,並回傳標準 JSON 字串:
def get_current_weather(location: str) -> str:
    weather_by_location = {
        "台中": {
            "temperature_c": 31,
            "condition": "多雲",
            "precipitation_probability": 40,
        },
        "台北": {
            "temperature_c": 29,
            "condition": "短暫陣雨",
            "precipitation_probability": 70,
        },
    }
    location = location.strip()
    weather = weather_by_location.get(location)
    if weather is None:
        return json.dumps(
            {"ok": False, "reason": "location_not_found", "location": location},
            ensure_ascii=False,
        )
    return json.dumps(
        {"ok": True, "location": location, **weather},
        ensure_ascii=False,
    )
本地函式若查無該城市資料,會回傳 {"ok": false, "reason": "location_not_found"} 等明確錯誤原因,而不是拋出例外讓程式中斷。
取得執行結果後,不能直接將原始 JSON 印給使用者,而是將結果包裝成 tool_result 區塊送回模型,讓模型結合提問與資料組織回答。
這需要完成兩則訊息的追加,並發起第二次 API 呼叫:
tool_request.content 以 role: "assistant" 加入訊息歷史。type: "tool_result",並帶上對應的 tool_use_id,以 role: "user" 加入訊息歷史。# 1. 保存模型提出的 tool_use
messages.append({"role": "assistant", "content": tool_request.content})
# 2. 封裝 tool_result 並放回歷史
tool_results = [
{
"type": "tool_result",
"tool_use_id": block.id,
"content": execute_tool_use(block),
}
for block in tool_uses
]
messages.append({"role": "user", "content": tool_results})
# 3. 發起第二次呼叫,取得最終文字回答
final_response = client.messages.create(
model=model,
max_tokens=1024,
system=SYSTEM_PROMPT,
tools=[WEATHER_TOOL],
messages=messages,
)
messages.append({"role": "assistant", "content": final_response.content})
在第二次呼叫 client.messages.create 時,傳給模型的 messages 清單完整結構如下:
[
  {
    "role": "user",
    "content": "台中現在天氣如何?"
  },
  {
    "role": "assistant",
    "content": [
      {
        "type": "tool_use",
        "id": "toolu_01A...",
        "name": "get_current_weather",
        "input": {"location": "台中"}
      }
    ]
  },
  {
    "role": "user",
    "content": [
      {
        "type": "tool_result",
        "tool_use_id": "toolu_01A...",
        "content": "{\"ok\": true, \"location\": \"台中\", \"temperature_c\": 31, \"condition\": \"多雲\", \"precipitation_probability\": 40}"
      }
    ]
  }
]
這段資料結構清楚呈現了兩次往返的關鍵:
tool_use_id 必須對齊:第二筆訊息中 tool_result 的 tool_use_id,必須與第一筆 tool_use 的 id 完全吻合,模型才能將真實資料正確對應到當初發起的工具請求。type: "tool_result",並以 role: "user" 的身分放回對話歷史。模型在第二次呼叫時看到完整的提問、自己發出的調用請求與帶回的氣象數據,因此能將原始 JSON 轉化為易讀的自然語言回覆:「台中目前 31°C,多雲,降雨機率 40%。」
到目前為止,我們在不依賴任何框架的情況下,拼出了 Agent 最基本的四個核心要素:
這是一個最基礎的 Agent 原型。但在真實應用中,要讓 Agent 能安全、可控地處理複雜任務,還有許多細節需要注意:例如多步驟任務的分支控制、失敗時的錯誤重試、敏感操作的人工審核(Human-in-the-Loop),以及隨時需要中斷與恢復的狀態保存。
為了用更結構化、更清晰的方式管理這些流程與狀態跳轉,接下來我們將引入專門的狀態圖編排框架——LangGraph。
下一篇我們將探討如何用LangGraph管理更複雜的 Agent 執行流程。


 iThome鐵人賽
 看影片追技術