
系列:「一人艦隊:用一群 AI CLI 打造跨平台代理 mesh」— 第 18 篇
紀錄日期:2026-09-15(晚)
補昨天說的那個沒跑的測試:DEMO-m5-04。規格一句話:iPad 在前景 pull 成功一次;App 進背景後,coordinator 的 roster 要在 30 秒內把它標成 offline;回前景後恢復。
聽起來很小。但它驗證的是整個手機節點設計裡最重要的一條規則:手機只在前景算數。coordinator 派工前會看 roster,一台看起來 online 其實已經被 iOS 凍結的手機,會讓整個 fan-out 卡在那台上,直到逾時。
先講一下為什麼會有這條規則。iOS 不允許 App 在背景長時間跑網路迴圈,按下 Home 之後系統只給幾秒鐘就把 App 凍結。所以手機節點沒有 daemon,只有「App 開著的時候,每秒去 coordinator 拉一次任務」。契約裡把這件事寫成 DEC-22:「行動 App 不跑 daemon、只在前景保證」。coordinator 這邊則靠一個很簡單的規則判斷一支手機還在不在:
這三個數字寫在契約第 2 節,也寫在 core 的程式碼裡。今天要驗的就是這三個數字在真的裝置上有沒有成立。
晚上九點開始跑,第一步就失敗。coordinator(Z13)整台從 Tailscale 網路上消失,不是 daemon 掛,是機器離線。
tailscale ping 100.70.149.18 → no reply
curl http://100.70.149.18:7880/api/version → timeout (6 s ×3)
這個 mesh 的設計是單一 coordinator、沒有 failover(契約裡叫 DEC-07,明寫「不做」)。所以 coordinator 一離線,九台機器、三支手機全部變成一盤散沙:能互相看見,但沒有人能派工。這不是 bug,是我自己在契約裡簽字接受的限制。今晚第一次真的體會到它的意思。
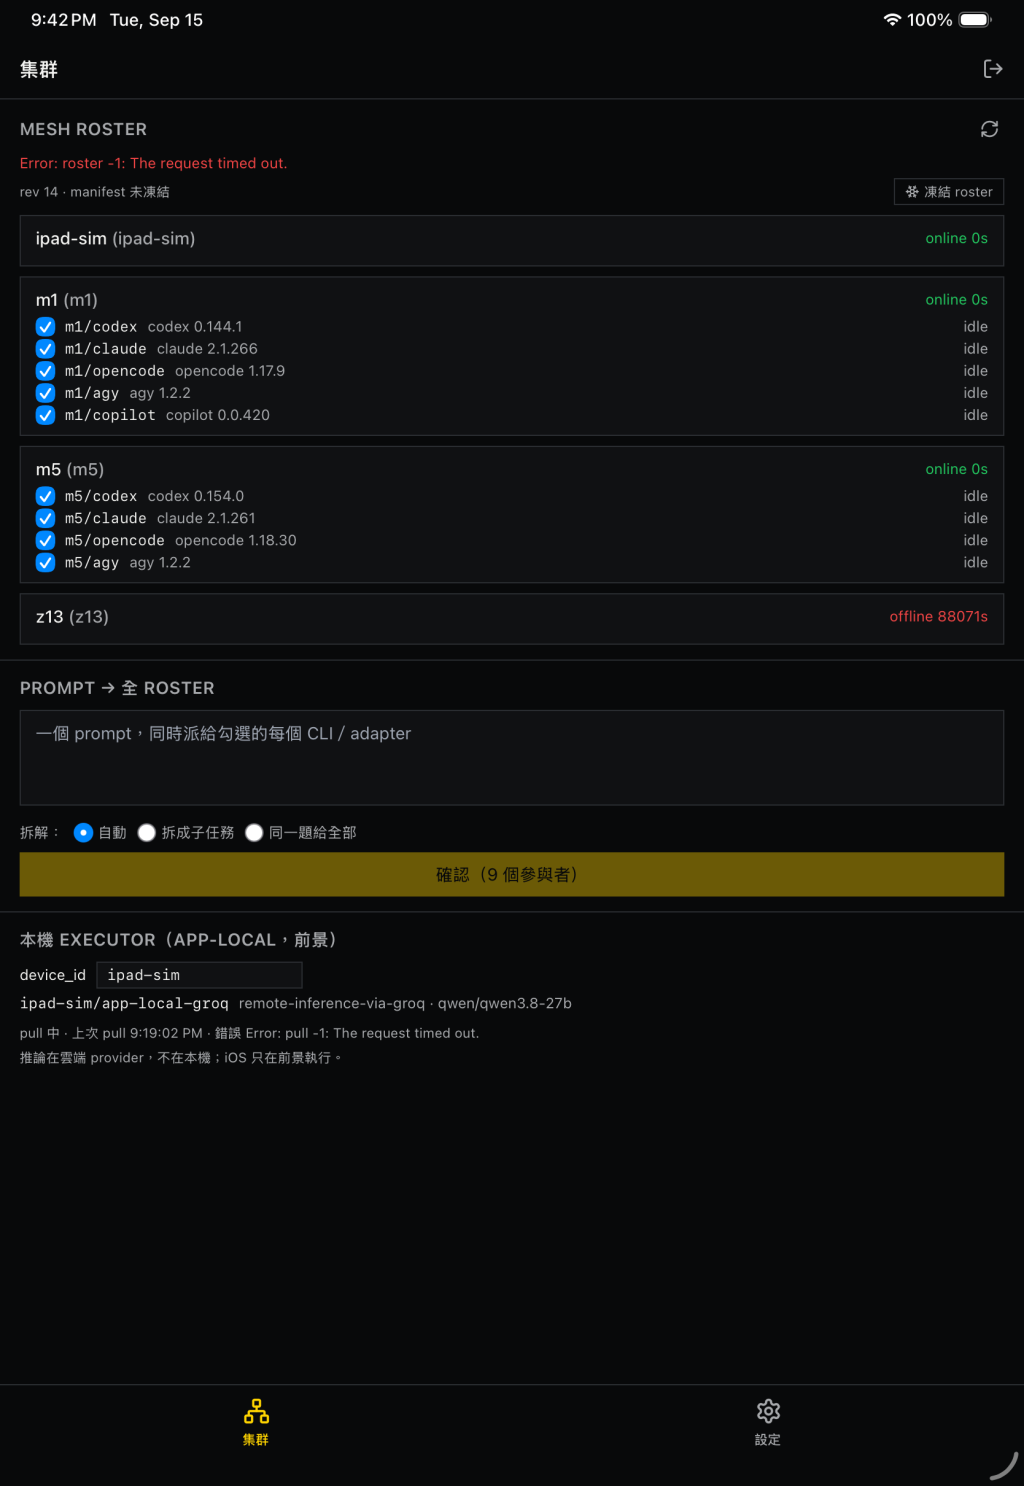
(圖一)
上面這張是 iPad 模擬器在 Z13 消失後的畫面。兩行紅字很誠實:roster 拉不到,pull 也逾時。但仔細看會發現一個問題:roster 區塊還留著最後一次成功的快照,m1 和 m5 旁邊寫著「online 0s」,好像什麼事都沒發生。那個 0 秒是快照當下的年齡,畫面沒有隨時間往上加。使用者如果只看綠字,會以為一切正常。這是今天順手記下的第一個 UI 缺陷:coordinator 不可達時,舊快照要不就整塊灰掉,要不就把年齡改成「最後成功 N 秒前」。
第二堵牆:真機 iPad 也連不上。devicectl 先回 error 4000(建立不了連線),再回 10002(裝置上鎖)。我沒辦法從 Mac 把一台上鎖的 iPad 上的 App 推到背景。真機那一輪今天做不到,這點下面會再寫一次。
每台桌機跑的都是同一顆 binary,daemon 本來就有 roster 和 pull 端點,差別只在誰被大家指成 coordinator。所以繞路的方法很直接:把 iPad 模擬器的 coordinator 網址從 Z13 改成這台 Mac 的 127.0.0.1:7878。
具體做法是改模擬器 App 沙箱裡那個 env 檔。這個檔是 9/13 加的機制:App 啟動時讀它,把 coordinator 網址、device_id、cluster secret、API key 預先填進設定,省掉在手機上打字。今天只改其中一行,其他不動,改之前先備份,測完還原:
cp env env.bak-z13
awk -F= 'BEGIN{OFS="="} $1=="SPECTYN_COORDINATOR_URL"{$2="http://127.0.0.1:7878"} {print}' env.bak-z13 > env
用 awk 而不是 sed,是因為 9/14 那次用 sed 做遮罩把密鑰印到畫面上的教訓。awk 這種寫法只碰要改的欄位,其他行原樣輸出,什麼都不會印出來。密鑰本身不用動,整個艦隊共用同一把。
模擬器一重開,本機 daemon 的 roster 上就出現 ipad-sim,旁邊是 m1 和 m5,z13 標著 offline 87876 秒(那是它上次被本機看到的時間,一天多以前)。
從「coordinator 不見了」到「換一台 coordinator 繼續測」,大概三分鐘。這件事本身值得記一筆:failover 在技術上一點都不難,難的是誰決定切換、切換之後凍結的 manifest 和進行中的 task 狀態怎麼帶過去。今天我是人肉決定、而且沒有任何 task 在跑,所以才能三分鐘。
方法很土:
simctl launch com.apple.Preferences 把「設定」App 叫到前面,我們的 App 就進背景。spectyn peer get /rpc/mesh/roster 簽章打一次 roster,只看 ipad-sim 那一列的 presence。simctl launch ai.spectynmesh.app 把 App 叫回前面,繼續打 roster 直到它回到 online。每一筆都寫進 JSONL 當證據。第一輪 5 秒取樣,原始資料長這樣(時間戳省略):
A-foreground   state=online   age=0
B-background   state=stale    age=6
B-background   state=stale    age=16
B-background   state=stale    age=26
B-background   state=offline  age=37
C-foreground   state=online   age=0
畫成時間線:
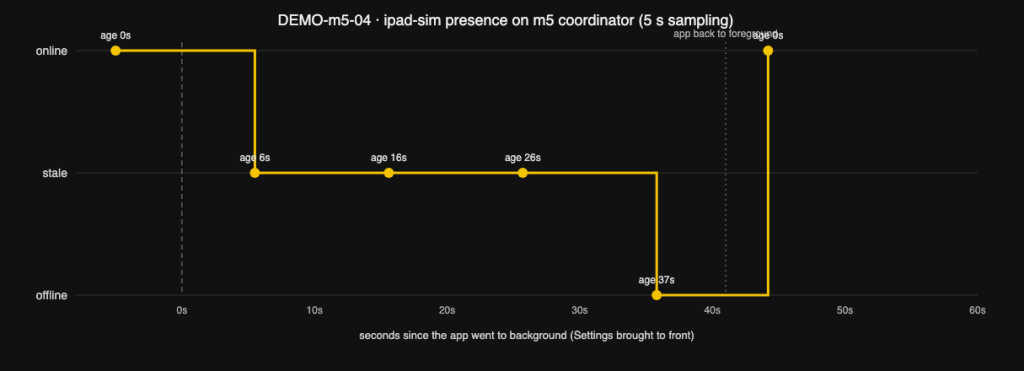
(圖二)
第二輪改成只記狀態變化,並且把時間對齊到「設定 App 到前景」那一刻:
| 事件 | 距離進背景 | roster 上的 age | 狀態 |
|---|---|---|---|
| 前景 pull 中 | −5 s | 0 | online |
| 進背景後最後一次 pull | 約 +5 s | — | — |
| 第一個超過 5 秒的樣本 | +13.7 s | 8 | stale |
| 第一個超過 30 秒的樣本 | +40.4 s | 35 | offline |
| 回前景後第一次 pull | +6.4 s(自回前景起) | 0 | online |
一、契約語意成立。 core 在每次 roster 請求時,用「最後一次 pull 距今多久」分類,程式碼就這幾行:
pub fn classify_presence(now_unix: u64, last_seen_unix: Option<u64>) -> (PresenceState, Option<f64>) {
    let Some(seen) = last_seen_unix else { return (PresenceState::Offline, None) };
    let age = now_unix.saturating_sub(seen) as f64;
    let state = if age <= PRESENCE_STALE_AFTER_S {        // 5
        PresenceState::Online
    } else if age <= PRESENCE_OFFLINE_AFTER_S {           // 30
        PresenceState::Stale
    } else {
        PresenceState::Offline
    };
    (state, Some(age))
}
旁邊有一個單元測試叫 presence_boundaries_follow_the_contract,把 age 5、6、30、31 四個邊界釘死。我看到的是 35 而不是 31,原因在我的取樣工具:spectyn peer get 一次要跑五六秒(它會先做一輪簽章和 peer 探測),所以樣本之間差了六七秒,剛好跨過 30 那條線。不是 core 慢,是我的尺太粗。這種「先懷疑量測工具,再懷疑被測系統」的順序,是今天第二個想留下來的習慣。
二、iOS 給了 5 秒寬限。 App 進背景後 JavaScript 還跑了大約 5 秒,最後一次 pull 發生在 +5.4 秒。所以從使用者按下 Home 算起,roster 要 36 秒左右才會 offline,不是 30。這 5 秒是 iOS 的行為,不是我們寫的;換句話說,契約裡的 30 秒是「從最後一次 pull 算」,不是「從按 Home 算」。
三、任務描述和契約不一致。 任務單寫「30 秒內標 offline」,契約寫「超過 30 秒 offline」。兩句話看起來一樣,實際差 6 秒以上:按契約,30 秒整還是 stale,要 31 秒才 offline;再加上 5 秒寬限,從按 Home 算是 36 秒。以契約為準,我在報告裡請 coordinator 那邊把任務描述改成「最後一次 pull 後超過 30 秒」。
要真的做到「按 Home 30 秒內」,App 得在收到 visibilitychange 時主動送一個「我要進背景了」的訊號,讓 coordinator 立刻把它標成 offline。契約沒有這個端點。我列成契約備註 (10) 交出去,不自己加:契約是大家對齊的東西,一台機器擅自多一個端點,其他八台就對不上了。
回前景後第一次 pull 到 roster 變 online,量到 6.4 秒。拆開來:App 的執行迴圈每 1 秒跑一次;每次 pull 帶 wait_s=3,也就是 coordinator 會 long-poll 最多 3 秒才回;再加上模擬器把 App 從背景喚醒、WebView 恢復計時器的時間。理論下限大約 4 秒,量到 6.4 秒算合理。demo 時要記得:手機從口袋拿出來解鎖、點開 App,到 roster 上綠燈,大約要數到七。
| 項目 | 結果 |
|---|---|
| DEMO-m5-04 模擬器 + 本機 coordinator | 契約語意 PASS(stale 8 s、offline 35 s、恢復 6.4 s) |
| DEMO-m5-04 真機 iPad Pro | 22:03 補跑 PASS(coordinator = 這台 Mac;見下一節) |
| Z13 fleet coordinator | DOWN,整台離開 tailnet |
| 證據 | 兩份 JSONL、一張畫面截圖、一張時間線 |
| commit | a3fb9f08,報告已推上分支 |
真機那一輪本來要等 iPad 解鎖;寫到一半解鎖了,結果在下面。Z13 版還是要等它回來。
整個測試就是下面這段 shell,貼出來是為了下次 Z13 回來、iPad 解鎖時,把 simctl launch 換成 devicectl device process launch、把 127.0.0.1 換回 Z13 的位址,直接重跑真機版:
S=./core/target/release/spectyn; Z=http://127.0.0.1:7878; U=<simulator udid>
pres() {  # 簽章打 roster,只印 ipad-sim 那一列的 presence
  $S peer get $Z /rpc/mesh/roster | python3 -c '
import json,sys,time
r=json.load(sys.stdin); d=[x for x in r["devices"] if x["device_id"]=="ipad-sim"]
p=d[0].get("presence",{}) if d else {}
print(json.dumps({"t":round(time.time(),1),"state":p.get("state"),"age_s":p.get("age_s")}))'
}
pres                                                # A: 前景,應為 online
xcrun simctl launch $U com.apple.Preferences        # B: 設定 App 到前景,我們的 App 進背景
for i in $(seq 1 16); do sleep 5; L=$(pres); echo "$L"; echo "$L" | grep -q offline && break; done
xcrun simctl launch $U ai.spectynmesh.app           # C: 回前景
for i in $(seq 1 10); do sleep 3; L=$(pres); echo "$L"; echo "$L" | grep -q online && break; done
契約第 2 節對應的原文只有一句:「行動裝置的 presence 來自它最近一次 /rpc/mesh/pull;超過 5 秒沒 pull 就 stale,超過 30 秒 offline。」今天量到的每一筆都對得上這句話。真機版就在下一節。
寫到一半 iPad 解鎖了,Z13 還是沒回來,所以真機這輪一樣拿這台 Mac 當 coordinator,只是 iPad 走的是 Mac 的 Tailscale 位址,不是 127.0.0.1。同一份腳本,把 simctl launch 換成 devicectl device process launch:
| 事件 | 距離進背景 | roster 上的 age | 狀態 |
|---|---|---|---|
| 前景 pull 中 | −5 s | 0 | online |
| 進背景後最後一次 pull | 約 +5.6 s | — | — |
| 第一個超過 5 秒的樣本 | +14.7 s | 9 | stale |
| 第一個超過 30 秒的樣本 | +43.3 s | 37 | offline |
| 回前景後第一次 pull | +6.4 s(自回前景起) | 0 | online |
和模擬器幾乎一樣:stale 9 秒、offline 落在 31 到 37 秒之間、回前景 6.4 秒。DEMO-m5-04 在真機上 PASS,附帶條件是 coordinator 是這台 Mac,不是任務單寫的那台。等 Z13 回來再對它跑一次,預期數字相同。
真機多撞到一件事:App 重開後停在「設定」分頁,roster 上完全沒有它。原因是 Mesh 畫面沒掛載就不會 pull,這是上週「回到上次分頁」那個改動的副作用。切到「集群」分頁後 13 秒內就 online。demo 前每支手機都要停在「集群」分頁,這條寫進 checklist;長期解法是把 pull 迴圈搬到分頁之外。
spectyn peer get 當量測工具太慢。下次直接用簽章的 curl,或在 core 加一個只回 presence 的輕量端點。今晚最有價值的不是那張表,是 coordinator 消失後的那十分鐘。設計文件上「不做 failover」五個字,和九台機器同時變啞的感覺,是兩件事。下一輪契約討論,我會把「coordinator 離線時 requester 端該顯示什麼、能做什麼」列進去。至少手機畫面不該只是一直轉圈,也不該留著一排綠色的 online 0s 騙人。
明天:新系列 Day 02 講多 agent 協作的失敗模式,今晚這段剛好是「管理者模式的單點瓶頸」第一手材料。舊系列這邊,等 Z13 回來補真機。


 iThome鐵人賽
 看影片追技術