
前面講了開發前要對 AI 做的限制。限制設好了,接下來才會真的讓它開始動手。
今天「開發」這一段會講得比較多一點。老實說我給的不是什麼標準答案,而是做了多個 Vibe Coding 專案之後,慢慢整理出來的一套做法。
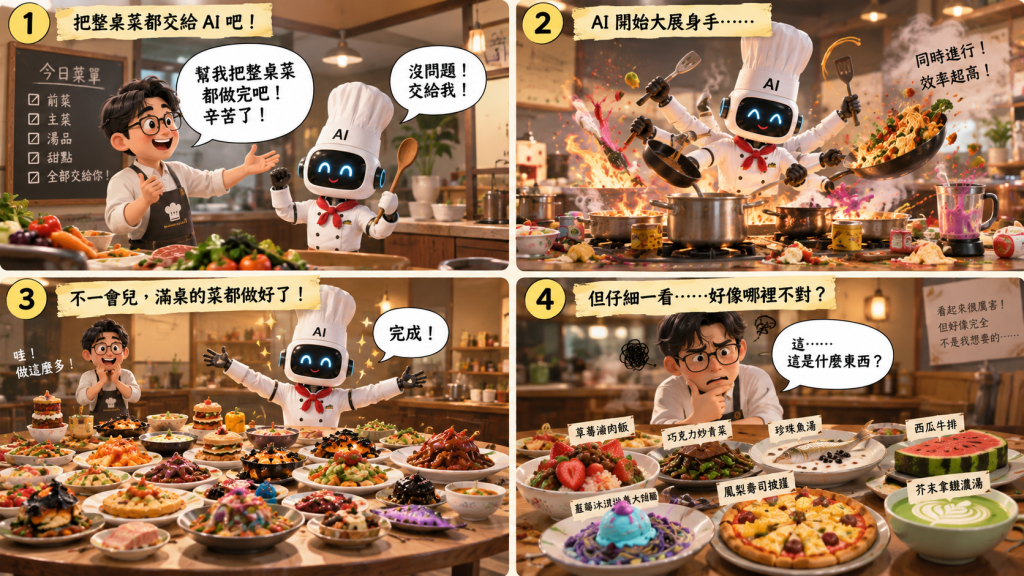
很多人可能會覺得,既然 AI 都可以寫程式了,那就直接丟一句:
「幫我把整個系統做完。」
然後人就去喝咖啡、睡覺、聊天,等 AI 全部做完再回來看成果。
如果今天只是做一個小工具,或是自己玩的 Side Project,當然可以這樣玩。但如果做的是中大型專案,甚至未來真的準備給其他人使用,我不太建議這樣做。
AI 寫程式的速度真的很快。但也因為它很快,它一次做好後,等你回來發現方向錯了,它可能已經改了幾千行、甚至幾萬行程式。最後你還是得一個一個回頭看。
所以我的做法很簡單:
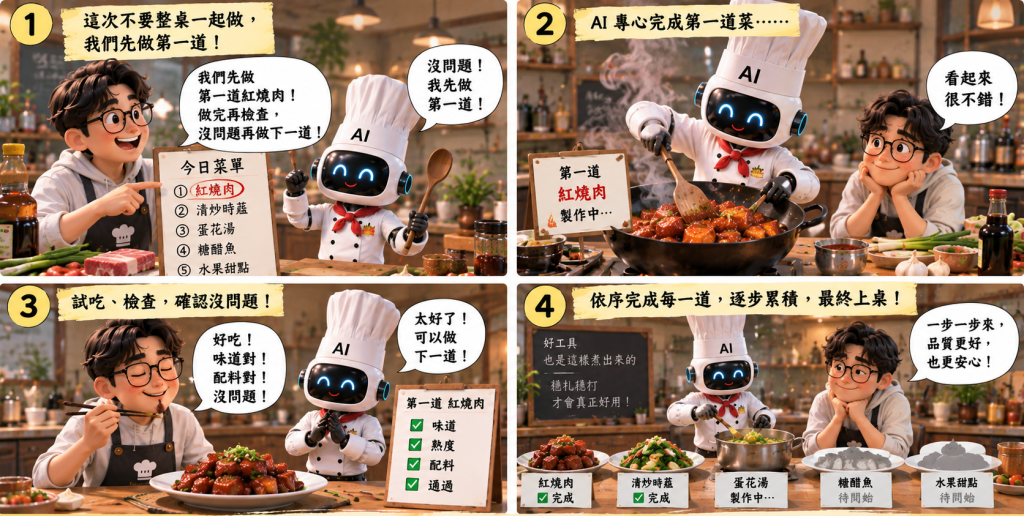
不要讓 AI 一口氣跑到底。分階段做,每一段都停下來驗。
前面既然已經準備好 PHASES.md,正式開發時就照著 Phase 一段一段做。
最基本可能會先拆成:
骨架 → 登入 → 分權 → 上傳 → 掃描 → 審核 → Portal → 部署
但專案稍微大一點,這樣其實還是太粗。因為光是一個「登入」或「上傳」,背後可能就包含畫面、API、資料庫、權限、安全檢查、錯誤處理等一堆東西。如果一個 Phase 做完就是幾百、甚至上千行的修改,最後還是很難確認:這一階段到底改了什麼?
所以實作上,我會再把 PHASES.md 拆細一點。
這裡先講一個我自己覺得很重要的原則:
Phase 通常會依照「功能」,而不是依照「前端/後端」。
也就是每一個 Phase,盡量把一條功能從頭做到尾:
畫面 → API → 後端邏輯 → 資料庫 → 權限 → 驗收
一次做完,一次驗完。而不是第一階段把所有畫面做完、第二階段再做所有 API、第三階段才補資料庫、最後才想到權限。
為什麼?
因為如果先把前端全部做完,AI 很容易先把很多邏輯做在畫面上。「登入」變成畫面切換。「分權」變成把按鈕藏起來。「限制」變成 JavaScript 判斷。畫面看起來好像都完成了,但真正應該在伺服器端做的安全控制,可能根本還不存在。等到最後才回頭補後端,前面的流程早就已經定型,很多檢查就很容易漏掉。
而且還有一個更現實的問題:只做前端,每個 Phase 根本沒辦法真正驗收。 因為後面根本沒有東西。
按下登入,看起來跳到首頁了。但到底有沒有真的驗證?不知道。按下「送審」,畫面顯示「送審成功」。但資料到底有沒有進資料庫?不知道。
所以我比較喜歡一條功能從頭做到尾。做完,就能測。
以我這系列預計要做的平台來說,會有兩個主要介面。
一個是前台 Portal,給一般使用者找工具、看工具、開工具。另一個是後台 /admin,給開發者上傳工具、審查人員進行審核,以及管理者管理使用者與權限。
很多人喜歡先把 Portal 做出來,覺得有東西可以看就完成了。但我的順序不會是先把 Portal 做好,而是先把後台做完。
我預計整個流程是:
登入 → 確認權限 → 上傳 → 安全檢查 → 審核 → 通過
都做完後前台才有東西可以顯示。後台碰到的是登入、權限、檔案上傳、掃描、審核,安全風險主要也集中在這裡。所以我的想法是:先做、先測、先把安全問題處理掉。 Portal 主要是展示已經通過審核的內容,攻擊面相對單純,所以排在後面。
先把地基做好。例如:
→ 建立專案目錄與基本架構
→ 建立設定檔
→ 建立 .env 與環境變數
→ 建立資料庫結構
→ 建立基本錯誤處理
→ 建立 Log
→ 區分開發、測試、正式環境
這個階段看起來還沒什麼功能,但這是為了你的專案更清楚、後面 Debug 更快速,也可以更安全。這邊如果沒先完成,很多安全問題其實從這裡就已經開始了。
第一個就是 Secret。資料庫密碼、API Key、Token、Secret,不要直接寫在 .py、.js 或其他程式碼裡,更不要跟著 Commit 進 Git。例如這種:
DB_PASSWORD = "MyPassword123"
API_KEY = "abc123456789"
程式當然可以跑。但這些東西一旦進入版本控制,後面就算把這兩行刪掉,也不代表它真的從 Git 歷史紀錄裡消失。
開發環境可以透過 .env 等方式管理環境相關設定,但 .env 本身不要 Commit。Repository 裡可以留下 .env.example:
DB_HOST=
DB_USER=
DB_PASSWORD=
API_KEY=
讓下一個人知道這套系統需要哪些設定。但是不要放真正的值。
而到了正式環境,真正的 Secret 怎麼保存、誰可以讀取,就應該依照企業本身的環境與 Secret 管理方式處理。
第二個很常見的是 Debug。開發階段開 Debug 是必要的,程式錯了,它直接告訴你哪一個檔案、哪一行、發生什麼 Exception,甚至整個 Stack Trace 都列給你看。測試的時候有什麼問題,把錯誤丟給 AI 它就知道問題出在哪、幫你修正。
但如果正式環境還開著,就不一定是好事了。因為錯誤畫面可能同時暴露:程式路徑、框架資訊、套件版本、資料庫錯誤、SQL,甚至其他內部資訊。 這些東西對開發者是除錯資訊,對攻擊者更是非常棒的資訊。所以開發、測試、正式環境要分開。
開發方便用的設定,不代表正式環境也應該照搬。
再來是 Log。相關的 Log 當然要留,不然系統真的發生問題,連誰做了什麼、什麼時候發生、錯在哪裡都不知道。而且如果企業內部有 Log 收攏的系統,重要的 Log 最好要送進該系統,這跟法規要求息息相關。
但 Log 也不是「越多越好」。為了 Debug,最簡單的方法可能是「把收到的 Request 全部印出來」,看起來很方便,問題是裡面可能剛好有密碼、Token、Session ID、API Key 甚至其他敏感資料。最後本來是為了追查問題留下的 Log,反而自己變成另一個敏感資訊來源。
所以 Log 不只是「有沒有記?」還要問:「記了什麼?」
這個階段做完,我不會只看「網站跑起來了嗎?」,我會確認:
Secret 有沒有被寫進程式碼?.env 有沒有不小心進 Git?Debug 有沒有依環境區分?Log 有沒有記到不該記的資料?開發環境的設定會不會直接被拿去正式環境使用?
這個 Phase 看起來只是在搭骨架、打地基、確認專案架構跟設定,但其實已經開始在處理:Secret Exposure、Sensitive Information Exposure、Security Misconfiguration。
這也就是前面講的資安左移:不是系統全部做完,最後才來想安全。從第一個 Phase 就開始。
地基做好之後,下一步才開始做登入。例如:
→ 建立登入頁面
→ 實作帳號驗證
→ 建立 Session/登入狀態
→ 實作登出
→ 實作 Session Timeout
→ 設定 Cookie 安全屬性
→ 測試未登入能不能直接存取內頁
我這個平台預計會串企業既有的 AD 做身分驗證,本身不儲存使用者密碼。這樣應用程式本身就不用再處理密碼怎麼儲存、怎麼雜湊、怎麼加鹽、密碼複雜度與更換政策等問題,這些交給企業既有的身分驗證機制統一管理。
但如果你的系統真的必須自己保存密碼,那第一個原則就是:不要自己發明密碼機制。
密碼不能明碼存,但也不是像我遇過有廠商回我說:「我系統很安全,我有用 SHA256。」然後問他,他說他就把密碼 SHA256 存進資料庫。
密碼儲存應該使用專門為密碼設計的 Password Hashing,例如 Argon2id、bcrypt,或直接使用成熟框架提供的密碼儲存機制。能不自己造輪子,就不要自己造。
帳號密碼驗證成功,只代表「知道你是誰」,後面還有 Session。
例如登入成功之後,要重新產生 Session ID,避免 Session Fixation。Cookie 也要依實際架構設定適當的安全屬性,例如 HttpOnly、Secure、SameSite。
接著還要想:Session 多久過期?使用者登出之後,原本的 Session 真的失效了嗎?閒置多久要重新登入?
如果使用 Cookie 維持登入狀態,會改變伺服器狀態的操作,例如新增、修改、刪除、審核,有沒有適當的 CSRF(Cross-Site Request Forgery) 防護?
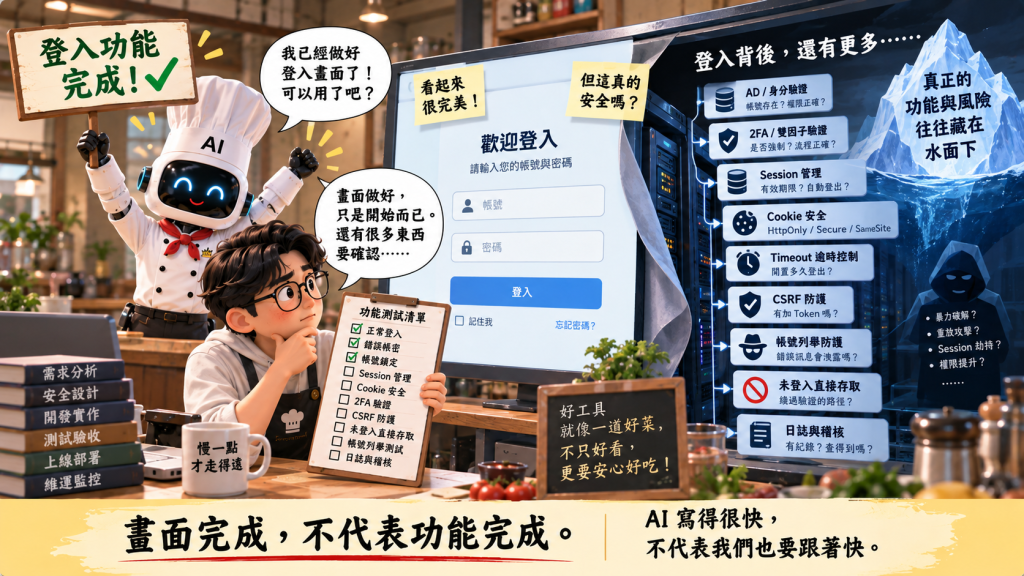
所以:「登入做完了」跟「有一個登入畫面」是兩件完全不同的事情。
密碼正確,就可以直接進系統嗎?我預計這個系統不會自己保存一套帳號密碼,而是使用企業既有的 AD 做身分驗證。但這裡還可以再深入思考一下:AD 驗證成功,代表帳號密碼是正確的,但要不要光靠帳號密碼就直接進入這個系統?
如果這個系統本身具有比較高的權限,或裡面有上傳、審核、發布、管理等重要功能,我還可以在應用程式這一層再增加一道 2FA(Two-Factor Authentication,雙因子驗證)。就會變成:
企業 AD 帳號密碼驗證 → 第二因素驗證 → 建立登入 Session → 進入系統
也就是說,第一層身分驗證還是使用企業原本的帳號流程。帳號是否存在、密碼是否正確、密碼政策、帳號停用等事情,都繼續交給企業既有的身分驗證機制管理,我的應用程式不用再自己維護一份密碼。但 AD 驗證成功之後,平台可以再要求第二個因素,例如 TOTP 驗證碼、Passkey、FIDO2 Security Key,或企業既有且適合整合的第二因素驗證方式。
這樣即使某個人的 AD 帳號密碼真的因為釣魚、重複使用或其他原因外洩,攻擊者拿到帳號密碼之後,還不能直接進入這個平台。
這也是我覺得做企業內部工具時很重要的一個觀念:能用企業既有的身分驗證,就不要自己再做一套帳號密碼。但「使用既有帳號驗證」也不代表安全設計到這裡就結束了,還是要依照系統本身的風險,繼續考慮:這個系統只靠帳號密碼夠不夠?重要角色要不要再做第二因素驗證?高風險操作要不要重新驗證?
例如一般使用者只是瀏覽 Portal,和管理員要進 /admin 修改權限、核准發布,風險其實完全不同。甚至可以進一步考慮:一般功能完成登入即可,高權限功能或敏感操作再要求額外驗證。
還有一個很小,但很常見的細節。登入失敗時,不要一個回「此帳號不存在」,另一個回「密碼錯誤」。因為這等於免費提供一個帳號查詢功能。
攻擊者輸入帳號 A:「此帳號不存在。」輸入帳號 B:「密碼錯誤。」那他馬上就知道 B 是存在的帳號。這就是帳號列舉(Account Enumeration)。
所以對外可以統一回:「帳號或密碼錯誤」。至於真正失敗的原因,可以依照需要記錄在適當的內部 Log,供管理與調查使用。
這也是我現在做 Vibe Coding 時很常用的一個方式。不要只測「正常使用者能不能登入?」,還要故意做一些不正常的事情。例如:
沒登入,直接輸入內頁網址會怎樣?登入後把 Session Cookie 拿掉會怎樣?登出之後,原本的 Session 還能不能用?Session Timeout 之後,原本的 API 還能不能呼叫?一直輸入錯誤密碼會發生什麼事?登入失敗時,能不能從錯誤訊息猜出哪些帳號真的存在?
因為驗收不是只有「應該成功的,有沒有成功?」,還要測:「不應該成功的,有沒有真的失敗?」
這個 Phase 主要就在處理:Authentication Failure、Session Management、Account Enumeration、Brute Force 等問題。
所以今天其實只有說了兩個 Phase。
Phase 1:先讓系統用比較安全的方式打好地基 Phase 2:確認登入進來的人到底是誰。
看起來進度好像很慢。但這也是我為什麼不太喜歡一句「幫我把整個系統做完」。
因為如果只看畫面,AI 可能幾分鐘就可以生一個登入頁給你。帳號輸入、密碼輸入、按下登入、跳到首頁。看起來:登入功能完成 但真正拆開之後,後面其實還有 Session、Cookie、Timeout、CSRF、暴力登入、帳號列舉,以及一堆要驗證的東西。
AI 寫得很快,不代表我們也要跟著快。
而做到這裡,我們其實也只回答了一個問題:「你是誰?」
下一個問題才真正麻煩:「你可以做什麼?」
一般使用者、開發者、審核人員、管理員,登入的是同一套系統,但可以看的資料、可以操作的功能完全不同。而且「分權」不是把按鈕藏起來就算完成。看不到管理按鈕,不代表不能直接輸入 /admin。看不到別人的資料,也不代表把網址裡的 id=123 改成 id=124 就拿不到。
這些都屬於 Broken Access Control(存取控制失效) 的範疇;其中透過修改物件 ID,就能存取原本不該存取的其他資料,是常見的 IDOR(Insecure Direct Object Reference) 情境。
而 Broken Access Control 也正是 OWASP Top 10 長期非常重視的 Web 應用程式安全問題。


 iThome鐵人賽
 看影片追技術