
前面最後提到了一個問題:登入的是同一套系統,不代表每個人可以做的事情都一樣。
一般使用者、開發者、審核人員、管理員,都有自己的角色與權限。而且昨天也留了兩個例子:看不到 /admin 的按鈕,不代表不能直接輸入 /admin;看不到別人的資料,也不代表把 id=123 改成 id=124 就拿不到。
所以從這裡繼續
登入完成之後,接下來要處理的就是:你已經登入了,但你到底可以做什麼?
→ 定義系統有哪些角色
→ 定義每個角色可以看什麼、做什麼
→ 建立角色與權限
→ 實作後端權限檢查
→ 實作不同角色的功能權限
→ 測試一般使用者能不能直接輸入網址繞過限制
→ 測試修改參數後能不能看到或操作別人的資料
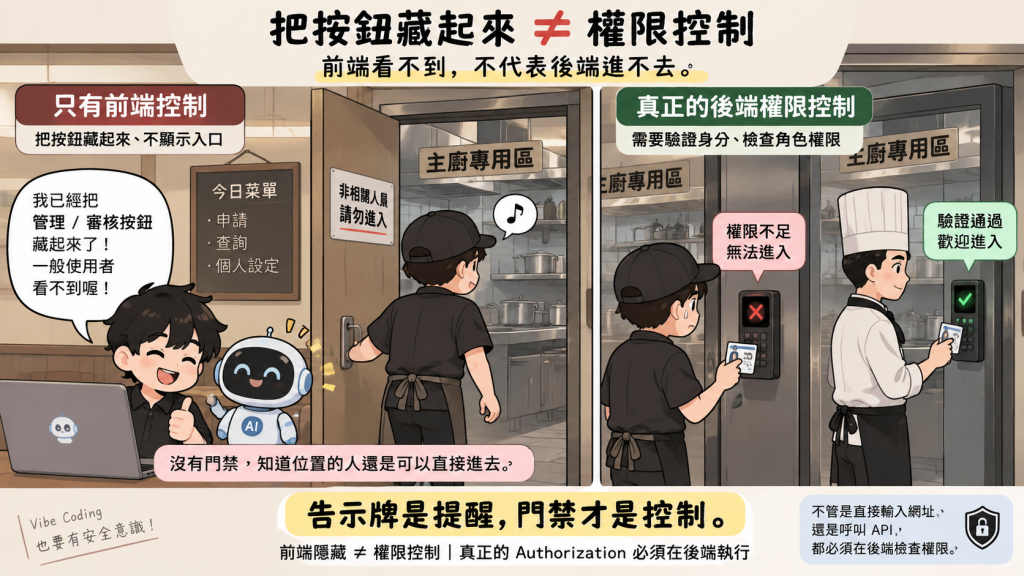
前面提到:把按鈕藏起來,不叫做分權。
例如一般使用者登入之後看不到「審核」按鈕,看起來好像沒問題。但如果他直接在瀏覽器輸入 /admin/review,結果頁面還是開得起來,那這個「隱藏按鈕」其實沒有什麼安全效果。
甚至頁面真的擋住了,但他直接呼叫 POST /api/review,結果後端照樣執行,那問題就更大了。
因為前端隱藏功能只是 UI 層的呈現控制,不是真正的存取控制。真正決定**「你到底可不可以做這件事情?」**的一定是後端。
另外一個例子就是前面提到的 IDOR:/document?id=123 改成 /document?id=124,結果別人的資料就跑出來了。
為什麼會這樣? 很可能是後端只做了:「收到 id=124 → 去資料庫找 124 → 回傳資料。」
但是少問了一個很重要的問題: 「現在登入的這個人,有權限看 124 嗎?」
所以真正的權限控制,我會要求每一個重要操作在後端收到 Request 時,都重新確認三件事情:
舉幾個例子來看
今天有一個人只是一般的申請人員,他原本只能看到自己的案件 id=123,但他把網址改成 /document?id=124 之後,竟然可以看到別人的案件,甚至還可以編輯、刪除、取消或審核,那就是很嚴重的權限控制問題。
但問題還不只「一般人看到別人的資料」。
假設今天這個人本來就有「審核」功能的權限,代表他所有案件都可以審嗎? 理論上應該是不一定。
例如他是某個部門的主管,可能只應該審核自己部門的申請;如果他把案件 ID 改掉,就可以審核其他部門的案件,一樣有問題。
但如果今天登入的是全企業層級的主管,依照系統原本定義的權限,他可能就真的可以審核不同部門的案件。
所以後端不能只確認:「他是不是 Reviewer?」
還要繼續確認:「這一筆案件,是不是他有權限處理的案件?」
這就是為什麼不是只檢查 「能不能審核?」,還要再檢查 「能不能審核這一筆?」
Authentication → Authorization → Object-level Authorization
三個都通過,才真的執行。任何一個沒有通過,就拒絕。
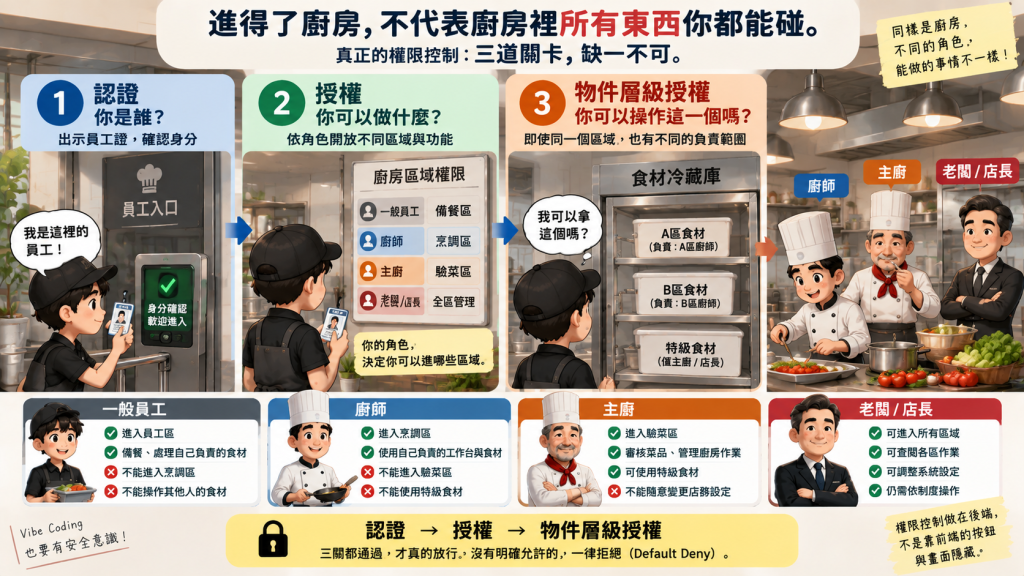
這裡還有一個我自己很喜歡的原則:Default Deny(預設拒絕)。
以前在設定防火牆政策的時候,其實就很熟悉這個概念:沒有明確允許的流量,一律拒絕。
而不是反過來,「只要我沒有寫規則擋你,你就可以通過」。
這兩個思維看起來只是反過來講,但實際執行的時候會差很多。套到系統權限其實也是一樣。
假設今天系統新增了一支 API,但開發的時候忘記設定權限。如果原本的設計是「沒禁止就可以用」,這支新的 API 就可能直接被放行。
反過來,如果系統採用 Default Deny,那新的功能在沒有明確設定「哪些角色可以使用」之前,本來就不能使用。
這對 Vibe Coding 我覺得尤其重要,因為 AI 寫功能的速度真的很快。今天多一個頁面,明天多三支 API,如果每增加一個功能,都要靠人記得「這支記得封起來」,遲早會有忘記的一天。
這其實跟防火牆的概念沒有差太多:不是一直想著還有什麼東西忘記封,而是先全部擋住,再把真正需要的東西一個一個打開。
與其期待每次都記得禁止,不如一開始就預設不准。
這也是 Vibe Coding 時我覺得要特別注意的地方。
你跟 AI 說:「一般使用者不能看到審核功能,只有 Reviewer 可以。」
AI 很可能很快就幫你寫好判斷,不是 Reviewer 就不顯示「審核」按鈕,然後跟你說:
「角色權限控制已完成。」
畫面看起來也真的完成了。
但要確定的是:如果使用者不是按那個按鈕呢?
我直接輸入網址呢?直接呼叫 API 呢?自己修改 Request 呢?
如果這些方法可以繞過前端的限制,那個「看不到的按鈕」根本沒有保護任何東西。
所以前端的權限判斷可以保留,因為它可以讓不同角色看到適合自己的操作介面。但它的用途主要是改善使用體驗。
前端負責讓你「看不到不該用的功能」,後端才負責讓你「真的用不了不該用的功能」。
昨天 Phase 2 已經提過,除了測正常流程,會故意去測那些「不應該成功」的操作。
到了分權這個 Phase,我測的東西就更明確了:想辦法越權。
例如:
/admin,能不能進去?id=123 改成 id=124,能不能看到 B 使用者的資料?這時候我要驗證的,其實就是前面講的三層控制:
Authentication → Authorization → Object-level Authorization
尤其最後一層很容易漏掉。因為「這個人有這個功能的權限」,不代表「這個人對所有資料都有這個權限」。
所以 Phase 3 做完,我不是再確認一次按鈕有沒有藏好,而是要確認:
就算我知道網址、知道 API、知道資料 ID,我還是做不了超出自己權限的事情。
這個 Phase 主要就是在處理:Broken Access Control、IDOR、水平越權、垂直越權。
分權處理完之後,下一步就是我這個平台原本規劃的一個重要功能:
讓已經登入、而且有權限的使用者上傳自己的靜態網頁。
前面有提過,我希望把原本散落在外面的內部小工具慢慢收回來管理。例如原本有人把自己做的 HTML、CSS、JavaScript 靜態網頁放在 GitHub 或其他地方,未來可以把這些檔案移轉到這個平台,由平台統一管理。
所以對我的平台來說,「檔案上傳」不是附加功能,而是整個流程裡很重要的一環。
但也因為這樣,我認為這會是整個平台攻擊面非常大的一塊。
前面的登入與分權,大部分是在處理: 「誰可以進來?進來之後可以做什麼?」
到了這裡,就會多了一個更重要的問題: 「進來的人,可以把什麼東西丟進我的系統?」
因為我允許上傳的不是單純的圖片或 PDF,而是可能包含 HTML、CSS、JavaScript 的靜態網站內容。換句話說,我不是只讓使用者「存一個檔案」,而是準備接收之後可能會被瀏覽器解析、甚至執行的內容。
所以這個 Phase 預計要處理:
→ 建立上傳功能
→ 定義允許上傳的檔案與網站結構
→ 限制檔案類型與大小
→ 處理檔名與路徑
→ 決定檔案儲存位置
→ 建立上傳檔案與版本紀錄
→ 控制誰可以上傳、下載、刪除
→ 測試能不能透過修改網址或參數取得別人的檔案
AI 做上傳功能時,很容易快速完成: 選擇檔案 → POST → 後端存起來
然後告訴你: 「上傳功能完成。」
從功能面來看,它可能真的完成了,檔案選得到、傳得上去、伺服器也真的收到了。
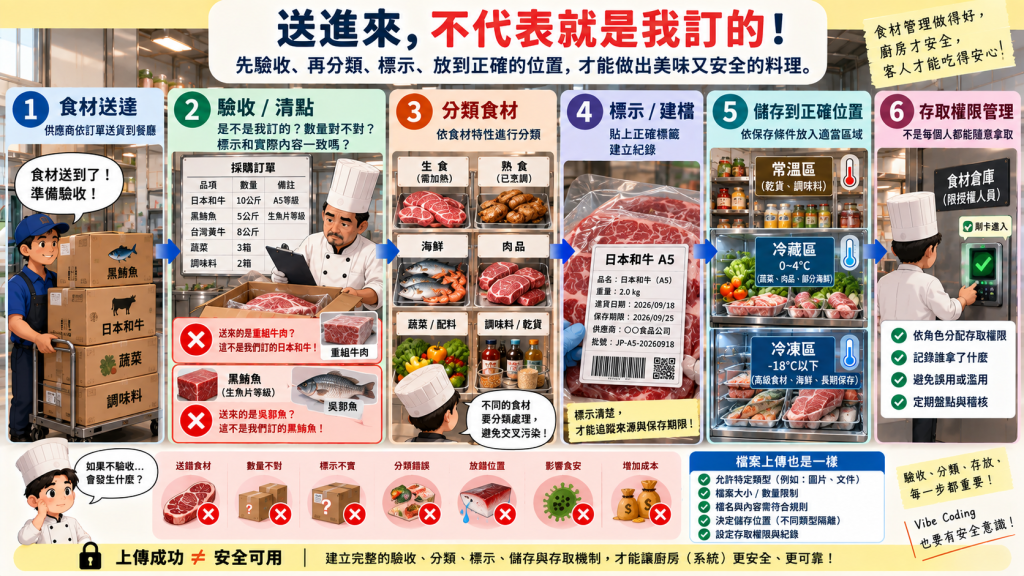
但對我來說,檔案成功傳進伺服器,只能證明 Upload 功能正常,但不代表這個 Upload 是安全的。
真正麻煩的事情,現在才要開始。
.jpg 不一定真的是圖片第一個問題就是檔案型別。
如果我把 test.html 改名成 test.jpg,它不會因為副檔名變成 .jpg,就真的變成一張圖片。
所以檔案型別不能只看副檔名,瀏覽器送過來的 Content-Type 也不能完全相信,因為這些都是來自使用者端的資訊。
比較完整的做法,依照系統需求做多層檢查:
副檔名白名單 + MIME Type + Magic Bytes/實際檔案內容 + 後續安全掃描
而且只開放系統真的需要的格式。如果這個系統只需要圖片,就不要因為「以後可能會用到」,順便把 ZIP、HTML、SVG、EXE 全部開起來。
但這裡也要注意:Magic Bytes 驗證通過,不代表檔案就是安全的。
它比較像是在確認「你說你是 JPG,看起來是不是真的像 JPG」。
至於裡面有沒有惡意內容,或這個檔案到底安不安全也是必須確認的,我預計後面來處理。
第二個很容易忽略的是:檔名本身也是外部輸入。
假設後端直接把使用者提供的檔名拿去組路徑,又沒有妥善處理,就可能碰到 ../../something 這類 Path Traversal(路徑穿越) 問題。
所以比較安全的方式,是讓伺服器自己產生真正儲存使用的檔名或識別碼。至於使用者原本上傳的 我的工具.zip,可以另外記錄下來,作為畫面顯示使用。
也就是: 顯示名稱是一回事,真正存在伺服器上的名稱是另一回事。
再來是檔案到底放在哪裡。
如果使用者上傳的東西直接被放到 Web Server 可以執行程式的地方,那風險就會變得很高。
所以比較好的方式,是把上傳內容放在 Web Root 之外的獨立儲存位置,
並且限制 Web Server 不要把使用者上傳的內容當成程式執行。
這樣即使前面的檔案型別檢查真的被繞過,後面至少還有另外一道限制。
應用層檢查是一層,系統層限制再一層。
提供檔案下載時,也可以依照檔案用途設定適當的 Content-Type、Content-Disposition,並搭配 X-Content-Type-Options: nosniff 等控制,降低瀏覽器自行猜測內容型別所帶來的風險。
另外一個很容易出現的做法是,前端寫著:
「 限制每個檔案的大小 10 MB」
然後就覺得大小限制完成了。
但前端是使用者可以控制的,所以真正的檔案大小限制一定要在伺服器端做;依照實際架構,也可以在反向代理或 Web Server 再限制一次。
但事情還沒結束。
假設每一個檔案都真的小於 10 MB,有人一直上傳 10 MB、再 10 MB、再 10 MB,每一個檔案都符合規定,最後還是可以把磁碟塞滿。
所以除了限制「單一檔案可以多大」,還要考慮:
「你總共可以放多少?」
上傳空間最好有適當的容量限制或 Quota,必要時再使用獨立的儲存空間。不然最後掛掉的可能不只是上傳功能,而是整個系統。
最後還有一個很容易被忘記的地方:下載。
有時候上傳功能做了一堆權限檢查,結果下載變成:
/download?id=123 只要知道 ID 就可以拿。
那前面做半天的權限控制等於又破了一個洞。
如果 A 使用者把 id=123 改成 id=124,結果就可以下載 B 使用者的檔案,那其實又回到了 Phase 3 的 IDOR。
所以下載、刪除、重新上傳,一樣都要重新確認:「這個人有沒有權限操作這一個檔案?」
不是知道 URL 就可以拿。
跟前面的 Phase 一樣,不會只測「正常的檔案能不能上傳」,而是會故意開始亂搞:
把不允許的檔案改副檔名,能不能騙過?不允許的檔案格式能不能直接 POST 上去?超大檔案會怎樣?特殊檔名會怎樣?A 使用者能不能下載 B 使用者的檔案?上傳的內容會不會被伺服器當成可以執行的內容?
因為檔案上傳真正要測的不是: 「正常的東西能不能進來?」
而是: 「故意丟奇怪的東西進去,系統會怎麼處理?」
這個 Phase 主要是在處理:Unrestricted File Upload、Path Traversal、Stored XSS、DoS、IDOR。
看到這裡,可能有人會問:
「人自己開發也常常沒做這些啊?現在都交給 AI 了,我只要叫它幫我做好不就好了?我就是想要快、不想一直人工處理才找 AI,為什麼還要一個一個測試、一個一個確認?」
我覺得這其實是兩個問題。
如果今天是「人」本來就沒有做這些事情,那可能不在這篇討論的範圍,因為那比較偏向人的開發習慣、能力,或是組織本身的制度與流程問題。
我這裡比較想討論的是第二個問題:
既然都交給 AI 做了,為什麼還需要人確認?差別到底在哪裡?
這個問題其實可以再講很多,我後面找一天來說清楚。
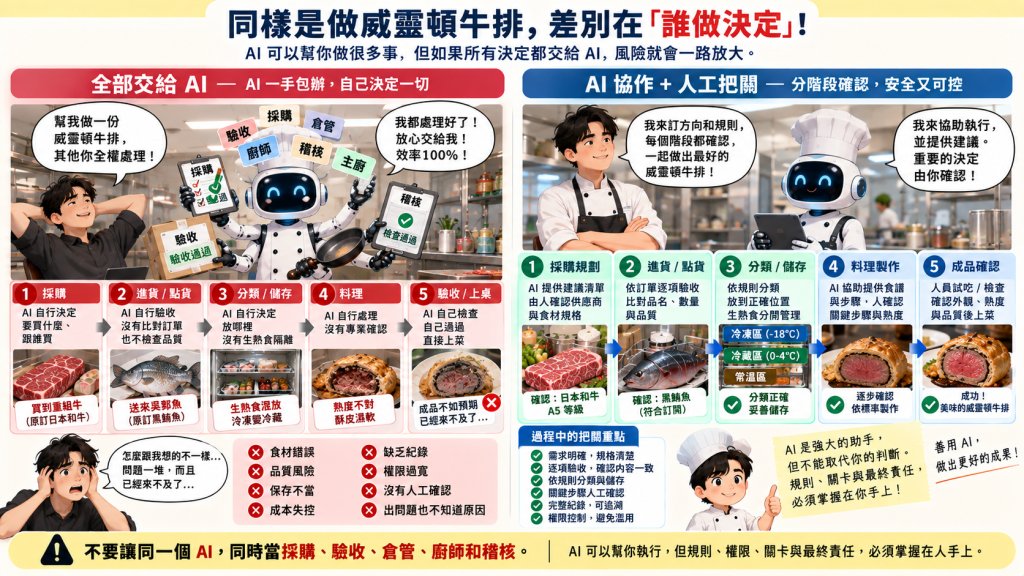
但還是先說一下,至少開發者應該要知道:
現在做出來的東西,跟我要的是不是同一件事?
原本要求的限制,有沒有真的做到?該擋的東西,有沒有真的擋住?
你下的prompt夠不夠精準,AI有沒有照著你的規範做?
前面幾個 Phase,其實就是都是在做這件事:
Phase 2 解決的是 「你是誰?」
Phase 3 開始處理 「你可以做什麼?」
Phase 4 又多了一個問題:「你可以把什麼東西放進我的系統?」
做到這裡,檔案已經可以進來了。
但又出現下一個問題:
「上傳成功」跟「這個檔案安全」,是兩件完全不同的事情。
所以檔案進來之後,我還不會讓它直接往下走。
下一個 Phase,我們才要開始處理:
這個被上傳進來的東西,到底該不該讓它繼續往下走?


 iThome鐵人賽
 看影片追技術