
決定試著做一套自己的 SDD workflow 後,第一個問題就是:要先做哪些東西,才能真的拿來用?我沒有一開始就把所有想法都加進去,而是先把已經用順的流程做出來,讓自己有一個可以實際操作、再慢慢調整的起點。
這套工具後來有了一個名字:Speclink。不過,在說第一版做了什麼之前,先聊一下這個名字,因為它也和我想做這套工具的原因有關。
Speclink 這個名字是 AI 提議的。當時的 link 指的其實是我想做的遠端協作:讓 PM/SA 與工程師即使使用不同的工具,也能接著同一份規格往下工作。只是這條路到我寫這篇鐵人賽文章時仍在測試,所以這裡先留個伏筆,等本機流程說完後再回來看。
當時比較適合先動手驗證的,是本機 workflow 裡的連結:不要讓 discussion、change、正式 specs、實作與驗證各自斷開,而是讓前後留下的內容可以一路接著使用。
先讓大家看看它後來慢慢長成什麼樣子。下圖是我寫這篇鐵人賽文章時的 Speclink Desktop,現在已經可以從變更看板查看 discussion 與 change 的狀態。
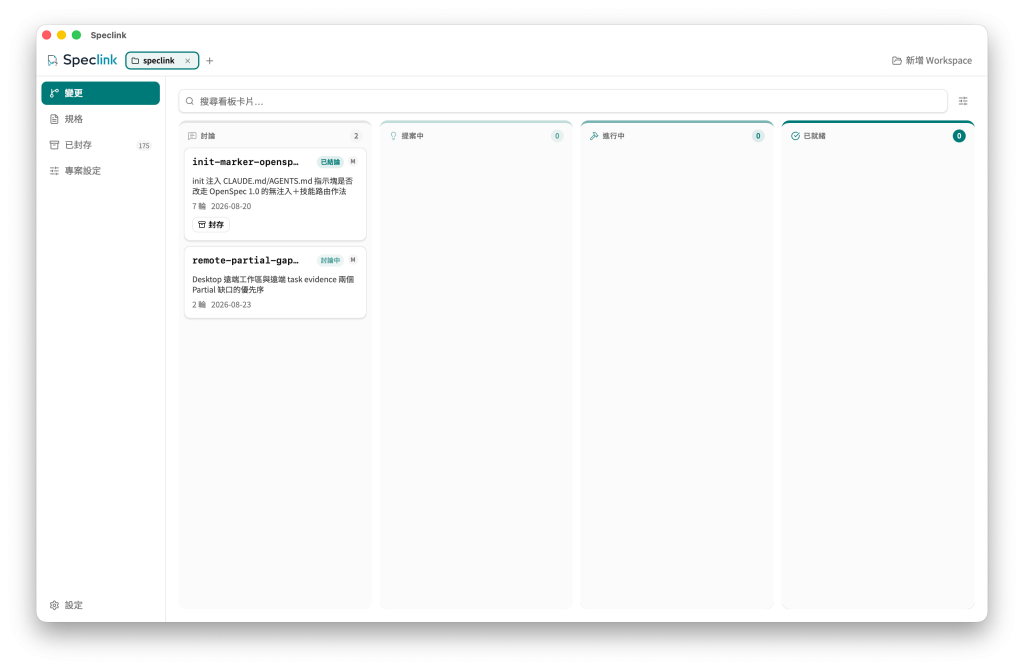
不過,圖裡的 Speclink Desktop 是後來才逐步發展出的介面,第一版還沒有這些東西。回到最初,光是本機 workflow 就有不少事情要做,我該怎麼決定第一版的範圍?
前面使用 Spec Kit 的經驗,已經讓我吃過一次範圍開得太大的虧。如果連 SDD workflow 自己的行為都還沒做穩,就同時處理太多新的流程與介面,中途出現問題時,我可能連是哪一段沒有接好都分不清楚。
因此,第一版先做一件比較單純的事:建立一條我已經熟悉,也可以拿來比對的 SDD workflow。
我很喜歡 Spectra 的流程,也用得很順,所以第一版想先照著這個方向做。不過,Spectra 的公開 repo主要提供說明、發行紀錄與安裝檔,沒有 App 與 CLI 的原始碼,沒辦法直接看它裡面怎麼寫。龍哥在 Spectra 2.0 的介紹裡提過,Spectra 是從 OpenSpec 的設計重新整理而來,因此我一邊研究 OpenSpec 的作法,一邊對照自己使用 Spectra 時看到的結果,先把熟悉的流程做出來。
參考的是哪個版本? 建立第一版 Engine 與 CLI 時,我參照的是 Spectra 2.3.1。後面提到沿用或調整 Spectra 的地方,都以這個版本為準。
不過,真的開始做之後,我只能說:我把事情想得太簡單了XD。
使用時,只要知道現在要進入 discuss、propose、apply 還是 archive;自己做工具時,卻連每一步背後的事情都要處理。proposal、specs、design 與 tasks 要存在哪裡?哪些文件要先寫好,才能建立下一份?交給 AI 的 instructions,又要怎麼把模板、專案設定與目前進度一起整理進去?
文件準備好之後,還要讓 AI 知道接下來能做什麼、遇到什麼情況該停下來。等到歸檔,又得把這次的規格變更更新回正式 specs,並保存 change 的紀錄。前面介紹工具時,我們已經看過這些步驟;但真的輪到自己做,才發現每一段都得接好,流程才能順利跑完。
這些事情都需要處理,但要全部交給 AI 嗎?還是有些動作可以直接寫成程式,讓工具每次都用相同方式完成?
開始做 Speclink 以前,我已經接觸過 Spec Kit、OpenSpec 與 Spectra。三套 SDD 工具的 workflow 各有不同,卻都搭配 CLI。這個共通點讓我很好奇:AI Agent 明明已經可以直接讀取、修改檔案,它們為什麼都選擇使用 CLI?難道只是因為工程師比較習慣在終端機打 command 嗎?
前面介紹 OpenSpec 與 Spectra 時,我們已經看過 Skills 會呼叫 CLI 取得目前狀態與 instructions。AI 當然也能自己打開 Markdown、修改 YAML,再把檔案存回去;只是這樣一來,每個 Agent 都得自己理解檔案放在哪裡、內容要用什麼格式,以及每一步有哪些限制。出錯時,也比較難分清楚,是 AI 理解錯了內容,還是在讀寫檔案時漏做了什麼。
換個方式想,如果不使用 CLI,而是把「changes 要去哪裡找」「下一份 artifact 能不能開始建立」「task 完成後要更新哪些資料」「archive 時 delta specs 怎麼合併」全部寫進 Skill,會發生什麼事?
這份 Skill 很快就會變成一大本操作手冊。每次換一個 Agent 或 session,都要再靠 AI 讀懂這些規則,然後逐步執行;只要少讀一條、順序做反,或對同一句話有不同理解,最後存下來的內容就可能不一樣。這些操作如果分散在不同 Skills 裡,之後要修改或測試,也得一份一份檢查。
CLI 則把這些固定步驟寫成可以重複呼叫的指令。例如列出 changes、取得下一份 artifact 的 instructions、更新 task 狀態、驗證格式或完成 archive,都可以由工具按照既定規則處理,再回報結果。Skill 則告訴 AI 什麼時候該呼叫、拿到結果後怎麼繼續,以及遇到什麼情況應該停下來詢問。
我覺得我們可以用開車來理解這三個角色:Skill 像導航,告訴駕駛接下來往哪裡走、什麼情況要先停下來;AI Agent 像駕駛,理解目的地、判斷路況,處理需要思考與判斷的事情;CLI/Engine 則像車子的控制系統與儀表,按照操作執行動作,再回報成功、失敗與目前狀態。
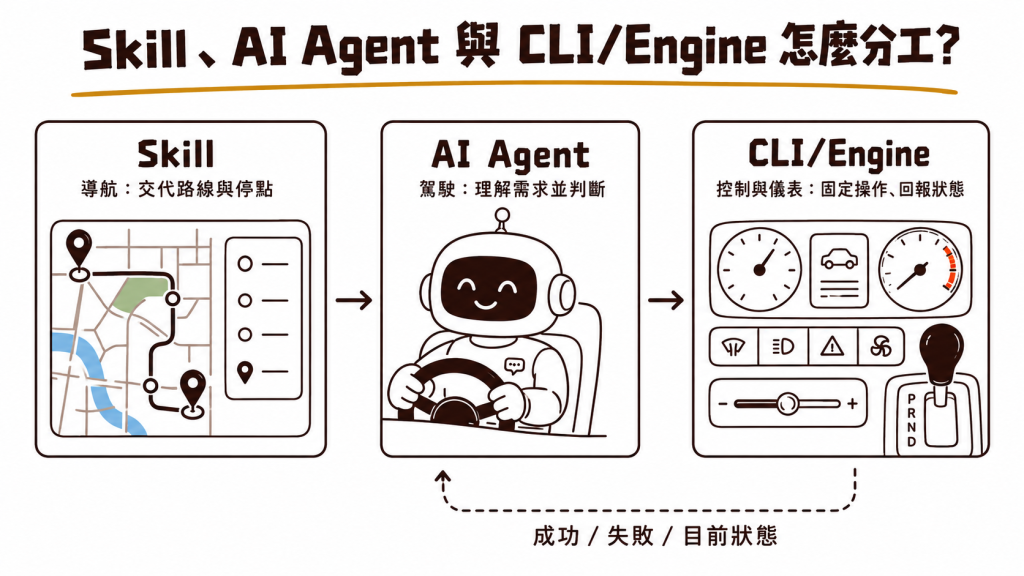
如果自己做過 AI Agent,多少也會碰到 Tools 怎麼接的問題吧!CLI 給我的感覺,也像一個沒有直接寫死在某套 Harness(讓 AI Agent 呼叫 Tools 的執行框架)裡的 Tool。只要 AI Agent 能夠執行 command,Claude Code、Codex、CI,甚至工程師自己都能共用同一支 CLI,不必為了換一個入口,就重新實作 change 該怎麼讀寫、驗證與更新。當然,使用前還是要先安裝 CLI,並允許 Agent 執行 command。
這裡真正重要的不是終端機畫面,而是中間有一層清楚的操作契約。CLI 可以透過 --json 回傳結構化資料,並提供 exit code 與分開的 stdout/stderr,Agent、測試與 CI 都能用相同方式判斷這一步成功還是失敗。比起只在 prompt 裡寫「記得不要改錯檔案」,有明確的動詞與驗證結果,後續也比較容易測試和追查。
CLI 也不是萬靈丹: 如果需求本身還沒談清楚,或 AI 判斷錯了要修改哪一條規格,CLI 不會突然替我們做出正確決定。它能守住的是狀態、格式與操作邊界;需要理解內容的部分,仍然要由 AI 和人一起處理。
回頭看完這層分工後,我才比較理解前面幾套工具為什麼都搭配 CLI。重點不是要求每個使用者都得打 command,而是把固定、可以驗證的操作收在同一個地方。這樣 Skill 不必背著整套檔案處理規則,AI Agent 也能把力氣留在需求、規格與 code 的判斷上。
確定底層先由 CLI 承接,並把 workflow 的固定動作接起來後,我才開始回頭處理自己最常遇到的使用問題。第一個就是 discuss:我常常一口氣談了 5~10 個主題,過一段時間回來後,連自己都忘了前面談過什麼XD。下一篇,就從這個困擾開始吧!


 iThome鐵人賽
 看影片追技術