

本篇目的:了解如何將表格資料輸出成 csv,以及將不同資料輸出到同一個 xlsx 檔案內
“存檔“絕對是資料處理的一個重要環節。實際上我們在確認檢測資料時,大多是輸出成csv/ xlsx這兩種格式,兩個檔案格式的比較如下:
| 格式 | csv | xlsx |
|---|---|---|
| 檔案大小 (同資料量) | 較小 | 較大 |
| 寫入速度 | 較快 | 較慢 |
| 最大可儲存資料數 | 無限,看硬碟空間 | 約100萬行 |
| 格式保存 | 就是逗號分隔檔,無法儲存格式 | 可以儲存文字顏色、儲存格顏色等 |
| 適用情境 | 中途資料,後續還會使用其他東西分析 | 最終結果,下一步就是投影片等最終呈現的情境 |
以我們(半導體工程師)的使用情境來說兩種資料格式都會使用到,有可能是輸出 csv 後上拋 MES 系統或是用其他軟體作業;又或是輸出 xlsx 檔後為週會報告做準備。在這裡我會介紹2種儲存 data 的方式,也會介紹將流程封裝成函式 (function) 的方法,為後續建構可維護、可重複使用之模組做準備。
Pandas 輸出 csv 檔的方式非常簡單,只要使用 to_csv 並傳入需存檔路徑即可。
要注意的是傳入的路徑需要包含檔名,例如 a.csv 。另外若需要存成特殊的副檔名(但本質上還是 csv),只要將副檔名改成其他字樣即可。
pathlib是一個管理路徑的模組,而Path就是裡面管理路徑的類別 (class)。特別使用Path管理路徑的的原因是因為它有許多關於路徑的好用功能,例如抓出檔名等。
from pathlib import Path

# 設定存檔路徑
# "save_path"為Path物件,就是想存檔的路徑
# df_a_data 是一張 dataframe

# Path 物件後加上 "/字串",可以將這串文字加入到路徑中
save_csv_path = save_path/'a.csv' # 注意存檔路徑須包含檔名
df_a_data.to_csv(a_save_csv)

save_cat_path = save_path/'a.cat'  # 副檔名被改成"cat"了
df_a_data.to_csv(save_cat_path) # 將"'a.cat'"存在指定路徑
若單純地將一張 dataframe 或 series存成 xlsx 檔也非常簡單。跟輸出 csv 類似,只要使用 to_excel 即可。
save_xlsx_path = save_path/'a.xlsx' # 注意存檔路徑須包含檔名
df_a_data.to_excel(a_save_xlsx)
若我們要輸出成 xlsx 檔時通常都是要做報告了,此時一定會需要將資料整理成不同格式,再將表格整理到報告中。因此若能在程式中就將不同表格分門別類到同一檔案內,可以省下很多剪貼時間來更專注在資料呈現上。
若要指定 dataframe 儲存到特定 sheet,在 to_excel 中傳入 sheet_name=sheet名稱 即可。
但因為我們要將多張 dataframe 存入單一 xlsx 中的不同 sheet 中,因此需要建立一個 pd.ExcelWriter 物件,並將它稱為 writer。 writer 是讀寫器,可以管理dataframe寫入的行為。
此處使用 with ,再將需要儲存的 dataframe 以 for loop 方式指定給讀寫器 writer 。使用 with 的好處是跑完迴圈後會自動將讀寫器關閉、並且儲存檔案,避免程式執行完畢後讀寫器仍作用,造成後續開啟檔案的異常。
# 注意存檔路徑須包含檔名
all_df_in_axlsx = save_path/'all_in_one_xlsx.xlsx'

# 先將這些 dataframe 整理到 list 內
all_df_list = [df_a_data, df_b_data, df_c_data]

# 使用"sheet_name="即可指定要貼上的 sheet 名稱
with pd.ExcelWriter(all_df_in_axlsx) as writer:

    for i, df in enumerate(all_df_list, start= 1):

        # 指定用writer寫入df
        df.to_excel(writer, sheet_name= f'sheet {i}')
通常同一張 sheet 有多表格時,表格之間一定會有空白列,我們可以使用 startrow=指定列數 來指定要從哪一列開始貼上。另外我們可以在 for loop 中加上平移值,讓每個表格之間有間隔幾列。
all_df_in_asheet = save_path/'all_in_one_sheet.xlsx'

with pd.ExcelWriter(all_df_in_asheet, engine='xlsxwriter') as writer:

    row_count = 0 # 列數計數器

    for df in all_df_list:

        len_df = df.shape[0] # 取得該df之列數
        df.to_excel(writer, sheet_name="Sheet1", startrow=row_count)
        row_count = row_count + len_df + 3 # 下一個df會從這一個df的下面'3'列開始貼
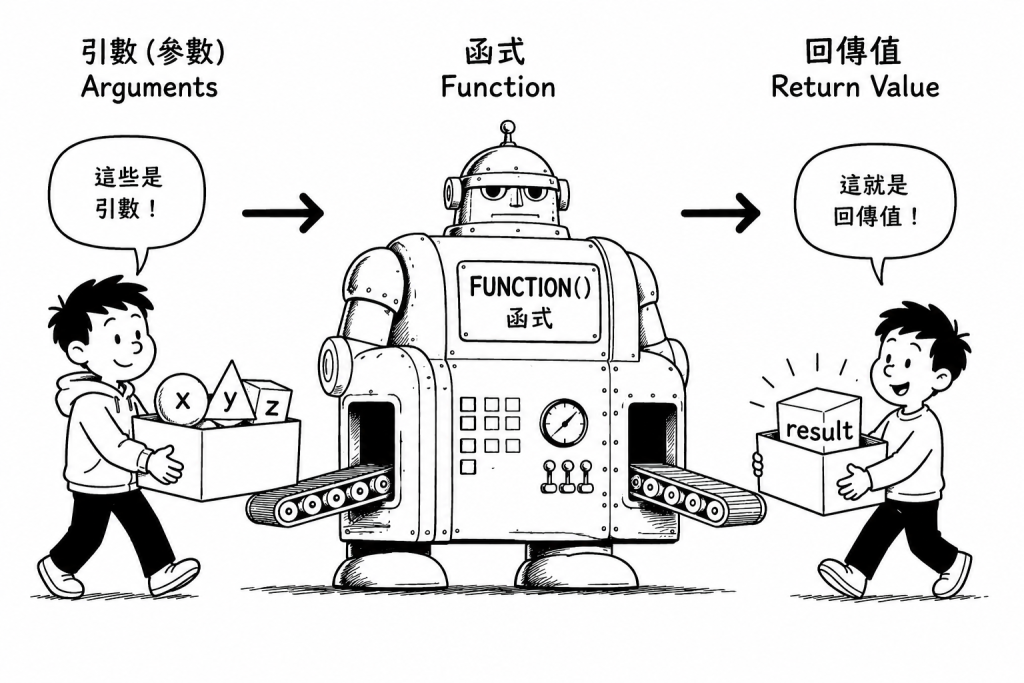
存檔是一定會執行的行為,所以若每次開新專案就要輸入一次上述的指令的話非常浪費時間。因此我們可以將常用指令改寫成函式 (function),而函式的主要結構是 def 名稱(引數) 與內部的運算邏輯。函數的使用方式是設定好後直接在檔案內呼叫、並傳入引數即可,可以想像成將材料(引數)丟入機器中,機器依照設定對材料做處理,最後輸出成品(回傳值)。
若以上面的存檔行為舉例,我希望 function 能夠同時支援多表格輸出到不同張 sheet、以及輸出同一張 sheet 並有空格,因此我設計 function 的流程如下:
設計資料格式可以同時存放"輸出的 sheet 名稱”以及”需輸出的 dataframe”,而且”需輸出的 dataframe”可能是單個也可能是多個
多個dataframe的話需放入一個 sequence 成為一個單一物件。我這裡選用 list,因為編輯較方便
因此傳入 function 的 arguments (引數,後面簡稱 Args)會選用 dict,並且將”sheet 名稱”作為 dict 的 key,而”輸出的 dataframe”作為 dict 的 value。另外若需要單 sheet 有多表格,我會以list的方式傳入
# 定義要輸出的資料結構
# key 為 Sheet 名稱,value 可以是單一 DataFrame 或一個 DataFrame 清單 (List)
all_df_dict = {
    'Summary': df_summary,               # 單一表格
    'Wafer_Details': [df_w1, df_w2]      # 多個表格放在同一張 Sheet
dict 內的東西都需要處理,因此使用 for loop 遍歷裡面所有項目。
此外我們有兩個可能的存檔形式(dataframe: 單表寫入單張/ list[dataframe]: 多表寫入單張 ),因此我們需要使用 isinstance 方法來判別 dict 的 value 形式達成分流效果
with pd.ExcelWriter(save_axlsx, engine='xlsxwriter') as writer:

    # 遍歷所有引數內的項目,並分出 key 與 value
    for s_name, content in all_df_dict.items():

        # 模式 A:若內容是 List,代表要將多個表格存在同一張 Sheet 內
        if isinstance(content, list):
            row_count = 0  # 初始化列數計數器
            for df in content:
                # 取得該 df 之列數,並指定從 startrow 開始貼上
                df.to_excel(writer, sheet_name=s_name, startrow=row_count)

                # 計算下一個表格的起始位置:當前列數 + 表格長度 + 間距
                len_df = df.shape[0]
                row_count = row_count + len_df + row_spacing + 1 # 加上標題列與間距

        # 模式 B:若內容是單一 DataFrame,則直接存入指定 Sheet
        elif isinstance(content, pd.DataFrame):
            content.to_excel(writer, sheet_name=s_name)
將以上項目組合在一起,就是一個完整的 function,這個 function 可以在各種需要存檔的場合重複使用。實際 function 的結構如下:
def to_excel_flexible(data_dict:dict[str,list[pd.DataFrame] | pd.DataFrame], save_path:Path,*, space_row:int = 3):
    """
    將須輸出資料以{sheet名稱:資料}傳入後,可以輸出成一張xlsx檔

    Args:
        data_dict:{sheet名稱:資料},資料會存在指定名稱之sheet內。\n
        若資料以list[pd.DataFrame] 形式傳入,會把這些df存在同一張sheet內
        save_path: 存檔路徑
        space_row: 同一張sheet內,df之間的列間距

    """
    with pd.ExcelWriter(save_path,engine='xlsxwriter') as writer:

        for s_name, content in data_dict.items():

            print(s_name)

            if isinstance(content,list):
                row_count = 0 # 初始化列數計數器

                for df in content:

                    df.to_excel(writer, sheet_name=s_name, startrow=row_count)

                    # 計算下一個表格的起始位置:當前列數 + 表格長度 + 間距
                    len_df = df.shape[0]
                    # 加上標題列與間距
                    row_count = row_count + len_df + row_spacing + 1

            elif isinstance(content, pd.DataFrame):
                content.to_excel(writer, sheet_name= s_name)
我們在工作中一定碰過大大小小的專案。專案規劃前會先確認專案目的與期限、然後盤點可用資源,然後才是列出執行細節。專案執行中也有可能因為需求或可用資源改變,導致要回頭修改執行方式。我們執行專案並且動態調整執行方式,最後達到專案成果。並且若該專案會重複執行,會將執行方式寫成 SOP 方便未來執行。
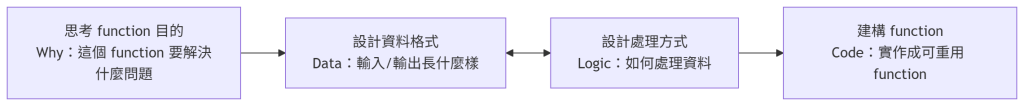
建構 function (又或是整個程式設計) 的思考模式其實跟專案非常相近,先確認這個 function 的目的、確認會傳入的資料以及適合的資料結構、然後設計執行流程,流程設計時又可能回去改資料結構。最後當流程確定時,才建構 function,讓未來有需求時可以實際調用。
Function 建構的方式如下圖:
除了表格外,mapping 圖也是很常用的呈現形式


 iThome鐵人賽
 看影片追技術