
上一篇,我先把 MVP 的範圍收斂下來,也列出了第一版需要的功能。
我的產品流程大概是:
和 ChatGPT 練習 → 產生適合自己的英文 → 切成 chunks → Shadowing
一開始,我其實想先做前面的 AI 功能:讓使用者跟 ChatGPT 練習,再把對話整理成可以拿來練習的英文。
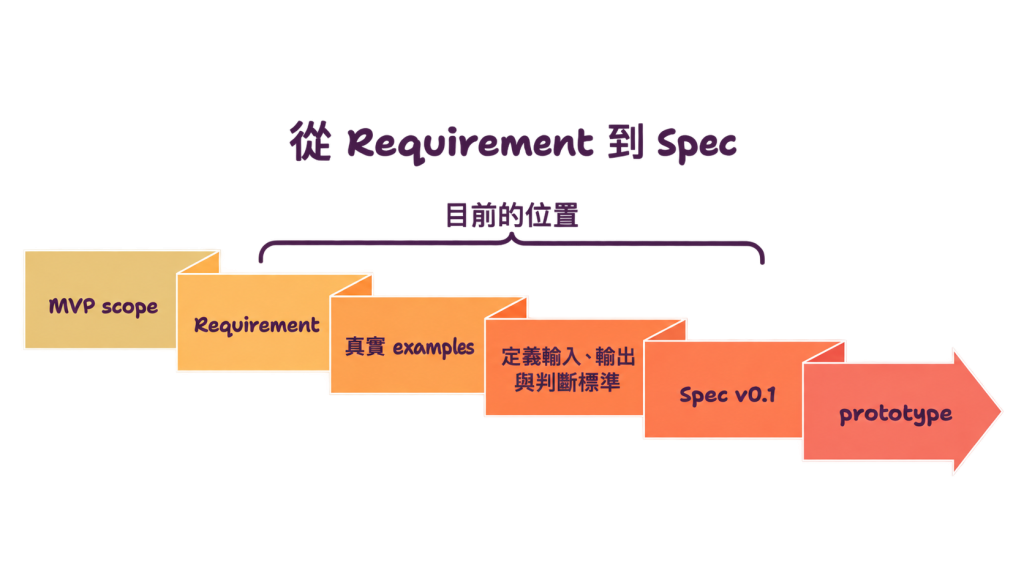
但列出 Requirement,只代表我知道「要做什麼」,還不代表我已經知道它實際應該怎麼運作。
像「把英文自動切成適合練習的 chunk」看起來已經是一條 Requirement,但真的要開始實作,還是得先回答:什麼叫做適合練習?切在哪裡才算切得好?最後要產生什麼樣的結果?
我不打算一次把整份 spec 寫到完美,而是先挑一個最直接影響練習體驗、定義又最模糊的功能來釐清。所以,我把順序調了一下:先從 chunking 開始。
原因很簡單:它會直接影響練習品質。
如果系統產生了一句很自然的英文,卻把它切成一些奇怪的片段,使用者就算每一段都跟著念了很多次,最後還是不一定能自然地把整句話說出來。
而且 chunking 聽起來很簡單。
不就是「切」嗎?
我原本對 chunking 真的沒有想太多。
可能按照標點符號切,句子太長的話再切小一點。看起來應該寫幾條規則就可以開始做了。
但真的準備實作時,第一個問題就出現了:
到底切在哪裡,才叫做切得好?
我先拿了幾個自己以前真的遇過的英文情境,試著人工切一次。
其中一句是:
I'm here to / renew my health card.
如果按照自然語流來看,我其實不應該在 to 後面停下來。
但我發現自己會想這樣切,是有原因的。
因為對正在學英文的我來說:
I'm here to + ______
本身就是一個很好用的句型(pattern)。
今天可以是:
I'm here to renew my health card.
下次也可以變成:
I'm here to pick up my package.
或是:
I'm here to ask about my application.
所以我把 I'm here to 單獨切出來,不是因為這是自然說話時應該停頓的位置,而是因為我想把它當成一個可以重複使用的句型學起來。
為了確認這樣切是否合理,我開始查英文口說和 Shadowing 的資料,這才遇到一個概念:thought groups(意群)。
Iowa State University 的英語口語教材 把 thought group 定義為一段能形成完整訊息的語流,通常具有語法與語意上的完整性,前後可能有停頓,也會有一個突出的重音和相應的語調輪廓。教材也特別提醒,句子並沒有唯一、固定的切法;說話速度、語意和情境都可能改變分組方式。
如果把剛才的句子視為一個 thought group,練習時會整句連起來,而不是切在 to 後面:
I'm here to renew my health card.
這跟我一開始手動切的位置不一樣。
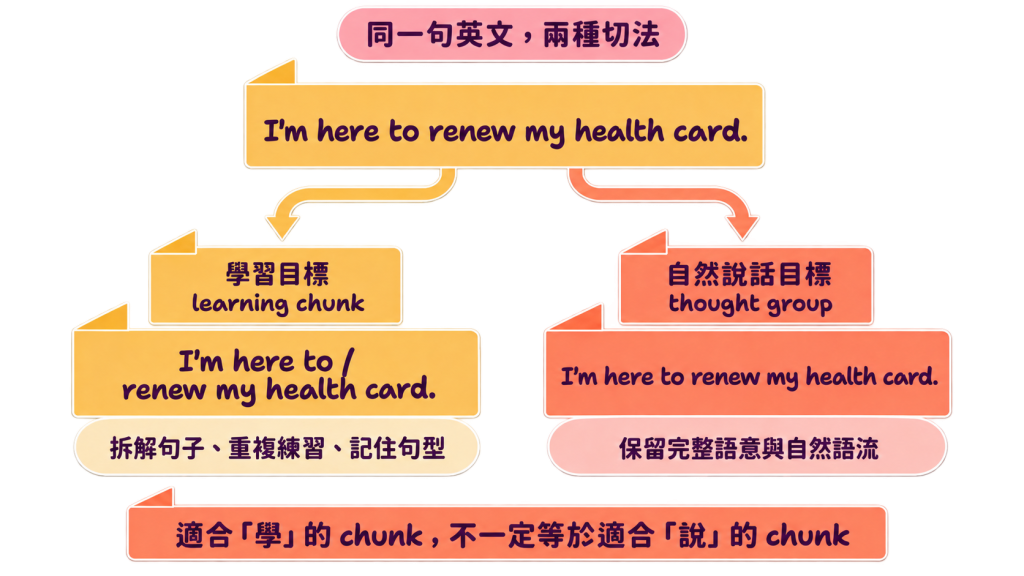
這時我才發現,我原本說的「chunk」其實混在一起了兩件不同的事情。
如果目的是降低剛開始練習的負擔,我可能希望 chunk 小一點:
I'm here to / renew my health card.
但最後真的要說出口時,我希望自己可以自然地說:
I'm here to renew my health card.
也就是說,chunk 可能本來就有大小之分。
小的 learning chunks 可以幫助我拆解句子、模仿,甚至注意到可以重複使用的句型。
大的 thought groups 則比較接近真正說話時的節奏。
所以我現在的假設是,練習可以分成三層:
small chunks → larger thought groups → full sentence
先拆開練,再慢慢合起來。
不過,我現在還不打算把三層全部塞進 MVP。
接下來,我想先拿幾個真實句子繼續測試,把「什麼叫切得好」整理成第一版 spec。等預期的輸入、輸出和判斷標準比較清楚之後,再開始做 prototype。
我今天幾乎沒寫程式,卻把「切得好」拆成了兩個不同目標。
如果我一開始看到「自動切句」這個需求,就直接開始想:
要寫規則嗎?要用 NLP 嗎?還是乾脆丟給 LLM?
我可能很快就能做出一個會動的版本。
但我甚至還不知道自己希望它產生什麼樣的結果。
我今天實際做的是:
需求 → 找真實例子 → 自己先做一次 → 問自己為什麼這樣做 → 發現原本藏在裡面的不同目標
做到這裡,我才知道接下來要問什麼:
哪些地方可以用簡單的規則?哪些真的需要理解語意?AI 到底需不需要出場?
這次我沒有先選模型,也沒有先寫程式。我先把「切得好」拆成兩個目標:適合學習,以及接近自然語流。接下來,才能判斷哪些地方用規則就夠了,哪些地方真的需要 AI。


 iThome鐵人賽
 看影片追技術