
Day4 提過一件事:Pi 的官方文件沒有用文字說明它的 agent loop 怎麼運作。但它有一個更直接的東西——每一次對話都會留下完整的 session 記錄。今天就把這份記錄打開,看 Day2 那個「看現況、想下一步、動手做、看結果」的迴圈,在真實資料裡到底長什麼樣子。
session 預設存在 Pi 家目錄底下:
<PI_CODING_AGENT_DIR>\sessions\--D--ithome_2026-test--\2026-09-06T15-07-13-313Z_<uuid>.jsonl
資料夾名稱是工作目錄轉換來的,檔名是開始時間加上一個 UUID。如果想放到別的地方,可以用 --session-dir 指定——後面的量測台就是這樣讓每次實驗各存各的。
格式是 JSON Lines:一行一個事件,依發生順序往下寫。
下面是 Day5 那個修 bug 的 session,我把太長的欄位剪掉,保留結構:
{"type":"session","version":3,"id":"01a07742-…","cwd":"D:\\ithome_2026\\test"}
{"type":"model_change","provider":"openai-codex","modelId":"gpt-5.6-luna"}
{"type":"thinking_level_change","thinkingLevel":"medium"}
{"type":"message","message":{"role":"user","content":[{"type":"text","text":"這個專案的測試沒過。請找出原因、修好…"}]}}
{"type":"message","message":{"role":"assistant",
  "content":[{"type":"thinking","thinking":""},
             {"type":"toolCall","name":"bash","arguments":{"command":"ls -la && python -m pytest"}}],
  "usage":{"input":1121,"output":39,"cacheRead":0,"totalTokens":1160,"cost":{"total":0.000271}},
  "stopReason":"toolUse"}}
{"type":"message","message":{"role":"toolResult","toolName":"bash","isError":true,
  "content":[{"type":"text","text":"… 2 failed, 3 passed … Command exited with code 1"}]}}
前三行是「開場資訊」:session 的 ID 和工作目錄、用了哪個模型、thinking level 是多少。之後每一行都是一則訊息,差別在 role:
role |
是什麼 | 對應 Day2 的哪一站 |
|---|---|---|
user |
使用者交代的任務 | 迴圈的起點 |
assistant |
模型的一次回應,裡面可能有思考、文字、工具呼叫 | 想下一步、決定動手 |
toolResult |
harness 實際執行工具後的結果 | 看結果 |
有兩個欄位特別值得記住:
stopReason:toolUse 代表模型還要呼叫工具,迴圈繼續;stop 代表模型覺得做完了,迴圈結束。整個 agent loop 何時停下,就寫在這個欄位裡。usage:每一輪模型呼叫用了多少 tokens、花了多少錢。input 是這輪沒命中快取的輸入,cacheRead 是命中 prompt cache 的部分,cost.total 是這一輪的美元成本。另外,每一行都有 id 和 parentId,所以記錄其實是一棵樹而不是一條線——在互動模式裡回到之前的某一步重新分岔時,不需要另開一個檔案。
還有一個容易誤會的地方:system prompt 不會出現在 session 記錄裡。 所以專案裡的 AGENTS.md 雖然每次都被載入,你在記錄中看不到它被 read。這一點 Day8 講載入順序時還會再提。
Day5 的例子只有 5 輪,太短了。下面這份是量測台實際跑出來的記錄:任務是替一個小型 API 專案新增 GET /projects/{project_id}/stats。這個專案規定新增 endpoint 要改三個地方,而且完成前必須跑過 scripts/check.py,這些規定都寫在專案的 AGENTS.md 裡。
我把 8 輪模型呼叫整理成一張表:
| 輪 | 模型決定做什麼 | 這輪輸入(未快取+快取) |
|---|---|---|
| 1 | 讀規格測試、registry.py、schemas/__init__.py,列出專案檔案 |
1,509 |
| 2 | 再讀 6 個檔:routes、services、schema、repository、dispatcher、產生的 model | 2,467 |
| 3 | 再讀 6 個檔,包括 scripts/check.py 本身 |
4,244 |
| 4 | 用 grep 確認專案裡還有沒有 stats 相關程式碼 |
6,906 |
| 5 | 新增 schemas/project_stats.py |
7,300 |
| 6 | 同一輪改 4 個檔:route、service、schema 匯出、ROUTE_REGISTRY |
7,517 |
| 7 | 跑 python scripts/check.py,六項全過 |
8,338 |
| 8 | 回報完成,stopReason: stop |
8,436 |
總共 23 次工具呼叫,成本約 0.0066 美元,任務成功。
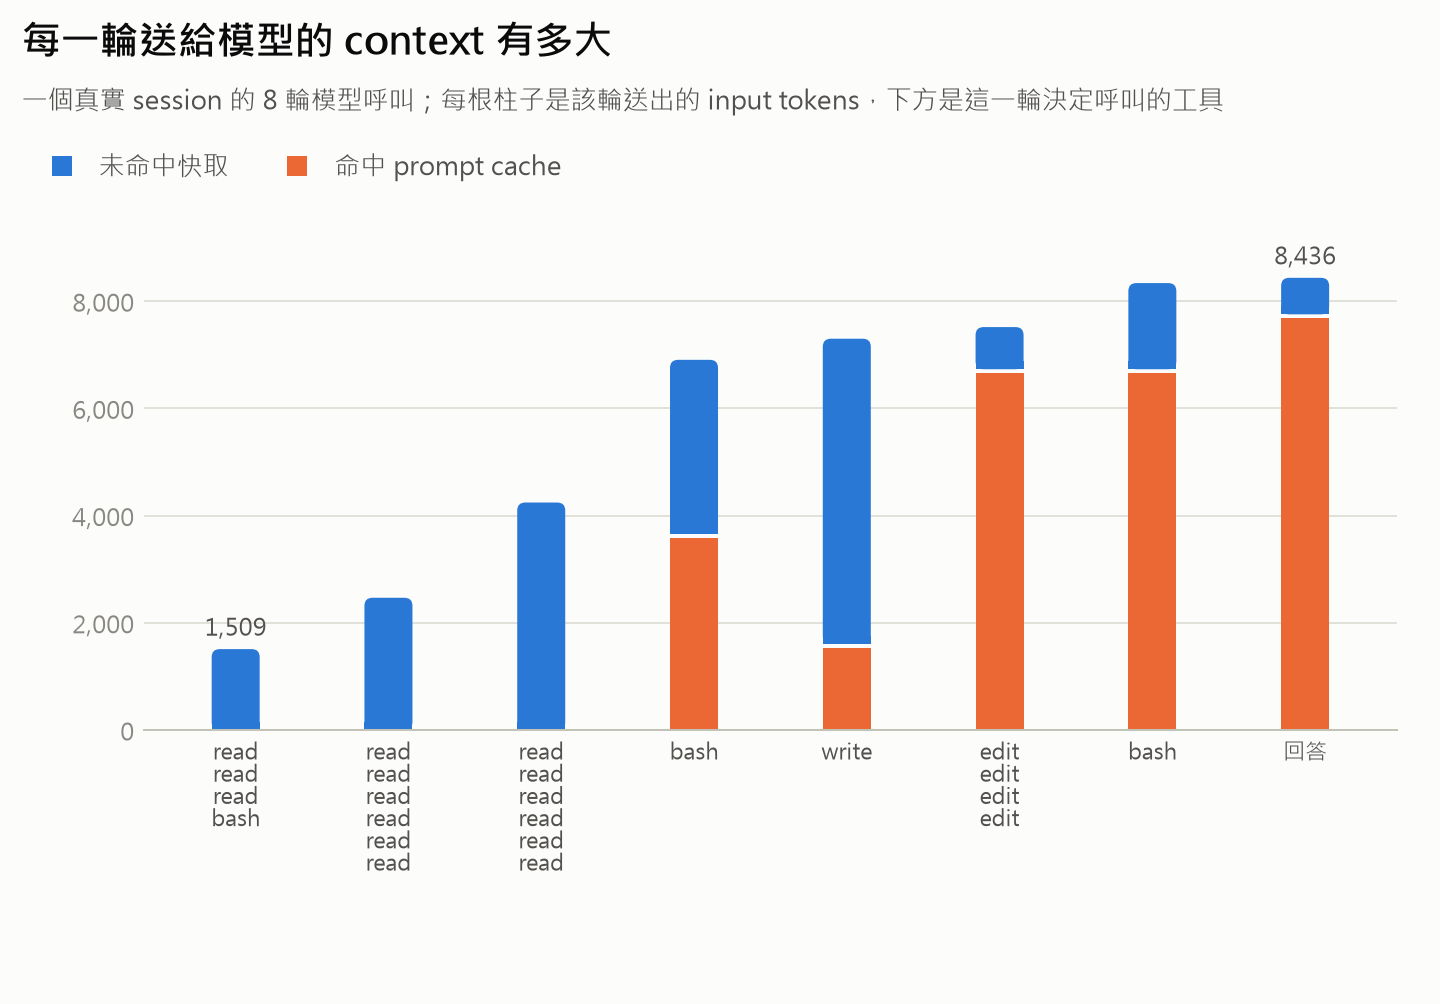
這份記錄裡有三件事,光看最後的回答是看不出來的:
check.py。這些行為如果拿掉 AGENTS.md 還會不會發生?那正是 Day9 要量的東西。有了這份記錄,成本、tokens、工具呼叫次數都不用猜。核心邏輯只有十幾行:
import json
from collections import Counter

tools, cost, tokens = Counter(), 0.0, 0
for line in open(session_path, encoding="utf-8"):
    entry = json.loads(line)
    message = entry.get("message") or {}
    if entry.get("type") != "message" or message.get("role") != "assistant":
        continue
    usage = message.get("usage") or {}
    cost += usage.get("cost", {}).get("total", 0)
    tokens += usage.get("totalTokens", 0)
    for block in message.get("content", []):
        if block.get("type") == "toolCall":
            tools[block["name"]] += 1

print(f"cost=${cost:.4f} tokens={tokens} tools={dict(tools)}")
量測台實際用的版本在 bench/runner/metrics.py,多記了幾件事:工具錯誤次數、傳輸層失敗次數、跑過哪些 bash 指令、讀過哪些文件、有沒有讀 SKILL.md。後面每一個實驗的數字,都是從這份記錄算出來的。
能從一份記錄算出數字,還不等於能做實驗。一次的結果可能只是運氣,要比較「有沒有某個元件」,至少要有:可以重複執行的任務、每次都一模一樣的起點、不靠人工判斷的驗收方式。Day7 會把這些組成一個最小的量測台,而且刻意讓它跟 harness 無關——換成別的 coding agent 也能跑同一組任務。


 iThome鐵人賽
 看影片追技術