
前四天都在講「為什麼」:agent loop 是什麼、harness 有哪些元件、為什麼選 Pi。今天開始動手——在 Windows 上把 Pi 裝起來、登入、交給它第一個真實任務,並且確認這台電腦的環境乾淨到可以拿來做實驗。
最後一點很容易被跳過,但後面三十天的數字能不能信,就看這一步。
| 項目 | 版本 |
|---|---|
| 作業系統 | Windows 11 |
| Node.js | 24.18 |
| Pi Coding Agent | 0.84.3 |
| Shell | Git Bash(Pi 在 Windows 上預設用它執行 bash 工具) |
| Python | 3.13(受測專案用) |
Pi 在 Windows 上會依序找自訂路徑、C:\Program Files\Git\bin\bash.exe、PATH 上的 bash.exe。多數人裝好 Git for Windows 就夠了。
Pi 是一個 npm 套件,官方文件(pi.dev)的 Quick start 第一行就是安裝指令:
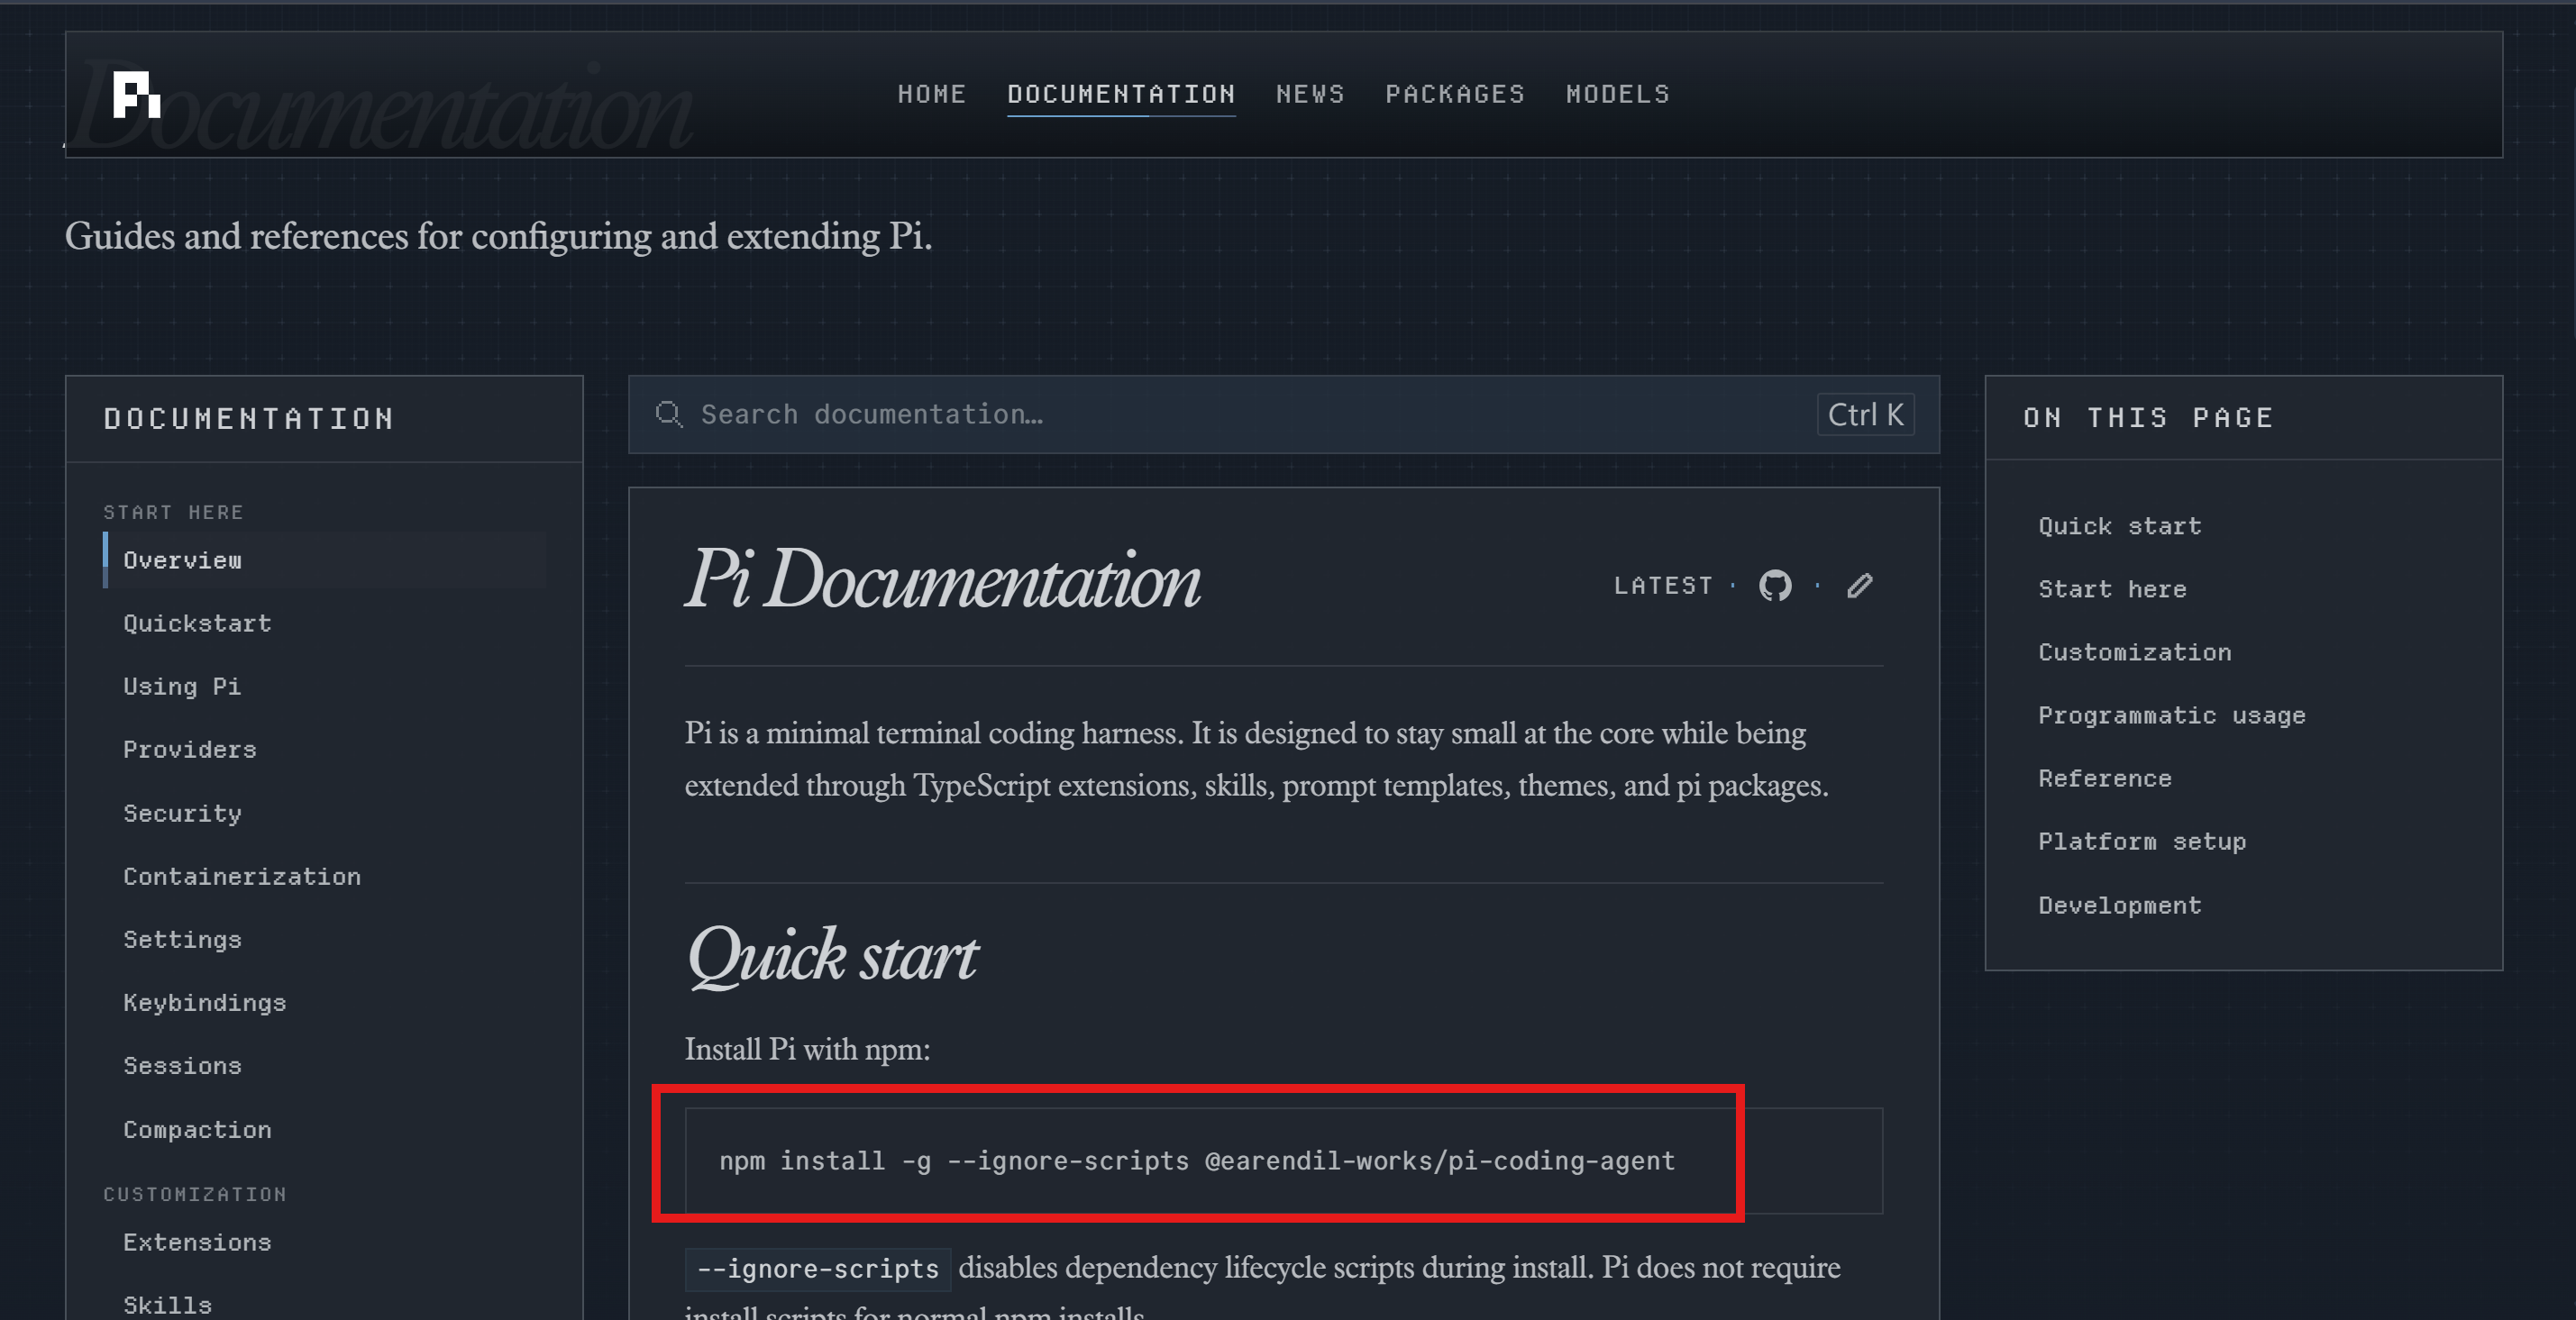
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
--ignore-scripts 會關掉相依套件的安裝腳本。Pi 正常安裝不需要這些腳本,關掉可以少一個被供應鏈攻擊的入口,順手加上就好。
安裝本身很快,十幾秒就結束了:
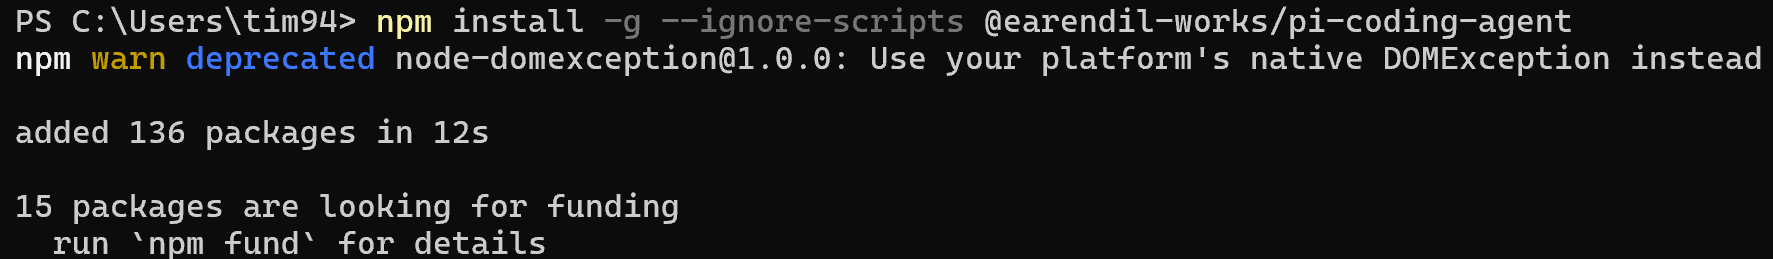
那行 node-domexception 的 deprecated 警告來自相依套件,不影響使用,可以忽略。
Pi 會把登入憑證、設定、所有 session 記錄放在自己的家目錄(預設是 ~/.pi/agent)。這個系列會跑上百次實驗,session 記錄會越堆越多,我的 C 槽空間又很緊,所以一開始就用環境變數 PI_CODING_AGENT_DIR 把它指到 D 槽:
[Environment]::SetEnvironmentVariable("PI_CODING_AGENT_DIR", "D:\pi-agent", "User")
設定完重開終端機,用過一次之後,這個目錄會長這樣:
D:\pi-agent\
├─ auth.json          登入憑證(千萬不要 commit 或外流)
├─ settings.json      預設 provider、預設模型
├─ models-store.json  模型清單快取
├─ bin\               Pi 自己下載的 rg.exe、fd.exe(下一節說明)
└─ sessions\          每個專案一個資料夾,每次對話一個 .jsonl
進到專案目錄執行 pi,第一次啟動的畫面有兩件事值得注意:
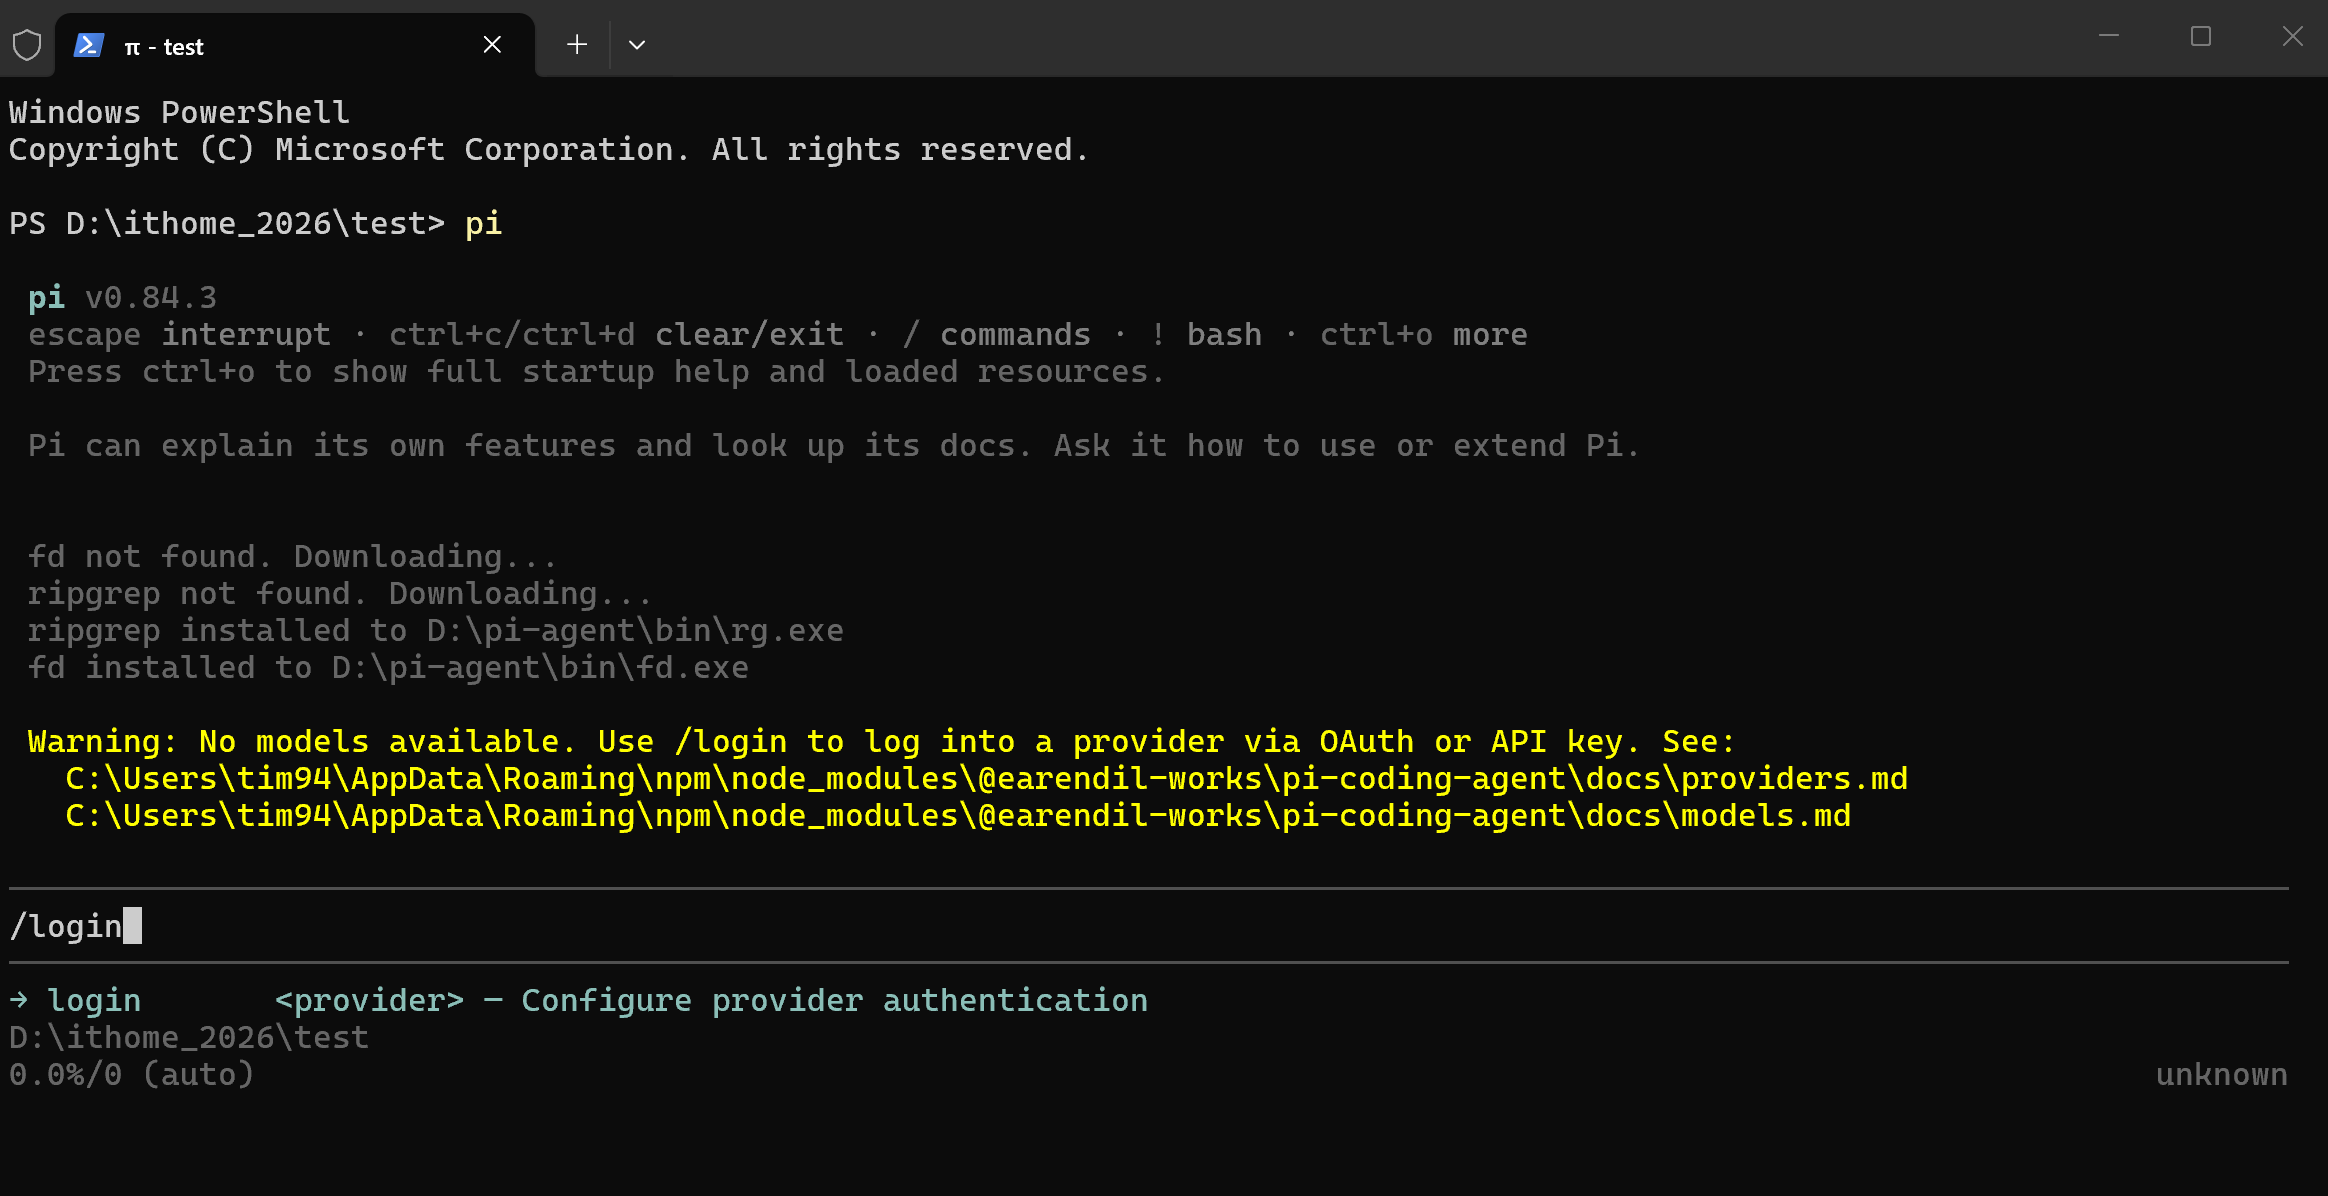
第一件是中間那四行:
fd not found. Downloading...
ripgrep not found. Downloading...
ripgrep installed to D:\pi-agent\bin\rg.exe
fd installed to D:\pi-agent\bin\fd.exe
Pi 發現電腦上沒有 ripgrep(rg)和 fd 這兩個搜尋工具,自己下載到它的家目錄裡。這是一個很典型的 harness 設計:agent 的效率很依賴「找檔案、搜內容」這兩件事,與其賭使用者的電腦上有沒有裝,不如自己準備好。這個細節在 Day13 會變得很重要——那天量「開不開搜尋工具有沒有差」時,agent 手上一直都有 rg 可以用,而那正是 Pi 在這一刻替它裝好的。
第二件是那段黃色警告:「No models available」。剛裝好的 Pi 還沒有任何可以呼叫的模型,得先登入。
在輸入框打 /login,Pi 會讓你選登入方式——用帳號(訂閱方案)或用 API key——以及要登入哪一家服務商。
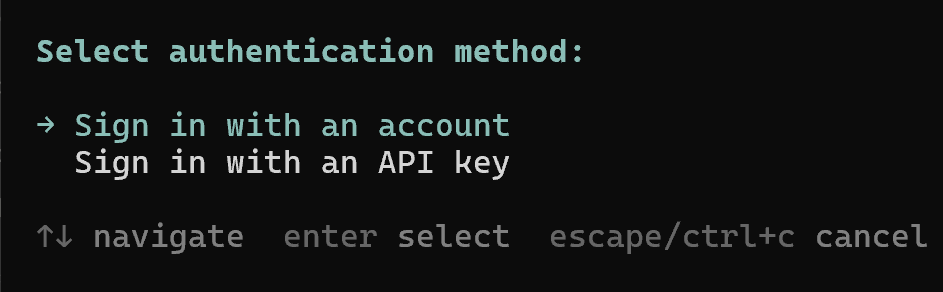
Pi 內建支援的訂閱方案有 Claude Pro/Max、ChatGPT Plus/Pro(Codex)和 GitHub Copilot。我選「Sign in with an account」用 ChatGPT 訂閱登入,照畫面指示完成授權後,回到終端機就能用了。
登入完成後,隨便打一句話測試:
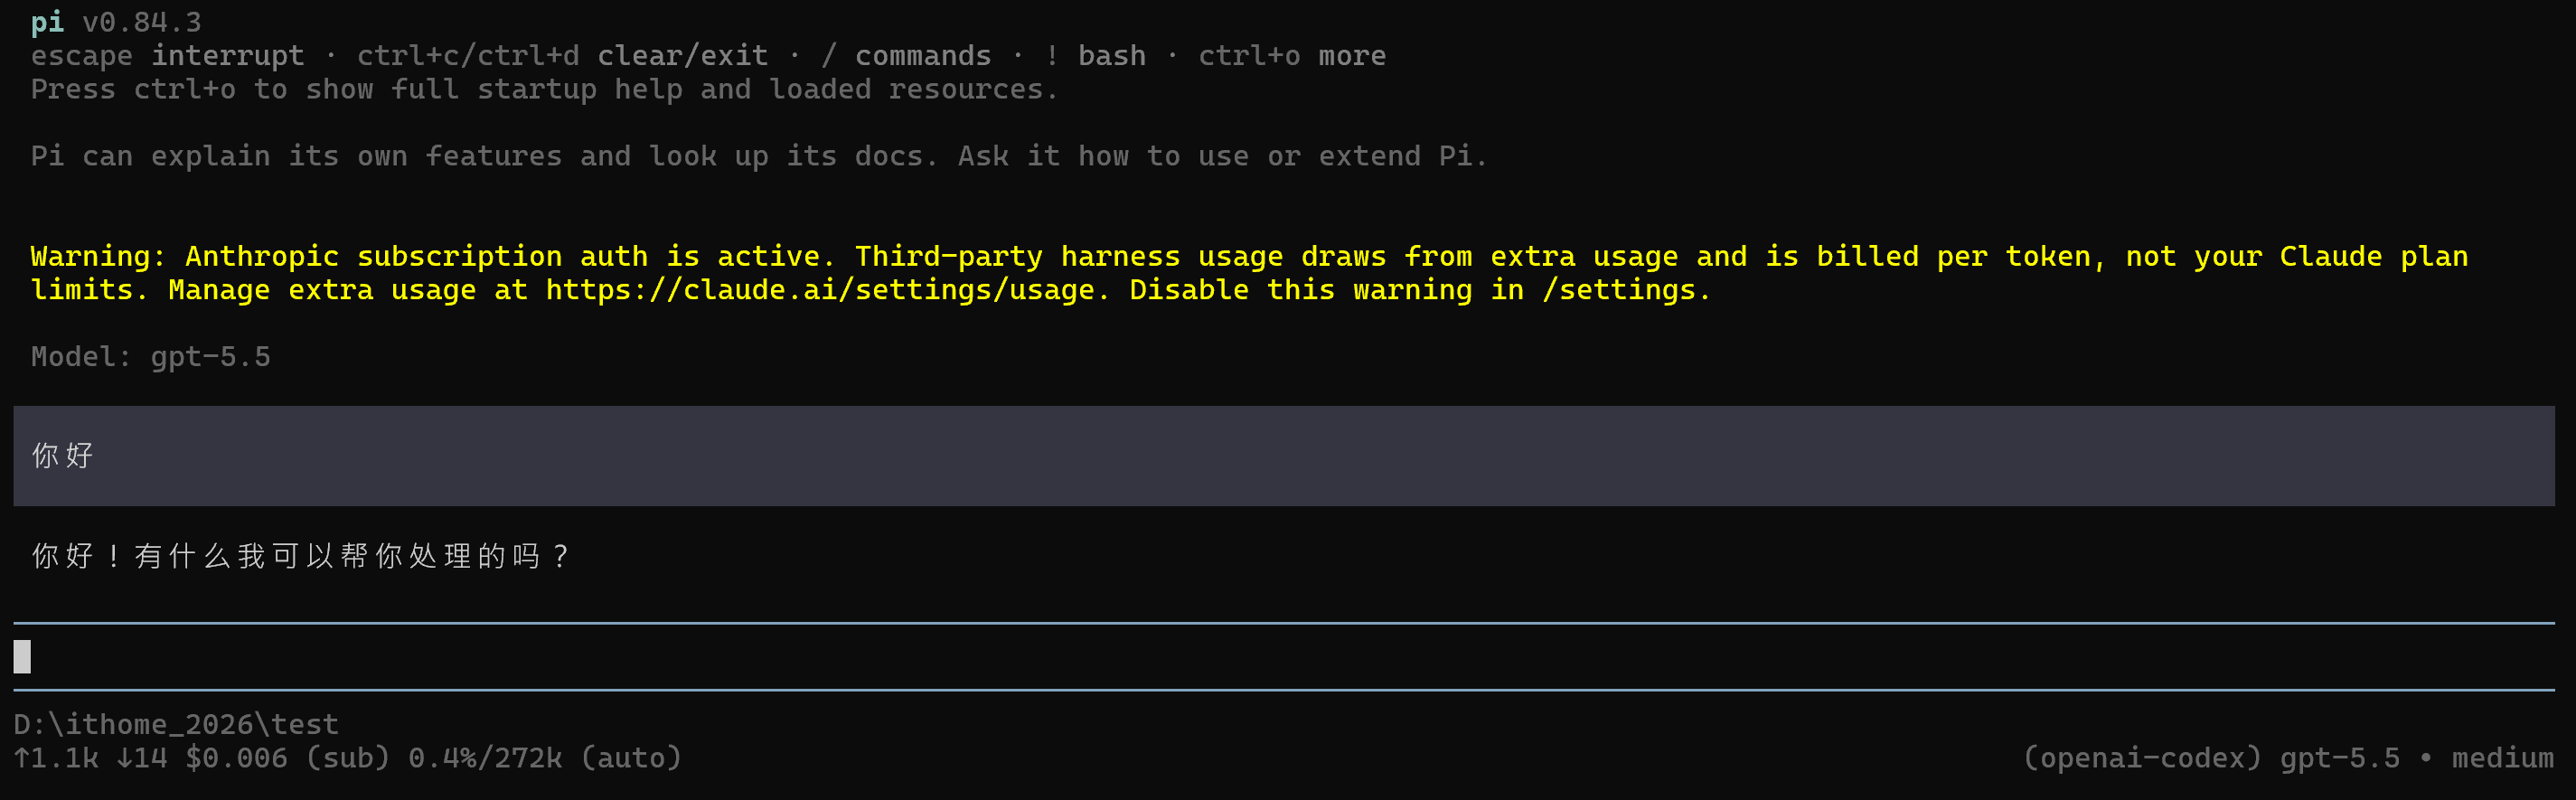
幾個看得出來的資訊:
(openai-codex) gpt-5.5 • medium:走的是 ChatGPT 訂閱(Codex),模型是 gpt-5.5,thinking level 是預設的 medium(Day16 會講這是什麼)。$0.006 (sub) 是這次對話換算的費用,(sub) 代表是從訂閱額度扣,不是另外刷卡。登入後 settings.json 會記下預設值。我後來把預設模型改成 gpt-5.6-luna,這個系列的實驗全部用它:
{
  "defaultProvider": "openai-codex",
  "defaultModel": "gpt-5.6-luna"
}
想知道能用哪些模型:
pi --list-models codex
provider      model                context  max-out  thinking  images
openai-codex  gpt-5.3-codex-spark  128K     128K     yes       no
openai-codex  gpt-5.4              272K     128K     yes       yes
openai-codex  gpt-5.4-mini         272K     128K     yes       yes
openai-codex  gpt-5.5              272K     128K     yes       yes
openai-codex  gpt-5.6-luna         272K     128K     yes       yes
openai-codex  gpt-5.6-sol          272K     128K     yes       yes
openai-codex  gpt-5.6-terra        272K     128K     yes       yes
openai-codex  gpt-6-astra          272K     128K     yes       yes
我先用 gpt-5.6-luna:夠便宜(每百萬 input tokens 0.2 美元),而且刻意不是最強的模型。為什麼實驗要故意挑「不是最強」的模型,會在校準那篇講清楚。
我準備了一個很小的 Python 專案:一個 calc.py,裡面刻意埋了兩個 bug——apply_discount 回傳的是折扣金額而不是折後價,moving_average 少算了最後一個視窗。docstring 也刻意寫得很薄,bug 只能從測試失敗反推。
在專案目錄交代任務:
這個專案的測試沒過。請找出原因、修好,然後跑 python -m pytest 確認全部通過。
Pi 做了這些事:
bash(ls + pytest) → read × 3 → edit(一次修掉兩個 bug)→ bash(pytest) → 回答
第一次跑 pytest 是 3 過 2 失敗(這正是任務本身),讀完三個檔案後一次改好兩個地方,再跑一次 pytest 變成 5 個全過,然後回報。整個 session 5 輪模型呼叫、6 次工具呼叫、總共約 11,249 tokens,成本大約 0.002 美元。
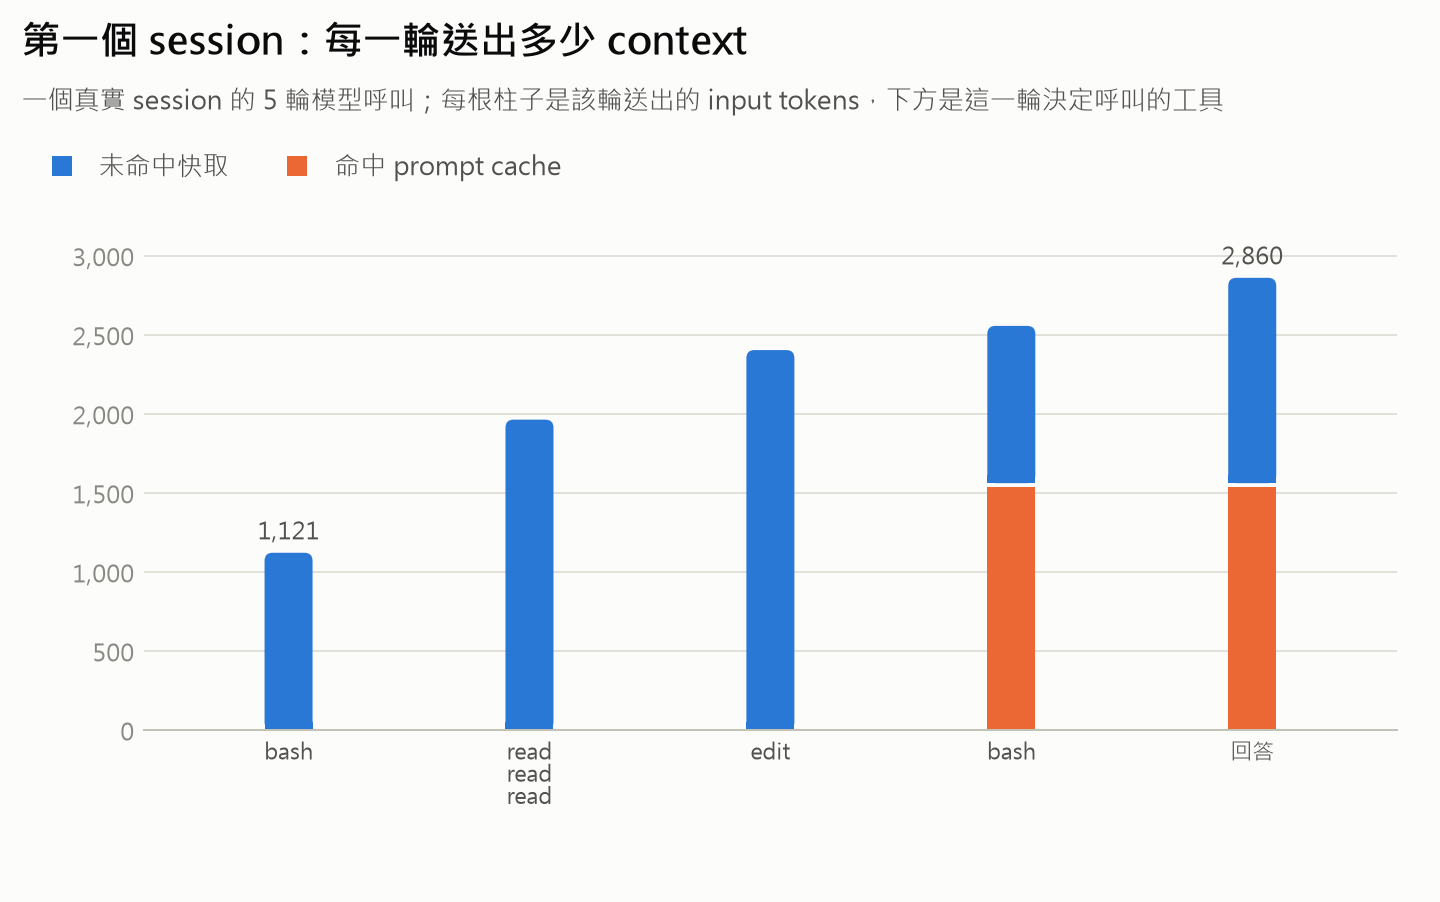
這張圖是從 session 記錄畫出來的:每根柱子是那一輪送給模型的 input tokens,下面標的是那一輪模型決定呼叫的工具。你可以看到 Day2 講的「每一輪都把目前為止的事整包重送」——柱子一輪比一輪高;從第四輪開始,前面重複的部分命中了 prompt cache(橘色),這部分的計價便宜很多。明天會把這份記錄一行一行拆開來看。
在裝好 Pi 的頭幾天,我遇到一個很難認的問題:請求間歇性失敗,但重試就會成功。因為 Pi 會自動重試,表面上看起來只是「有點慢」,很容易以為是服務商不穩定。
最後查出來跟 Pi、跟模型都無關:這台電腦上 VPN 軟體和虛擬機軟體裝的虛擬網卡,Windows 分給它們的優先權比 Wi-Fi 還高,而它們掛著一台解析不了外網的 DNS。所有對外請求都先去問那台 DNS、逾時、再退回正常的解析器。
診斷時有兩個指令很好用。先分段計時,看時間是不是卡在 DNS:
curl -s -o /dev/null -m 20 -w "dns=%{time_namelookup}s connect=%{time_connect}s total=%{time_total}s\n" https://目標網域
再看 Windows 先問哪張網卡(InterfaceMetric 越小越優先)、每張網卡各掛哪台 DNS:
Get-NetIPInterface -AddressFamily IPv4 | Sort-Object InterfaceMetric |
  Select-Object InterfaceAlias, InterfaceMetric, ConnectionState
Get-DnsClientServerAddress -AddressFamily IPv4 |
  Select-Object InterfaceAlias, InterfaceIndex, ServerAddresses
一般開發時,這種問題只是「慢一點」。但這個系列要量的指標裡就有「重試次數」和「成本」,如果環境每個請求都偷偷製造一次重試,這些數字就全變成雜訊。
所以我給自己訂了一條規則:**先量環境,再量系統。**修好 DNS 之後,我也在每次實驗的記錄裡保留 Pi 回報的傳輸層錯誤次數(session 裡的 provider_transport_failure)。它現在偶爾還是會出現一次,但至少會被記下來,而不是被自動重試悄悄吃掉。
第一個 session 跑完了,Pi 在 sessions\ 底下留下一個 .jsonl 檔。Day6 會打開這個檔案,一行一行對照 Day2 的「看現況、想下一步、動手做、看結果」,看 agent loop 在真實記錄裡長什麼樣子,以及怎麼從裡面算出 tokens、成本和工具呼叫次數。


把 session 拆成角色、stopReason、usage 之後,Agent loop 真的從黑盒子變成可量測資料了。我特別好奇 metrics.py 區分「工具本身失敗」和「傳輸層失敗」的規則:遇到 timeout 或非零 exit code 時,會怎麼避免誤分類?

謝謝提問!metrics.py 是 Day 6 拆解的,Day 5 只提到會保留 provider_transport_failure。
我沒有用規則去猜,是靠 Pi 在 session 記錄裡本來就分開的兩個來源:工具失敗來自 toolResult 的 isError,傳輸層失敗來自 assistant 訊息 diagnostics 裡的 provider_transport_failure。一個發生在「執行工具」、一個發生在「呼叫模型」,所以 timeout 算哪邊,取決於是哪一層逾時:模型自己帶的 timeout: 120 算工具失敗,Pi 的 HTTP 閒置逾時算傳輸層。
不過你點到一個真實的限制:非零 exit code 也會被計進 tool_errors(例如 agent 跑一次失敗的 pytest),所以它代表「工具回報了錯誤」,不是「工具壞了」。整次執行卡住的情況,則是在 runner 層另外判成基礎設施失敗,重跑而不計分。

 iThome鐵人賽
 看影片追技術