
Day23 把量測台補成了評測框架,最後留下一句話:19 組比較裡只有 6 組是有把握的。
今天把這 19 組攤開,並且明確指出哪幾篇我講得太滿。
先看全貌:
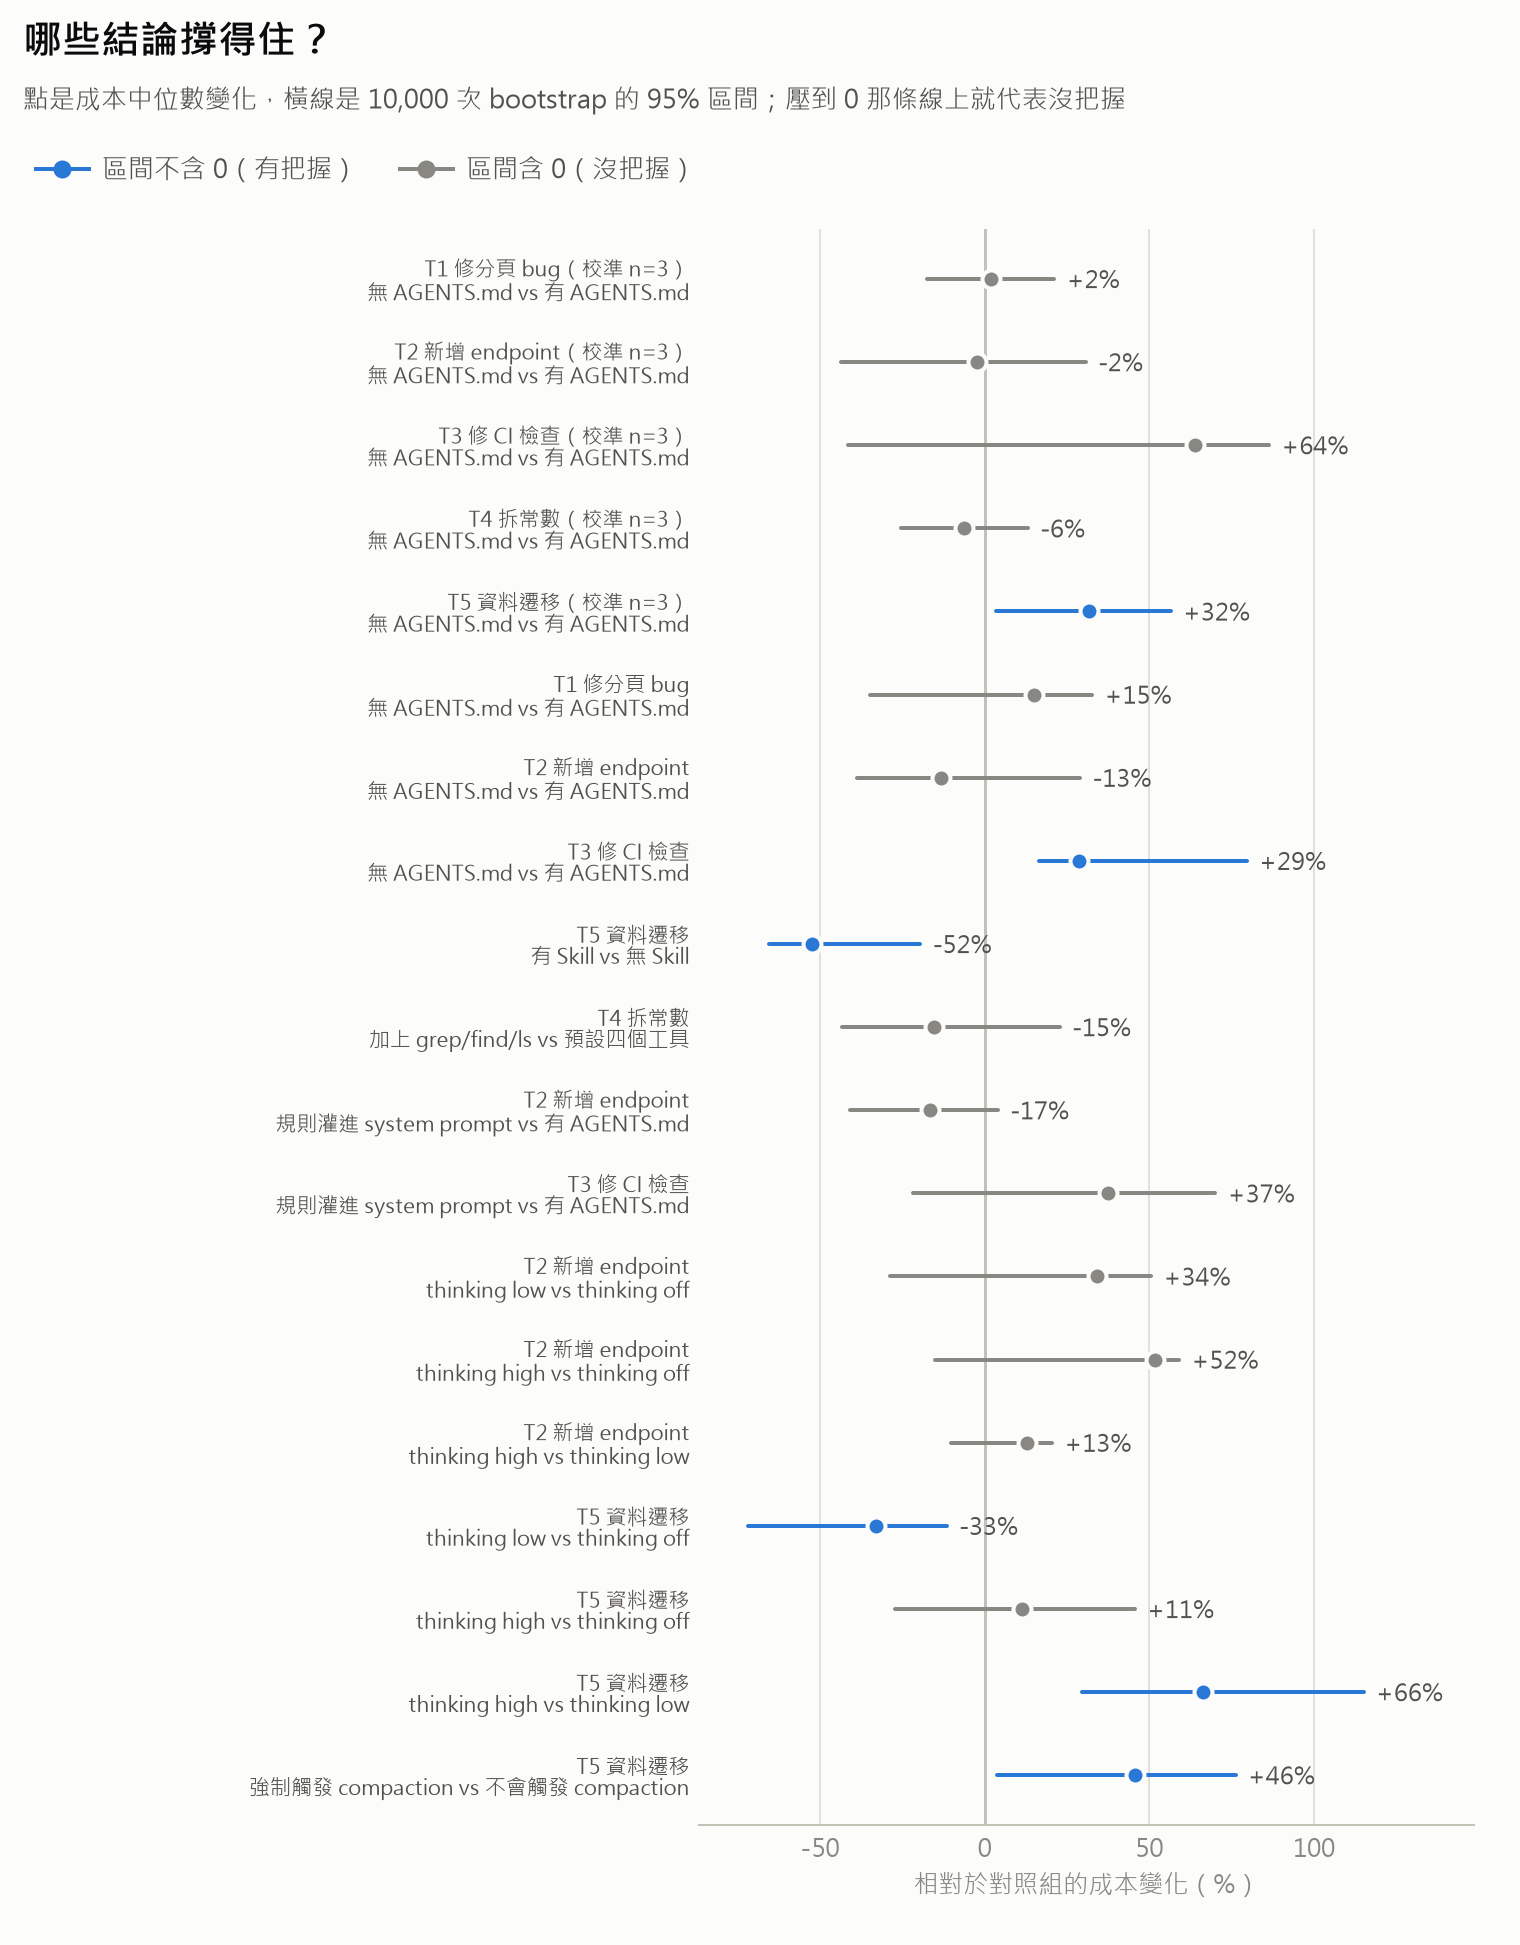
每一條橫線是一組比較的 95% bootstrap 區間,點是成本中位數的變化。只要線壓到 0 那一條垂直線上,就代表「其實沒差」還沒被排除。
十九條裡,有十三條壓在 0 上。
python -m analysis.evals
| 實驗 | 任務 | 比較 | n | 成功率 | 成本中位數變化 | 95% CI | 有把握? |
|---|---|---|---|---|---|---|---|
| 校準 | T1 修分頁 bug | 無 AGENTS.md vs 有 | 3 | 3/3 → 3/3 | +2.0% | −17.4% ~ +21.2% | 否 |
| 校準 | T2 新增 endpoint | 無 AGENTS.md vs 有 | 3 | 3/3 → 3/3 | −2.2% | −43.7% ~ +30.7% | 否 |
| 校準 | T3 修 CI 檢查 | 無 AGENTS.md vs 有 | 3 | 3/3 → 3/3 | +63.8% | −41.6% ~ +86.4% | 否 |
| 校準 | T4 拆常數 | 無 AGENTS.md vs 有 | 3 | 3/3 → 2/3 | −6.1% | −25.4% ~ +13.1% | 否 |
| 校準 | T5 資料遷移 | 無 AGENTS.md vs 有 | 3 | 3/3 → 3/3 | +31.6% | +3.4% ~ +56.5% | 是 |
| Day9 | T1 修分頁 bug | 無 AGENTS.md vs 有 | 5 | 5/5 → 5/5 | +15.0% | −34.7% ~ +32.7% | 否 |
| Day9 | T2 新增 endpoint | 無 AGENTS.md vs 有 | 5 | 5/5 → 5/5 | −13.2% | −38.8% ~ +29.0% | 否 |
| Day9 | T3 修 CI 檢查 | 無 AGENTS.md vs 有 | 5 | 5/5 → 5/5 | +28.7% | +16.5% ~ +79.6% | 是 |
| Day11 | T5 資料遷移 | 有 Skill vs 無 Skill | 5 | 5/5 → 5/5 | −52.4% | −65.3% ~ −19.5% | 是 |
| Day13 | T4 拆常數 | 加搜尋工具 vs 預設四工具 | 5 | 5/5 → 5/5 | −15.4% | −43.2% ~ +22.8% | 否 |
| Day15 | T2 新增 endpoint | system prompt vs AGENTS.md | 5 | 5/5 → 5/5 | −16.6% | −40.8% ~ +4.0% | 否 |
| Day15 | T3 修 CI 檢查 | system prompt vs AGENTS.md | 5 | 5/5 → 5/5 | +37.4% | −21.8% ~ +70.1% | 否 |
| Day17 | T2 新增 endpoint | low vs off | 5 | 5/5 → 5/5 | +34.2% | −28.6% ~ +50.6% | 否 |
| Day17 | T2 新增 endpoint | high vs off | 5 | 5/5 → 5/5 | +51.7% | −14.9% ~ +59.1% | 否 |
| Day17 | T2 新增 endpoint | high vs low | 5 | 5/5 → 5/5 | +13.0% | −10.2% ~ +20.5% | 否 |
| Day17 | T5 資料遷移 | low vs off | 5 | 5/5 → 5/5 | −33.0% | −71.7% ~ −11.5% | 是 |
| Day17 | T5 資料遷移 | high vs off | 5 | 5/5 → 5/5 | +11.4% | −27.3% ~ +45.6% | 否 |
| Day17 | T5 資料遷移 | high vs low | 5 | 5/5 → 5/5 | +66.2% | +29.5% ~ +115.1% | 是 |
| Day22 | T5 資料遷移 | 強制 compaction vs 不觸發 | 5 | 5/5 → 5/5 | +45.7% | +3.9% ~ +76.2% | 是 |
一、Skill 讓 T5 省一半(−52.4%,區間 −65% ~ −20%)。
這是整批資料裡效果最大、也最乾淨的一個。而且它的機制在 Day11 就講清楚了:Skill 不是給模型新知識,而是省掉它自己摸索流程的那幾輪。
二、T5 的 thinking high 比 low 貴 66%(+29% ~ +115%)。
Day17 靠肉眼就看出來了(兩組數值完全沒重疊),bootstrap 只是確認。
三、T5 的 thinking low 比 off 省 33%(−72% ~ −12%)。
這個有意思:Day17 我看範圍時說「差一點點就完全分開」,所以講得很保留。bootstrap 反而給了把握——因為它重抽的是中位數,不是「最小值有沒有超過另一組最大值」。肉眼看範圍重疊,比 bootstrap 更保守。
四、T3 少了 AGENTS.md 要多花 28.7%(+16.5% ~ +79.6%)。
Day9 的核心結論,撐住了。
五、校準組的 T5 也是同方向(+31.6%),但它只有 n=3。
它的區間下緣是 +3.4%,擦著 0 過去。Day23 說過:擦邊的要保留。
六、強制 compaction 要多付 45.7%(+3.9% ~ +76.2%)。
這一條是最晚才站穩的。Day22 一開始算出來是 +22%、區間含 0,因為我的量測漏掉了「產生摘要」那一次模型呼叫的費用——它的 usage 掛在 compaction 記錄上,不在 assistant 訊息裡。補上之後,差距幾乎全部來自那一筆。它的下緣也是擦邊(+3.9%)。
這是今天真正的重點。
Day22 的「對話本身變貴了兩成」。
把摘要的費用抽掉、只看對話的部分,強制壓縮那組是 $0.0095 vs $0.0078(+22%),區間 −16.6% ~ +53.0%。也就是說,那 22% 是雜訊;撐得住的那一段完全來自摘要呼叫本身。如果我沒有去查帳單的組成,很可能就把一個雜訊講成了「壓縮讓對話變貴」。
校準跑出來的 T3 +63.8%,正式跑變成 +28.7%。
同一個比較,n 從 3 變成 5,點估計掉了一半以上。只有方向站得住。這件事本身就是「n=3 的數字不能當結論」最好的證據——而我在 Day9 的校準段落裡,其實是把它當初步結論在講的。
Day15 的 T3 +37.4%。
中位數差了快四成,區間卻是 −21.8% ~ +70.1%。我在 Day15 的結論是「兩種做法行為一樣,選哪個看規則屬於誰」——結論沒錯,但如果當時我只看中位數,很可能會寫出「AGENTS.md 比較省」這種撐不住的話。
Day13 的 −15.4%。
Day13 的標題就是「多三個搜尋工具卻沒有更快」,內文寫「完全重疊」。這篇通過檢驗,是因為當時我就不敢下結論。
看表格第五欄:除了校準的 T4(2/3),每一組都是 5/5。
143 次執行裡,agent 失敗的次數屈指可數。成功率在這批任務上已經沒有解析度了。
而且就算全對,也不能說「成功率是 100%」。5 次全成功的 Wilson 95% 區間是:
57% ~ 100%
五次全中,真實成功率可能低到 57%。這不是統計學在找碴,是 n=5 的資訊量就只有這麼多。
這也是為什麼這一系列從 Day9 開始就把成本當主指標:成功率要能分辨東西,得先有會失敗的任務。這件事在明天之後的兩篇會補上——Day26 的閘門實驗就是第一個真的會失敗的任務。
要公平一點,這個框架也有它的問題:
analysis/evals.py 是一個可重跑的指令,而不是我手貼的表格。這個框架最實用的地方其實不在寫文章,而在改 harness 的時候。
任何一次改動——升級 Pi、換 context 檔的寫法、加一個 extension——都可以跑同一組任務,用同一把尺比對:
python -m bench.runner.cli run experiments/configs/e09_agents_md.json --as e09_rerun
python -m analysis.evals
有了這個,「我改完之後好像變慢了」就不再是感覺,而是一個有區間的數字。
完整表格與 CSV 在 repo 的 experiments/results/evals/。
Day25 換方向:前面都在問「給 agent 更多東西會怎樣」,接下來三天問**「不給它做某些事會怎樣」**——從一個會刪錯檔案的任務開始。


 iThome鐵人賽
 看影片追技術