
昨天分享了整個 Router 專案的工作方式,先寫需求文件,再讓 AI 動手。今天開始,一個模組一個模組來,第一個要聊的是 Provider 管理:這個模組的構思,跟它經歷過的一次修正。在那之前,先花一段講清楚這個專案整體在做什麼。
個人版 LLM Router,簡單說就是一個放在自己開發環境裡的「請求轉發站」:不管背後接的是 Anthropic、OpenAI,還是其他相容 OpenAI 格式的服務,對外都用同一種方式發送請求,不用因為換了一家模型就要改一次呼叫邏輯。
除了轉發之外,這個系統還做幾件事:請求進來時先審核額度跟權限,確認這個呼叫有沒有超過預算、有沒有資格用這個模型;依照設定好的規則控制流量,一個模型掛了自動切換到備援選項,不會讓呼叫直接失敗;以及保護真正打給廠商的 API Key,不管是存放方式還是外部呼叫端拿到的憑證,都跟廠商原始的金鑰隔開,外流也不會直接波及真實帳號。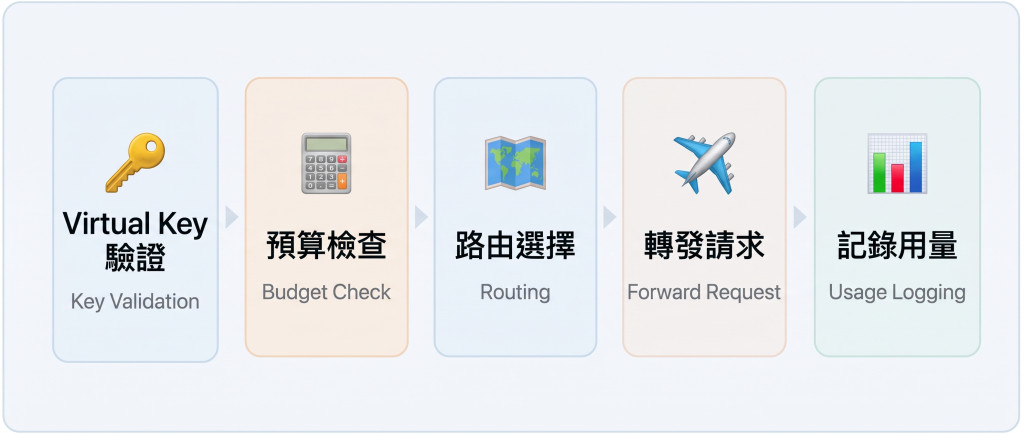
接下來幾天,會一個個模組拆開講這些功能背後的構思,今天先從 Provider 管理開始。
會做這個模組,出發點很單純:開發過程中會需要用到不同的模型,但每家廠商的 API 入口、SDK 都不一樣。這個模組從一開始的目的,就是為了同時接上多家 provider 而設計的——不是先做好一家、之後才想到要擴充,而是一開始就是衝著「要接多家」這個目標去規劃架構。
先說清楚 Adapter 在這個系統裡的角色:Router 對外只認一種請求格式,不管呼叫端要打哪個模型,都用同一套介面呼叫進來;但背後接的每一家廠商,API 的長相都不一樣。Adapter 的工作,就是把這套統一格式在「進去」跟「出來」的時候,分別轉換成、轉換回每一家廠商實際要的樣子——呼叫端不用知道背後是哪一家、也不用因為換了廠商而改呼叫邏輯,差異全部被這一層擋下來。
最早的版本,是幫每一家 provider 各寫一個「原生」的 adapter:Anthropic 用官方 SDK 處理一次轉換,OpenAI 也用官方 SDK 處理一次轉換,各自獨立、互不相干——邏輯上是「每一家都要客製一次」。後來參考了另一份針對同一個專案、由另一個開發對話產出的設計文件,才發現這個思路其實可以再往下分一層:問題不是「每家 provider 都需要客製轉換」,而是要看「這家廠商的 API 格式,本身跟 OpenAI 相容到什麼程度」——這才是真正決定要不要寫轉換邏輯的關鍵,不是「這是哪一家」。
依這個標準分流之後,變成兩種 adapter:
**Passthrough(透傳型)**給本身就相容 OpenAI 格式的廠商用(OpenAI、Ollama、vLLM、Gemini 的 OpenAI 相容層)。這些廠商的請求/回應本來就是 OpenAI 的形狀,硬寫一套轉換邏輯,其實是在做「把 A 轉成 A」的多餘工作——這種 adapter 完全不做欄位轉換,把請求原封不動轉發出去、回應也原封不動帶回來。實務上的好處是:之後想再接一家同樣相容 OpenAI 格式的廠商,只是新增一筆設定資料(base URL、API key),不需要寫任何新程式碼。
**Native(原生轉換型)**才是留給協議真的差很大的廠商,目前只有 Anthropic 需要——它的 system 訊息要獨立成一個欄位(不是混在 messages 陣列裡)、認證方式不一樣、回應結構也不一樣,這些差異沒辦法用「轉發」帶過,需要真的寫一段轉換邏輯。
Provider Adapter 這個模組,是為了讓系統能同時接上多家 LLM provider 而設計的。實作過程中也經歷了一次修正:從一開始每家各寫一套轉換邏輯,到後來想通可以依「跟 OpenAI 格式相容的程度」分流,把多數廠商歸進不需要寫程式碼就能新增的 Passthrough,只把真正協議差異大的廠商留給 Native。
明天要分享下一塊:資料與安全設計——為什麼 Credential 跟 Deployment 要拆成兩張表,還有 API Key 這種敏感資料要怎麼保護。


 iThome鐵人賽
 看影片追技術