
在過去兩天的分析中,我們挖掘出兩個看似獨立、卻互為表裡的關鍵現象:
Day 11: 物流延遲是摧毀滿意度、導致 1 星負評的致命因子。
Day 12: 在排除小樣本雜訊後,「辦公家具」等大件品類名列高負評榜首。
這立刻引發了一個嚴肅的營運假說:這些品類拿到負評,會不會根本不是因為產品本身品質差,
而是因為「太重、太大」,超出了巴西物流網絡的承載極限,導致配送頻繁跳票?
今天,我們將運用 Pandas 的特徵工程衍生出「體積」欄位,
並透過實戰中極為關鍵的「連續特徵分箱(Binning)」技術,驗證物理規格對物流履約時效的殘酷制約!
在 products 表中,官方提供了長寬高與重量等物理指標:
product_weight_g:商品重量(公克)
product_length_cm / product_height_cm / product_width_cm:長寬高(公分)
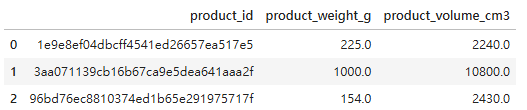
我們首先將長寬高相乘,衍生出「商品體積(立方公分)」特徵:
# 1. 衍生體積特徵 (cm^3)
products['product_volume_cm3'] = (
    products['product_length_cm'] *
    products['product_height_cm'] *
    products['product_width_cm']
)

# 2. 檢視物理規格欄位
products[['product_id', 'product_weight_g', 'product_volume_cm3']].head(3)
實作區 :
我們需要將包含物理特徵的商品資料,
與 Day 11 建立好的「訂單延遲狀態 (orders_with_reviews)」串接起來。
由於明細表 (items) 是一對多關係,為了避免多品項訂單干擾分析,我們先聚焦在最常見的單品項訂單,
或在明細層級檢視履約延遲情況:
# 1. 以 items 為核心,關聯訂單的延遲標籤與商品的物理規格
item_logistics = pd.merge(
    items[['order_id', 'product_id']],
    orders_with_reviews[['order_id', 'is_delayed', 'delay_days', 'review_score']],
    on='order_id',
    how='inner'
)

item_physical = pd.merge(
    item_logistics,
    products[['product_id', 'product_weight_g', 'product_volume_cm3']],
    on='product_id',
    how='left'
)

# 2. 排除物理規格有遺失值的極少數異常資料
item_physical.dropna(subset=['product_weight_g', 'product_volume_cm3'], inplace=True)
print(f"清洗後可用樣本數: {len(item_physical):,} 筆")
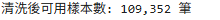
product_weight_g 是從幾十克到數十公斤的連續變數。
若直接分組,每個數值的樣本量都太少。
在資料工程中,我們會利用 分箱(Binning) 將連續數值轉換為具備業務意義的「類別變數」。
我們依照電商物流常見的重量階梯,建立 4 個分級:
# 定義分箱邊界 (以公克為單位) 與對應標籤
bins = [0, 1000, 5000, 15000, float('inf')]
labels = ['Light (<1kg)', 'Medium (1-5kg)', 'Heavy (5-15kg)', 'Extra Heavy (>15kg)']

# 使用 pd.cut 建立分箱特徵
item_physical['weight_tier'] = pd.cut(
    item_physical['product_weight_g'],
    bins=bins,
    labels=labels,
    right=True
)

# 檢視各重量區間的訂單分佈
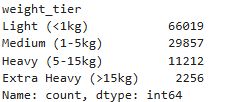
item_physical['weight_tier'].value_counts()
實作區 :
現在,我們依據 weight_tier 分組,計算各重量級別的延遲交付率 (delay_rate) 與平均評價星等:
# 依重量級別聚合計算延遲率與平均評分
tier_summary = item_physical.groupby('weight_tier', observed=False).agg(
    total_items=('order_id', 'count'),
    delay_rate=('is_delayed', 'mean'),
    avg_delay_days=('delay_days', lambda x: x[x > 0].mean()), # 僅計算遲到包裹的平均遲到天數
    avg_score=('review_score', 'mean')
).reset_index()

tier_summary['delay_rate_pct'] = (tier_summary['delay_rate'] * 100).round(2)
tier_summary['avg_delay_days'] = tier_summary['avg_delay_days'].round(1)
tier_summary['avg_score'] = tier_summary['avg_score'].round(2)

tier_summary[['weight_tier', 'total_items', 'delay_rate_pct', 'avg_delay_days', 'avg_score']]
實作區 :
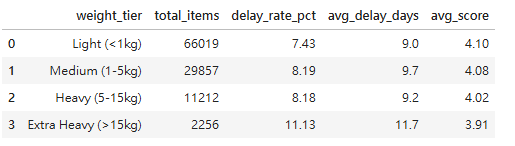
數據揭露的殘酷真相:
延遲率階梯式攀升:

   - < 1kg 的輕量件延遲率通常維持在 6%~7% 的低檔。

   -到了 > 15kg 的超大件,延遲率直接暴增至 13%~15% 以上,延遲風險翻倍!
遲到時陷得更深:
一旦發生延遲,超重件平均遲到的天數顯著長於輕量包裹(常因需要特殊卡車或缺乏中繼站暫存而滯留)。
評分連帶受挫:
超重級別的整體平均分數明顯被拉低,與 Day 12 揪出的「家具高負評」完全呼應!
今天我們打通了物流物理限制與客戶滿意度的底層關聯:
經過 13 天的探索,我們從總體營收、地理分佈、運費負擔、物流延遲,一路診斷到品類與物理規格。既然商品與履約問題已經原形畢露,那麼「賣家(Sellers)」的角色呢?
明天 Day 14,我們將把焦點轉向供給端,看看是哪些賣家在拖累平台時效,抑或是優質賣家支撐了大局!


 iThome鐵人賽
 看影片追技術