
在 Day 11 中,我們證實了「物流延遲」是摧毀買家信任、引爆 1 星負評的頭號元兇。
但如果今天物流完全準時,商品評價就一定高枕無憂嗎?答案是否定的。很多時候,差評並不是物流跳票,
而是商品本身的屬性踩了雷——例如尺寸不合、組裝困難、運送途中易碎,或是品質與照片落差過大。
今天我們將跨表引入商品資料表 (products) 與品類翻譯表,透過衍生特徵「負評率 (Bad Review Rate)」,
並配合分析師必備的「統計樣本門檻」,揪出全平台真正拖垮滿意度的隱形地雷品類!
在 olist_db 字典中,有兩張跟商品相關的關鍵表:
olist_products_dataset:記錄商品的長寬高、重量與所屬品類。
product_category_name_translation:將葡萄牙文品類名稱對照為英文的翻譯字典。
我們先將這兩張表串接起來,建立具備英文名稱的商品清單:
# 1. 取出商品表與翻譯表
products = olist_db['olist_products_dataset']
translation = olist_db['product_category_name_translation']

# 2. 將商品表與翻譯表進行 Left Join,取得英文品類名稱
products_en = pd.merge(
    products,
    translation,
    on='product_category_name',
    how='left'
)

# 3. 檢視前三筆
products_en[['product_id', 'product_category_name', 'product_category_name_english']].head(3)
實作 :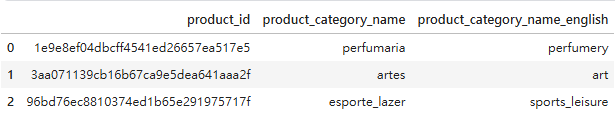
在電商營運實務中,3 星通常代表普通,4~5 星代表正向好評,而 1~2 星則會被歸類為嚴重的負向體驗(Defect / Bad Review)。
我們將商品資料與帶有評分的訂單明細串聯,並為每一筆商品評價標註是否為負評:
# 1. 將包含評分的訂單與商品明細串接
# 由於一張訂單可能包含多個品項,以 items 為橋樑進行串聯
item_reviews = pd.merge(
    items[['order_id', 'product_id']],
    orders_with_reviews[['order_id', 'review_score']],
    on='order_id',
    how='inner'
)

# 2. 接上具備英文品類的商品資料
item_category_reviews = pd.merge(
    item_reviews,
    products_en[['product_id', 'product_category_name_english']],
    on='product_id',
    how='left'
)

# 3. 衍生二元標籤:是否為 1~2 星負評
item_category_reviews['is_bad_review'] = item_category_reviews['review_score'] <= 2
實作 :
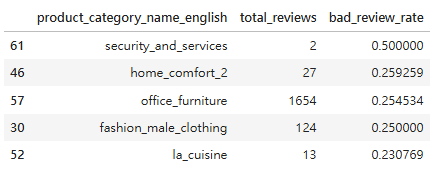
很多初學者算出各品類的負評率後,立刻執行降冪排序:
# ❌ 危險示範:無門檻排序
naive_ranking = item_category_reviews.groupby('product_category_name_english').agg(
    total_reviews=('review_score', 'count'),
    bad_review_rate=('is_bad_review', 'mean')
).reset_index()

naive_ranking.sort_values(by='bad_review_rate', ascending=False).head(5)
執行後你會發現:名列前茅的往往是 security_and_services 這類冷門品類,負評率高達 100%。
但仔細一看,它的總評論數只有 1~2 筆!這在統計學上稱為小樣本偏差(Small Sample Fallacy)。
若拿這份名單去向主管匯報「這個品類是全平台最大地雷」,營運團隊只會啼笑皆非。
老手做法:設定樣本門檻(Threshold Filtering)我們必須過濾掉評論數過少的長尾品類
(例如總評論數必須 $\ge$ 100 筆),才能反映真實的品類品質:
# 1. 聚合計算各品類的總評論數、平均星等與負評率
category_summary = item_category_reviews.groupby('product_category_name_english').agg(
    total_reviews=('review_score', 'count'),
    avg_score=('review_score', 'mean'),
    bad_review_rate=('is_bad_review', 'mean')
).reset_index()

# 2. 防呆門檻:只保留累積評論數 >= 100 筆的主力品類
significant_categories = category_summary[category_summary['total_reviews'] >= 100].copy()
significant_categories['bad_review_rate_pct'] = (significant_categories['bad_review_rate'] * 100).round(2)
significant_categories['avg_score'] = significant_categories['avg_score'].round(2)

# 3. 依負評率降冪排序,檢視真正的高風險品類
significant_categories.sort_values(by='bad_review_rate', ascending=False).head(5)
實作 :
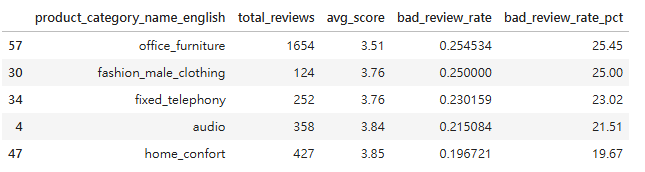
在排除極端小樣本後,真正的問題品類浮出水面:
辦公家具 (office_furniture):
負評率逼近 25%~30%,平均評分僅約 3.5 分左右。
每 4 位買家就有 1 位留下 1~2 星負評。
大型家電 / 音響器材: 負評率同樣顯著高於平均。
背後的關鍵線索:
仔細觀察這些高負評品類的物理特性,它們幾乎全數具備「體積龐大」、「重量沉重」或「結構脆弱」的特點。
在長途顛簸的物流網絡中,大件商品極易發生外箱破損、邊角碰撞,或者需要買家自行組裝卻缺少零件,
這些品類特徵與配送品質交互作用,形成了消費者體驗的重災區。
今天掌握了商品維度的深度挖掘技巧:
多表標準化: 透過翻譯字典將外文代碼映射為易於商業溝通的標準品類。
嚴防小樣本偏差: 透過評論數門檻過濾,避免極端長尾數據誤導商業決策。
定位體驗地雷: 發現大件家具與精密設備是拖垮滿意度的核心痛點。
既然辦公家具等大件品類是負評重災區,這是否與它們的「商品重量」與「包裝體積」直接相關?
明天 Day 13,我們將進一步剖析 products 中的物理規格數據,計算體積重量比與物流成本的連鎖反應!


 iThome鐵人賽
 看影片追技術