
昨天做到 Phase 4,檔案終於可以上傳進來了,但最後留了一個問題:
「上傳成功」跟「這個東西可以安全地繼續往下走」,其實是兩件不同的事情。
所以接下來進入我預計這個專案比較特別的部分 Phase 5:資安掃描。
原本我在開發計畫裡只寫這幾行:
→ 串接掃描功能
→ 建立掃描中狀態
→ 處理掃描成功與失敗
→ 決定掃描未完成時能不能進入下一個流程
→ 確認使用者不能自己跳過掃描
→ 保存掃描結果與對應版本
乍看之下好像很簡單,但光第一個「串接掃描功能」這部分就比較麻煩。
要串什麼?掃什麼?要找現成工具,還是乾脆叫 AI 幫我寫?
掃到東西之後,是全部擋掉,還是有些只要警告?如果 Scanner 自己掛掉又該怎麼辦?
所以這個 Phase,我打算仔細說一下
這裡講的掃描,絕對不是檔案上傳之後丟給防毒軟體,沒有發現病毒就算通過。
這個平台預計收的是 HTML、CSS、JavaScript 這類靜態網站。就算檔案裡沒有 Malware,也不代表它就符合企業允許上架的規則。
例如一個完全正常的 HTML,可能會從外部 CDN 載入 JavaScript;JavaScript 裡也可能透過 fetch()、XMLHttpRequest、WebSocket、sendBeacon() 跟外部服務連線,甚至把資料送出去。程式碼裡也可能直接寫著 API Key、Token、密碼,或是使用了存在已知漏洞的第三方套件。
這些東西不一定是 Malware,防毒軟體也不會把它們判斷成惡意程式,但對企業來說真正想知道的其實是:
「這個網站放進來之後會做什麼?有沒有我們不允許的行為?符不符合上架的規則?」
所以這裡講的「掃描」,似乎沒有這麼容易。
先不管最後要用什麼工具,以「HTML / CSS / JavaScript 靜態網站」這種上傳內容來說,我先把想做的檢查拆開來看,大概會有這幾類:
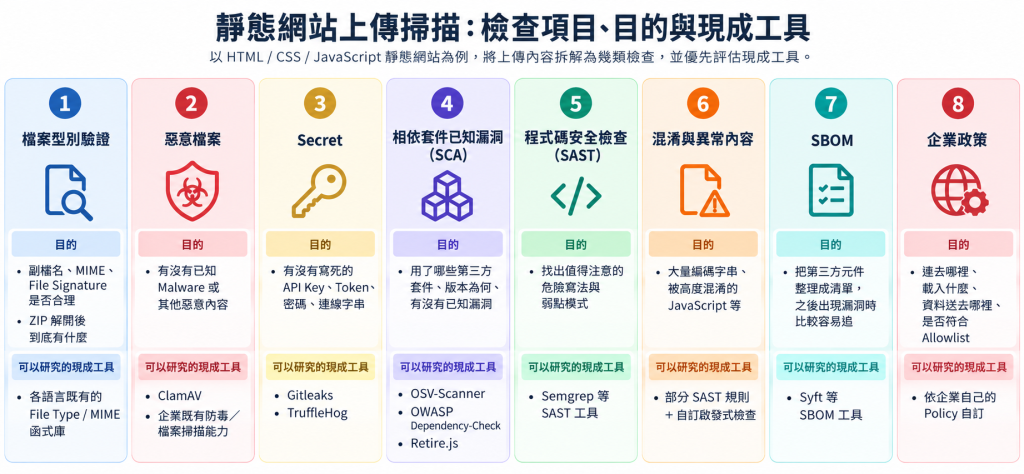
列完之後其實會發現,前面大部分的能力都不是什麼新的技術問題,早就已經有人在做了。
所以我第一個想法不是:
「這些 Scanner 我要怎麼寫?」
而是:
「這些東西有沒有成熟的工具可以直接用?」
商業 AppSec 平台當然有,而且有些產品已經把 SAST、SCA、Secret Detection 等能力整合在一起。
如果企業本來就有採購,而且授權與功能都符合需求,那當然先研究既有產品能不能直接利用。
但如果沒有,我會建議先從成熟的開源工具開始評估。
原因其實也跟我前面一直在講 AI 降低開發門檻有關。
其實很多「工具免費」但你以前要透過自己開發把所有東西串起來很花時間 。
就算我知道 ClamAV 可以掃 Malware、Gitleaks 可以找 Secret、Semgrep 可以做 SAST,我還是得自己研究每套工具怎麼安裝、參數怎麼下、怎麼呼叫、輸出格式長什麼樣子,再寫程式把它們全部串起來。
對一個原本就不是專職軟體開發的人來說,真正困難的可能不是「找不到工具」,而是:
我知道工具都在那裡,但我要怎麼把它們組成我要的系統?
這件事情在有 AI 之後,就開始變得不太一樣。
做到這裡還剩下一個問題。
前面的 Malware、Secret、SAST、SCA,都有相對成熟的工具可以處理,但是:
「哪些 Domain 可以連?哪些外部資源可以載入?哪些行為是我們企業允許的?」
這件事情沒有一套開源 Scanner 可以直接告訴我答案。
因為這不是全世界共同的安全標準,而是企業自己的 Policy。
ClamAV 不會告訴我:「這個 HTML 沒有 Malware,但是它用了公司不允許的外部 CDN。」
Gitleaks 也不會知道:「這個 Domain 在我們公司到底能不能連。」
這一塊就是我們真正需要自己開發的地方。
例如利用 HTML Parser 找出 <script src>、<iframe src>、<form action>、<img src>、<link href>,再從 JavaScript 找出 fetch()、XMLHttpRequest、WebSocket、sendBeacon() 等可能產生外部連線的位置,把目的 Domain 整理出來,再跟平台自己的 Allowlist 比對。
這時候 AI 就非常適合拿來做這件事情。
因為我要它做的不是:「幫我發明一套新的資安掃描技術。」
而是:「把我們已經定義好的企業規則,變成可以自動執行的程式。」
所以研究到最後,我真正要做的其實不是一套「萬能 Scanner」。
而是:
成熟的安全能力,用現成工具。
不同工具之間的整合,讓 AI 幫我串。
只有企業自己知道的規則,再讓 AI 幫我做成 Policy Check。
這樣看起來,就合理多了。
原本看到「串接掃描功能」,我腦中想的可能只是:
Upload → Scanner → PASS / FAIL
真的拆開之後,我覺得它最後反而比較像一條 Scanning Pipeline。例如檔案上傳之後,先做基本檔案型別檢查,再交給 Malware Scanner;接著做 Secret Scan、Dependency Scan、程式碼規則檢查,最後再跑企業自己的 Policy Check,全部完成後由平台把結果彙整起來。
概念上可能會變成:
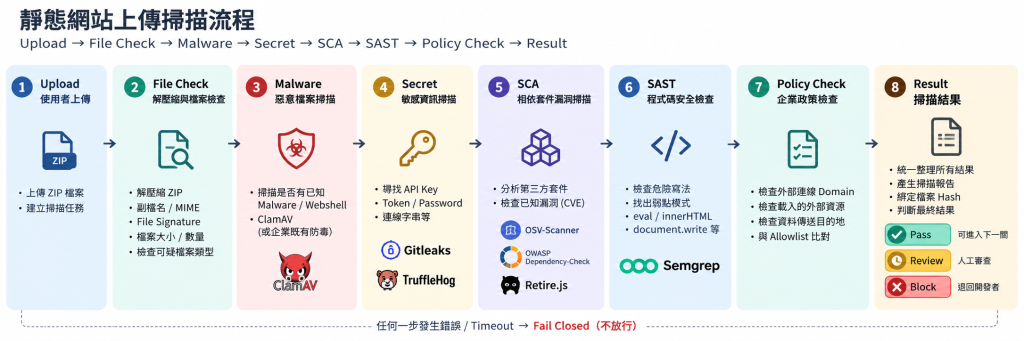
每一個 Scanner 做自己擅長的事情,平台不需要自己變成一套萬能掃描器。
而 AI 真正幫上忙的地方,反而是在中間那些以前很麻煩的事情:幫我研究工具怎麼呼叫、串 API 或 CLI、解析不同工具輸出的 JSON、統一結果格式、建立自訂規則、處理錯誤、最後把所有結果收進平台。
這其實也跟我前面一直想講的事情很像。以前 Infra 人員可能知道有這些工具,也知道自己想檢查什麼,但真的要把五六套東西串成一條流程,光研究 API、資料格式和寫程式就很花時間。現在 AI 降低的,反而是把這些既有能力整合起來的開發門檻。
Policy Scanner 如果真的開始做,我覺得第一件事情不是看到外部網址就 Block,而是先回答一個更基本的問題:
「這個網站到底串了哪些外部網址?」
例如掃描 HTML、CSS、JavaScript 之後,把發現的外部 Domain、完整 URL,以及它出現的位置全部整理出來。
但只有網址清單其實還不夠。
因為同樣是 https://example.com,拿來做什麼,代表的風險可能完全不一樣。
如果它出現在 <a href>,可能只是參考文獻、期刊或公家機關網站,使用者自己點擊之後才會離開頁面;如果出現在 <script src>,代表頁面會主動從外部載入 JavaScript;如果出現在 fetch()、XMLHttpRequest、WebSocket、sendBeacon(),則可能代表頁面會主動跟外部服務交換資料。
所以 Policy Scanner 真正要整理的應該不只是:
「發現 5 個外部 URL。」
而是:
| 外部網址 | 發現位置 | 用途 | 初步分類 |
|---|---|---|---|
journal.example.org |
<a href> |
使用者點擊外部連結 | External Link |
cdn.example.com |
<script src> |
載入外部 JavaScript | External Resource |
api.example.com |
fetch() |
呼叫外部 API | Data / API Connection |
log.example.com |
sendBeacon() |
向外傳送資料 | Outbound Data |
socket.example.com |
WebSocket() |
建立持續外部連線 | External Connection |
有了這份清單之後,平台才進一步拿 Domain 跟企業自己的 Allowlist 比對,再依照用途決定是 Pass、Review 還是 Block。
所以我的規則不會只是: 找到外部網址 → Block
而會是:找到外部網址 → 判斷用途 → 整理外部連線清單 → Allowlist 比對 → 套用企業 Policy
這樣最後產生的掃描報告,我真正想看到的就不是「有沒有連外」而已。
而是:「這個網站會跟誰連線?為什麼連?是使用者自己點的,還是程式會主動連?有沒有可能把資料送出去?」
知道這些之後,我才有辦法決定它能不能上架。
前面把外部網址整理出來之後,下一個問題就是:掃到東西,要怎麼判斷?
如果 Scanner 看到 CDN 就 Fail、看到 inline script 就 Fail、看到 innerHTML 就 Fail、看到外部連結也 Fail,最後很可能變成所有東西都上不來。
平台確實很安全,但使用者可能也會覺得:「放你這裡怎麼這麼麻煩?我原本放外面明明就可以用。」
最後大家又跑回去擺路邊攤,那前面做的治理也沒有意義。
所以我覺得 Scanner 找到東西之後,不應該直接只有 PASS 或 FAIL,而是先產生一筆一筆的 Finding(掃描發現),告訴我到底發現了什麼。
例如可以先把 Finding 分成幾類:
Block:明確違反平台政策
例如 Credential 直接寫在程式碼裡、程式會把資料送到未核准的外部服務、出現平台明確禁止的檔案型別。這些是已經定義好的規則,不需要再猜,命中就不能繼續往下走。
Warning / Review:需要進一步確認
例如使用第三方 CDN、inline script、innerHTML、localStorage。這些東西本身不一定就是漏洞,要看它怎麼用、資料從哪裡來、裡面放了什麼,所以 Scanner 可以先標記出來,交給後續審查。
Information:單純盤點出來
例如這個網站有哪些外部超連結、使用哪些第三方套件、產生了哪些 SBOM 元件。這些不一定代表有安全問題,但可以放進報告,讓後續審查的人知道這個網站到底用了什麼。
所以 Scanner 真正應該產出的,不是一句:「安全。」
而是一份:
「我找到了什麼、風險在哪裡、哪些東西一定要改、哪些東西需要人確認。」
最後平台再根據這些 Finding,產生這一版程式的整體結果:
Pass → 沒有阻擋項目,也沒有需要人工確認的問題。
Review → 沒有明確需要 Block,但有些項目需要人工確認。
Block → 命中明確禁止的規則,退回修改。
這樣「Scanner 找到了什麼」跟「這個版本最後能不能往下走」,就是兩件不同的事情。
另外,如果其中一套 Scanner 執行失敗或 Timeout,我不會把它視為掃描通過;沒有完成必要的安全檢查,就不能產生 Pass 結果。 至於服務異常、重試、監控與告警,則留到後面的維運階段再處理。
原本開發計畫裡只有短短一句: ** 串接掃描功能**
真的拆開來之後,才發現第一個問題根本不是「Scanner 要怎麼寫」,而是:
哪些東西應該自己寫?哪些東西根本不該自己寫?
Malware、Secret、Dependency、SAST 這些已經有成熟工具在處理的能力,我會優先評估既有工具,不需要因為現在有 AI,就全部重新發明一次。
企業自己的 Policy,例如哪些 Domain 可以連、哪些外部資源可以載入、什麼行為不允許,則由我們自己決定規則,再讓 AI 幫忙把規則做成程式。
最後 AI 真正幫我的,不是「做一套 Scanner」,而是:
幫我把一堆原本各做各的工具,串成一條我真正需要的 Scanning Pipeline。
但做到這裡,我最多只能證明:「這一版檔案,已經通過平台設定的自動檢查。」
它不代表這個工具從此就是「安全的」,更不代表可以直接上架。
因為 Scanner 能幫我找 Malware、Secret、已知漏洞、危險寫法,也能依照我們事先定義好的 Policy 自動檢查,但還是有一些事情需要放回實際情境裡判斷。
所以自動掃描通過之後,下一關不是「上架」。


 iThome鐵人賽
 看影片追技術