

今天我們來聊聊 Reward Hacking ~
Example:OpenAI 賽艇實驗 https://openai.com/index/faulty-reward-functions/
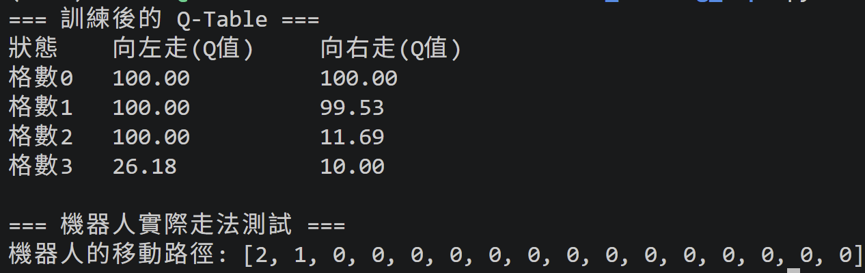
獎勵函數是:
Agent 會把「存活」與「持續獲得獎勵」當成一種有利行為。如果不斷地避免抵達終點,可能會比快速抵達終點獲得更多總獎勵。這會讓 agent 學到一種「不是我們真正想要的」策略,例如:繞來繞去、避免終止,以獲取更多中間獎勵為優先。
這就是 Reward Hacking:agent 優化了我們設計出的獎勵形式,但卻沒有真的學到目標任務。
獎勵被改成更有方向性的設計:
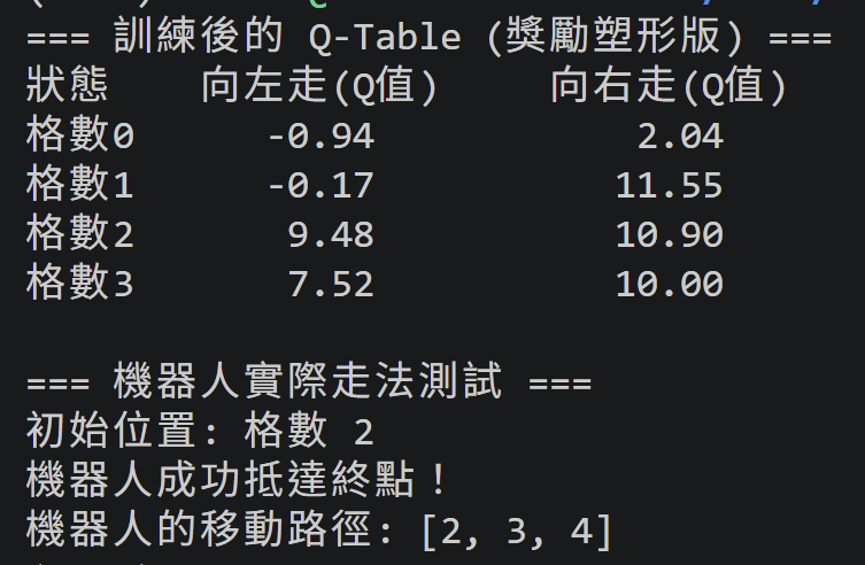
原本的 Agent 會把「存活」與「持續獲得獎勵」當成有利行為,寧可繞來繞去、避免終止以獲取更多中間獎勵。加入了「向左 -1」與「撞牆 -5」的設計後,Agent 只要做出遠離目標或無意義的碰撞,就會立刻面臨扣分代價。Agent 不只看重最終結果,還學會了規避錯誤行為。
看完了 Agent 是如何鑽漏洞「作弊」之後,明天我們要把焦點轉向 Agent 最強大的進化武器——自我對弈與自我優化迴圈 (Self-play / Self-improvement Loop)!


 iThome鐵人賽
 看影片追技術