

今天要開始實作了,首先要先建立環境以及 Evaluation Dataset。
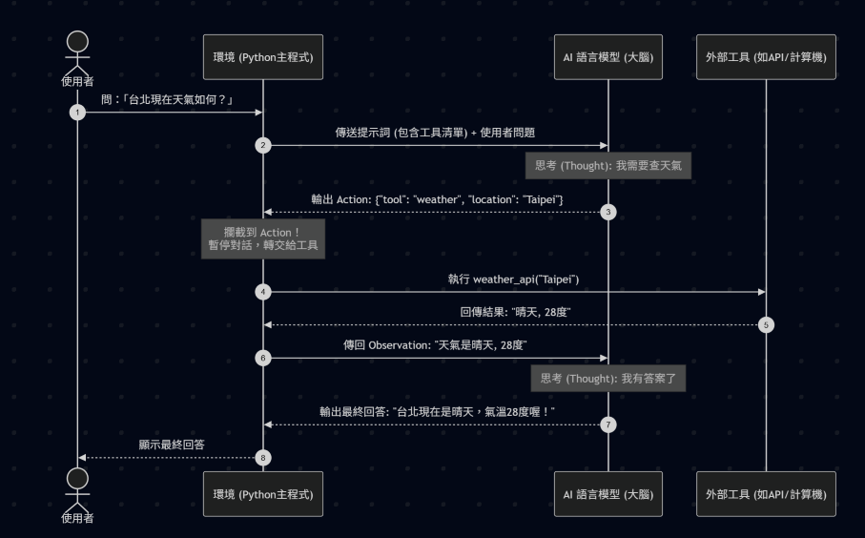
工具呼叫環境是連接 AI 語言模型與外部世界的橋樑,負責執行 AI 想做的動作並回傳結果。
LLM本身只是一顆沒有手腳的「純大腦」,它無法上網查資料,也不一定能算對複雜數學。我們寫的「環境」,就像是這顆大腦的「手與眼睛」。當 AI 決定要用工具時,環境會攔截這個指令,幫它按鈕執行,再把螢幕上的「結果(Observation)」傳回給 AI 繼續思考。
實作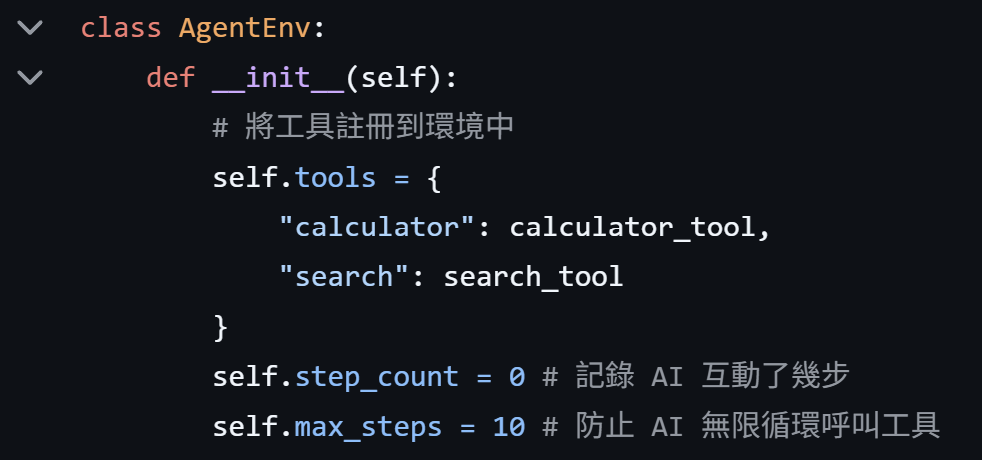
實作兩個小工具: calculator 與 search
評測資料採用 JSON list,每一筆任務都包含:
LLM是只有文字輸入與輸出的純大腦。它沒有連網能力、也不會算數學。我們要讓它能使用工具,必須做到三件事:
這個最經典的架構稱為 ReAct(Reasoning and Acting,推理與行動)
今天的目標是把Agent的基礎架構搭好,並建立好評估資料集,為後續的訓練鋪路。
AgentEnv.step()
例子
實作結果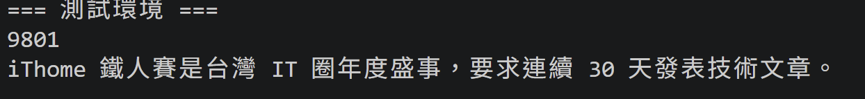
資料準備好後,明天會完成評估腳本,並載入純 SFT 模型(Baseline)讓它試寫這份考卷,建立起 RL 訓練前的重要基準點。


 iThome鐵人賽
 看影片追技術