
昨天我們用 wrk 把 server 打了一輪,從 14,000 req/s 優化到 35,000 req/s,
做的事情基本上都是「同一個 process 裡面」的優化 —— 快取不變的資料、改用 routes、拿掉同步阻塞。
但如果你昨天有邊壓測邊開 btop 或 htop 看,會發現一件很刺眼的事:
我 8 核心的機器,怎麼壓測的時候只有一顆核心在燒?其他 7 顆在納涼?
這就是今天要解決的問題。今天我們不再優化「單一 process 跑多快」,
而是換個角度:怎麼把整台機器的核心都吃滿。
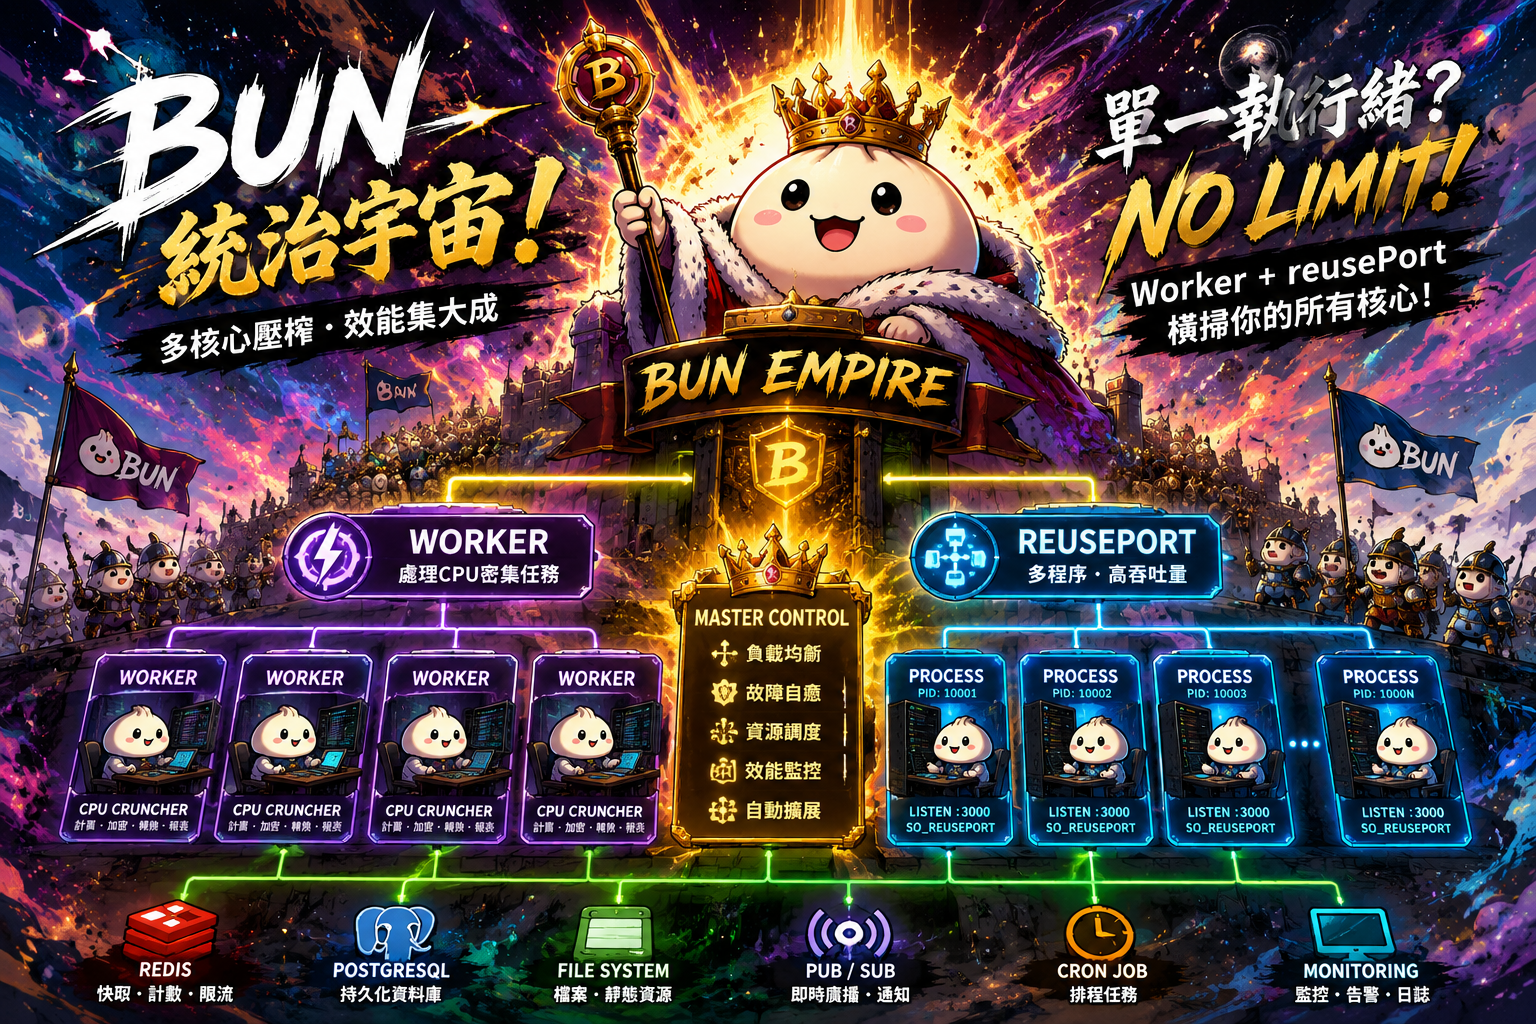
Bun 這邊提供了兩條路,一條是 Worker(同一個 process 內開多執行緒),
另一條是 reusePort(開多個 process 共用同一個 port)。
這兩條路解決的是不同的問題,很多人會搞混,今天我們就把它講清楚,順便用昨天的壓測腳本再驗證一次。
先講清楚原因,不然後面會不知道自己在幹嘛。
Bun 底層雖然有多執行緒(檔案 I/O、網路 I/O、部分 API 都會丟到 thread pool 去跑),
但是你寫的那些 JavaScript 程式碼,是跑在單一一條主執行緒上的,
也就是我們常聽到的 event loop。
這代表:
昨天的優化屬於「減少主執行緒的工作量」,
今天的做法則是「多找幾條執行緒 / 幾個 process 一起做」。
先給一張決策表,看完再往下實作:
Worker(多執行緒) |
reusePort(多 process) |
|
|---|---|---|
| 隔離層級 | 同一個 process,不同執行緒 | 完全獨立的 process |
| 記憶體 | 各自獨立的 heap,但共用 process 資源 | 完全獨立,每個都是一份完整的 Bun runtime |
| 適合解決 | 單一請求裡的 CPU 密集運算 卡住 event loop | 整體 吞吐量 上不去、想吃滿所有核心 |
| 資料共享 | postMessage(structured clone)或 SharedArrayBuffer |
不能直接共享,要靠外部(Redis / DB / 檔案) |
| 崩潰影響 | 該 worker 掛掉,主執行緒還活著 | 該 process 掛掉,其他 process 完全不受影響 |
| 記憶體成本 | 較低 | 較高(N 份 runtime) |
一句話總結:
單一請求太慢 → 用 Worker;整體吞吐太低 → 用 reusePort。
兩個問題同時存在,那就兩個一起用。
我們故意寫一個會卡住 event loop 的 API,模擬一些真實情境(大量計算、加密、資料轉換):
server-bad.ts
// 模擬一個 CPU 密集的運算,比如報表加總、雜湊計算
function heavyCompute(n: number): number {
  let sum = 0;
  for (let i = 0; i < n; i++) {
    sum += Math.sqrt(i) * Math.sin(i);
  }
  return sum;
}

Bun.serve({
  port: 3000,
  routes: {
    "/ping": () => new Response("pong"),
    "/heavy": () => {
      const result = heavyCompute(5_000_000);
      return Response.json({ result });
    },
  },
});

console.log("server on http://localhost:3000");
先壓 /ping 看基準:
wrk -t4 -c100 -d10s http://localhost:3000/ping
再壓 /heavy:
wrk -t4 -c100 -d10s http://localhost:3000/heavy
你會看到 /heavy 的數字慘不忍睹。更慘的是,你可以開兩個終端機,
一邊壓 /heavy,一邊壓 /ping,會發現原本很快的 /ping 也一起被拖下水 ——
這就是 event loop 被阻塞的實際感受,一支慢 API 可以拖垮整台 server。
Bun 實作了標準的 Web Worker API,寫法跟瀏覽器幾乎一樣。
worker.ts
declare var self: Worker;

function heavyCompute(n: number): number {
  let sum = 0;
  for (let i = 0; i < n; i++) {
    sum += Math.sqrt(i) * Math.sin(i);
  }
  return sum;
}

self.onmessage = (event: MessageEvent) => {
  const { id, n } = event.data;
  const result = heavyCompute(n);
  // 把 id 帶回去,主執行緒才知道這是哪一筆請求的結果
  postMessage({ id, result });
};
注意那個 id:Worker 的訊息是非同步且無序的,
你同時丟 10 個任務進去,回來的順序不保證跟送出的順序一樣,
所以一定要自己帶一個關聯用的 id,不然結果會對到別人身上(這是很常見的雷)。
只開一個 Worker 是不夠的,那只是把塞車地點換個位置而已。
我們照著核心數開一組 pool,並做簡單的輪詢分派:
pool.ts
type Task = {
  resolve: (value: number) => void;
  reject: (reason?: unknown) => void;
};

export class WorkerPool {
  private workers: Worker[] = [];
  private tasks = new Map<number, Task>();
  private nextId = 0;
  private cursor = 0;

  constructor(size: number = navigator.hardwareConcurrency) {
    for (let i = 0; i < size; i++) {
      const worker = new Worker(new URL("./worker.ts", import.meta.url).href);

      worker.onmessage = (event: MessageEvent) => {
        const { id, result } = event.data;
        const task = this.tasks.get(id);
        if (!task) return;
        this.tasks.delete(id);
        task.resolve(result);
      };

      worker.onerror = (event) => {
        console.error("worker error:", event.message);
      };

      this.workers.push(worker);
    }
  }

  run(n: number): Promise<number> {
    return new Promise((resolve, reject) => {
      const id = this.nextId++;
      this.tasks.set(id, { resolve, reject });

      // round-robin 輪流分派
      const worker = this.workers[this.cursor];
      this.cursor = (this.cursor + 1) % this.workers.length;
      worker.postMessage({ id, n });
    });
  }

  terminate() {
    for (const worker of this.workers) worker.terminate();
  }
}
navigator.hardwareConcurrency 在 Bun 裡可以直接拿到 CPU 核心數,
不用再去 import os from "node:os" 繞一圈。
server-worker.ts
import { WorkerPool } from "./pool";

const pool = new WorkerPool();

const server = Bun.serve({
  port: 3000,
  routes: {
    "/ping": () => new Response("pong"),
    "/heavy": async () => {
      const result = await pool.run(5_000_000);
      return Response.json({ result });
    },
  },
});

// 優雅關閉,不然 Ctrl+C 之後 worker 可能還掛在那邊
process.on("SIGINT", async () => {
  pool.terminate();
  await server.stop();
  process.exit(0);
});

console.log(`server on ${server.url}`);
現在再跑一次「一邊壓 /heavy、一邊壓 /ping」,
你會發現 /ping 幾乎不受影響了 —— 因為主執行緒現在只負責收發請求跟轉派,
真正燒 CPU 的活都在別條執行緒上。
postMessage 走的是 structured clone,資料是複製過去的,不是共享。
所以如果你丟一個 50MB 的物件進 Worker,光複製就要花不少時間,
可能比你省下來的運算時間還多。
幾個處理原則:
ArrayBuffer 可以用轉移所有權的方式送過去,零複製。const buffer = new ArrayBuffer(1024 * 1024 * 10);
// 第二個參數指定要轉移的物件,轉移後主執行緒這邊的 buffer 就不能再用了
worker.postMessage({ buffer }, [buffer]);
Worker 解決的是「單一請求卡住大家」,
但如果你的 API 每一支都很輕、就是純粹請求量太大,那 Worker 幫不上什麼忙 ——
因為主執行緒收發請求本身就是瓶頸。
這時候要做的是開多個 process,讓每個 process 都有自己的主執行緒。
問題來了:多個 process 要怎麼監聽同一個 3000 port?
一般來說第二個會直接噴 EADDRINUSE。答案是 SO_REUSEPORT,
Bun 把它包成一個設定就好:
server-cluster.ts
const server = Bun.serve({
  port: 3000,
  reusePort: true,   // 關鍵就這一行
  routes: {
    "/ping": () => new Response(`pong from pid ${process.pid}`),
  },
});

console.log(`worker ${process.pid} listening on ${server.url}`);
開啟之後,作業系統核心會幫你把進來的連線分配到各個 process,
不需要自己在前面架一層 proxy 做負載平衡,也不用像 Node.js 那樣走 cluster 模組
由 master process 轉派(那層轉派本身就是額外成本)。
手動開 8 個終端機當然不切實際,我們寫一支 launcher,用 Bun.spawn 把它們拉起來:
cluster.ts
const cpus = navigator.hardwareConcurrency;
const procs: Bun.Subprocess[] = [];

function spawnWorker(index: number) {
  const proc = Bun.spawn({
    cmd: ["bun", "./server-cluster.ts"],
    stdout: "inherit",
    stderr: "inherit",
    env: { ...process.env, WORKER_INDEX: String(index) },
  });

  // 意外死掉就自動重生,避免一個 process 崩了就少一份戰力
  proc.exited.then((code) => {
    if (shuttingDown) return;
    console.warn(`worker ${index} exited with code ${code}, respawning...`);
    procs[index] = spawnWorker(index);
  });

  return proc;
}

let shuttingDown = false;

for (let i = 0; i < cpus; i++) {
  procs[i] = spawnWorker(i);
}

console.log(`cluster started with ${cpus} workers`);

// Ctrl+C 的時候要記得把小孩一起帶走,不然會變成孤兒 process 佔著 port
const shutdown = () => {
  shuttingDown = true;
  for (const proc of procs) proc.kill();
  process.exit(0);
};

process.on("SIGINT", shutdown);
process.on("SIGTERM", shutdown);
執行:
bun ./cluster.ts
然後拿昨天的 wrk 指令再打一次:
wrk -t8 -c400 -d30s http://localhost:3000/ping
這時候再開 btop 看,你會發現所有核心都在跳了。
這點非常重要,很多人踩過:
SO_REUSEPORT 會做連線層級的負載平衡,SO_REUSEPORT 語意不同,行為比較接近「允許重複綁定」,所以你在 Mac 上跑 reusePort 測出來「好像沒變快」,
不代表這招沒用,而是平台行為不同。實際效果請以你的部署環境(通常是 Linux 容器)為準。
這是 reusePort 最容易忽略的代價 —— 你的 process 從 1 個變成 N 個,
所有「存在記憶體裡的狀態」全部都會出問題:
| 原本的做法 | 多 process 之後會怎樣 | 解法 |
|---|---|---|
const cache = new Map() 記憶體快取 |
每個 process 各有一份,命中率掉到 1/N,資料還可能不一致 | 改用 Redis 或接受不一致 |
| 記憶體版 rate limit 計數器 | 使用者被分到不同 process,實際上限變成 N 倍 | 集中式計數(Redis) |
WebSocket 的 server.publish() 廣播 |
只會廣播到「同一個 process 上」的連線 | 外部 pub/sub 中轉 |
排程任務 setInterval |
同一個任務被執行 N 次 | 只讓 WORKER_INDEX === "0" 的跑 |
| SQLite 寫入 | 多 process 同時寫會鎖 | 開 WAL 模式,或集中由單一 process 寫 |
那個 WORKER_INDEX 環境變數就是為了處理排程用的:
// 只有 0 號 worker 負責跑排程,其他的專心服務請求
if (process.env.WORKER_INDEX === "0") {
  setInterval(() => {
    console.log("cron job running...");
  }, 60_000);
}
如果你昨天做的那個「預先計算並快取」的優化是存在記憶體 Map 裡的,
今天開了 8 個 process 之後,就等於算了 8 次、存了 8 份 —— 記憶體用量直接乘以 8。
這是要自己拿捏的取捨。
不是越多越好。幾個經驗法則:
navigator.hardwareConcurrency 拿到的是宿主機的核心數,const size = Number(process.env.WORKER_COUNT ?? navigator.hardwareConcurrency);
然後在 Day23 那份 docker-compose 或 K8s 設定裡,把它跟 CPU limit 對齊。
| 版本 | Req/Sec | p50 延遲 | p99 延遲 | CPU 使用率 |
|---|---|---|---|---|
| Day28 單 process | 35,224 | 5.65ms | 6.7ms | 約 1 核滿載 |
| 8 process reusePort | (填入你的實測數字) | 多核平均分佈 |
老話一句:以上數字請以自己機器實測為準。
而且吞吐量不會剛好變成 8 倍 —— 網路卡、kernel、壓測工具本身都會先成為瓶頸,
能拿到 4~6 倍就已經是很不錯的結果了。
以為 Worker 可以提升吞吐量:如果你的 API 本來就很輕,
把它丟進 Worker 只會多一趟訊息傳遞的成本,數字反而更難看。Worker 是拿來救 CPU 密集任務的。
在 Worker 裡面做 I/O:讀檔、打 DB 這些本來就是非同步、不會卡 event loop 的事情,
丟進 Worker 完全沒有意義。
忘記關 Worker:terminate() 沒呼叫,process 會關不掉,開發的時候會很困擾。
多 process 之後才發現狀態壞掉:這是最痛的,通常是上線後才發現「為什麼有時候登出了、有時候又沒有」,
記得上線前先把上面那張表掃過一遍。
在 Mac 上測 reusePort 就下結論:前面講過了,平台語意不同,要在部署環境測。
今天我們把 Day28 的優化再往前推了一步,從「讓單一 process 跑更快」變成「把整台機器用滿」:
Worker 解決的是 單一請求太慢、卡住其他人 的問題,reusePort 解決的是 整體吞吐量上不去 的問題,而不管走哪一條,Day28 的心法今天一樣適用:先量測、再優化、優化完再量測。
沒有先確認瓶頸在 CPU 還是 I/O 就急著開 Worker 或開叢集,
很有可能只是換來一台更複雜、但沒有比較快的 server。


 iThome鐵人賽
 看影片追技術