
PokeThreads 裡有一種資料,我們從很早就開始提到,卻從來沒有認真設計過,就是計數(Counter)。
Day 8 討論 Cache 的時候,用 Like Count 當例子說明什麼資料適合被 Cache;Day 17 討論 CAP Theorem 時,又拿 Like Count 當作 Eventual Consistency 的範例。
今天終於要正面處理這個問題:Like、View、Follower 這些數字,到底該怎麼設計才撐得住?
一般直覺的實作方式大概是這樣:
UPDATE posts
SET like_count = like_count + 1
WHERE id = :post_id;
Pikachu 按讚,執行這支 SQL,like_count 加 1。
回想 Day 21 討論過的 Hot Post,如果 Pikachu 發的某篇貼文突然爆紅,短時間內湧入大量的 Like,會發生什麼事?
Request 1  → UPDATE posts SET like_count = like_count + 1 WHERE id = 123
Request 2  → UPDATE posts SET like_count = like_count + 1 WHERE id = 123
Request 3  → UPDATE posts SET like_count = like_count + 1 WHERE id = 123
...(同時湧入數千筆)
這幾千個 Request 全部指向同一列資料,Database 為了保證資料正確,需要對這一列做 Row-level Lock(列鎖定),同一時間只能有一個 Write 真正生效,其他 Request 只能排隊等待。
這跟 Day 21 的 Hot Key 問題本質上是同一件事,不是 Database 撐不住整體流量,而是某一筆特定資料被過度集中地寫入,形成寫入熱點(Write Hotspot)。
既然我們已經有 Day 12 的 Message Queue,很自然的想法是 Like 不要直接寫 Database,先發一個事件進 Queue。
POST /like
    ↓
Publish "post_liked" 事件
    ↓
Response(不用等 Database 更新完成)
背景則由一個 Aggregator Worker 持續消費這些事件,在一小段時間窗口內(例如每秒)把同一篇貼文的 Like 事件加總起來,最後只對 Database 送出一次批次更新:
UPDATE posts
SET like_count = like_count + 100
WHERE id = 123;
原本可能是 1000 次個別的 UPDATE,現在變成 10 次批次的 UPDATE,Row Lock 的競爭程度大幅下降。
代價是 Like Count 不再是「即時精確」的數字,而是有那麼一小段延遲,這是之前談過的 Eventual Consistency 又出現在我們的系統裡。
批次彙總能減少 Write 次數,但如果流量真的大到誇張,還能再進一步:把一個 Counter 拆成好幾份。
與其讓所有 Server / Worker 都去搶同一個 like_count,不如拆成多個 Sub-counter:
like_count_shard_0
like_count_shard_1
like_count_shard_2
...
like_count_shard_9
不同的 Server 或 Worker 依照某種規則(例如自己的 ID 取餘數)分別去更新不同的 Sub-counter,寫入壓力就被分散到 10 個獨立的資料列,而不是擠在同一列上互搶 Lock。
要讀取總數時,把所有 Sub-counter 加總即可:
SELECT SUM(count) FROM like_count_shards WHERE post_id = 123;
這跟 Day 18 Database Sharding 的精神其實一模一樣,只是這次拆的不是整張表,而是一顆特定的熱點計數器。
批次彙總、拆分熱點都還是圍繞著「怎麼讓 Database 少做一點事」,另一個常見做法是乾脆讓計數這件事完全不經過 Database。
Redis 的 INCR 指令是原子操作(Atomic),效能非常高,很適合拿來當作即時計數器:
INCR post:123:like_count
所有 Like 事件都先累加在 Redis 裡,Database 只需要定期(例如每分鐘)把 Redis 目前的數字批次寫回去做持久化,架構大致如下:
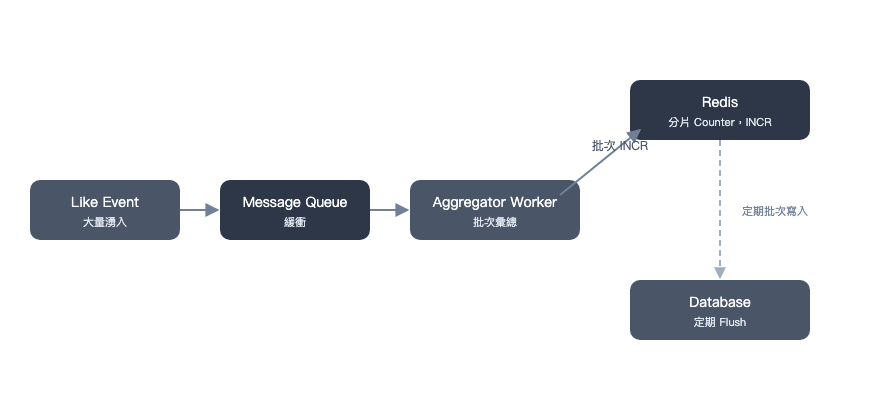
這個做法把「高頻寫入」全部交給天生就適合處理大量原子操作的 Redis,Database 則退居成「定期備份數字」的角色,寫入壓力幾乎完全消失。
| 做法 | 解決的問題 | 代價 |
|---|---|---|
| 批次彙總(透過 Queue) | 降低 Write 次數 | Count 有小延遲 |
| 分片 Counter | 分散單一熱點的 Lock 競爭 | 讀取時要多做一次加總 |
| Redis 累加 + 定期 Flush | 把高頻寫入完全移出 Database | Redis 掛掉可能遺失還沒 Flush 的部分計數 |
實務上這三招經常一起用:
Redis 負責扛住瞬間的高頻寫入,內部再視情況做分片,背景 Worker 定期把數字批次寫回 Database 做長期保存。
要提醒的是,不是所有計數都需要這麼講究。
像 View Count 這種本來就不太要求精確、使用者也不會逐一核對的數字,可以大方地接受更長的延遲甚至偶爾誤差。
但如果是牽涉金錢的計數(例如某些平台的付費贊助次數),可能就需要更接近 Day 17 提到的 Strong Consistency,寧可犧牲一點效能也要保證數字正確。
一個看似單純的 +1,在高流量下其實藏著典型的 Write Hotspot 問題。
今天的三個解法:
核心精神都一樣:不要讓大量並發寫入直接打在同一筆資料上,而是想辦法把寫入分散開來,或是把「即時精確」換成「最終正確」,用一點點延遲,換取系統撐住規模的能力。


 iThome鐵人賽
 看影片追技術