

經過前幾天的擴建,我們的 AI 管家已能處理 YouTube 影片、網頁、PDF 連結與純手打文字等截然不同的輸入支線。但在將這些支線匯流給 Gemini 處理時,目前隱藏著自動化 pipeline 中的一個問題,就是資料格式不一致。
如果直接將所有通道連上 Gemini 節點並統一讀取 {{ $json.text }},當系統接收到純手打文字時,AI 會因為找不到對應欄位而出現錯誤。
強健系統的四大核心思維
因次在進行資料收斂前,必須掌握系統設計的底層邏輯,避免 pipeline 變得難以維護。
實作步驟:打造輕量級 Adapter
系統不需要去猜進來的格式,只需在純文字通道加上適配器,將深層的 body.text 映射為標準的 text 欄位:
{{ $json.body.text }}。清理多餘資料:強烈建議開啟節點設定中的 Keep Only Set,將 Webhook 帶來的雜亂 Metadata 一併丟棄,確保流向 AI 的只有純淨的 text 欄位。
終點匯流:將三個通道(YouTube HTTP 節點、URL HTTP 節點、純文字 Edit Fields 節點)的輸出端,全部連接至同一個 Gemini 摘要節點。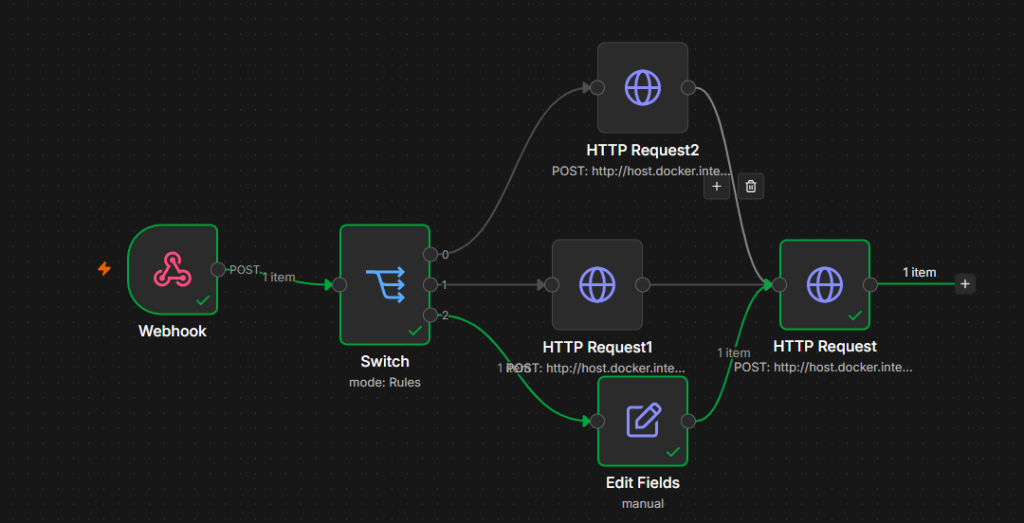
這套「特例分流 -> 各自解析 -> 格式統一 -> 集中處理」的 Input Router 架構,到今天正式大功告成。無論未來再加入多少種新的檔案格式,只要遵循這個 Normalization 守則,核心的 AI 邏輯就不需要修改。


 iThome鐵人賽
 看影片追技術