

昨天 Day 7 的文章先把一筆 Guardrails 測試案例寫成種子資料(Seed Contract),分清楚哪些條件要固定、哪些內容可以變化,以及哪些資訊不能交給模型自行生成而產生幻覺(Hallucination)。
有了種子資料(Seed Data)下一個直覺做法(又是直覺)通常是把所有要求塞進同一個 Prompt:然後請模型生成含 PII 的客服對話、再產出去識別化版本、列出偵測到的實體、一起回傳標註結果,最後一次拿到完整 JSON,看起來省事、也很像已經有一筆可以拿去測 Guardrails 的資料。
問題是:如果輸出錯了,要從哪裡查起?是 LLM 生成有問題、去除 PII 有問題?還是出在哪裡?
假設原文漏掉 Seed 指定的電話,去識別化版本當然也不會出現電話,實體清單更不會把它標出來;三份結果看起彼此完全一致,卻一起偏離了測試目的。更進一步說╴模型也可能在去識別化時順手改寫句意,再依改寫後的內容產生一份看似合理的標註;如果只看最後輸出,很難判斷問題出在原文生成、去識別化,還是標註。
所以今天先不增加 Prompt 細節,而是把一筆 PII 測試資料拆成幾個可追蹤的生成階段(Stage)。
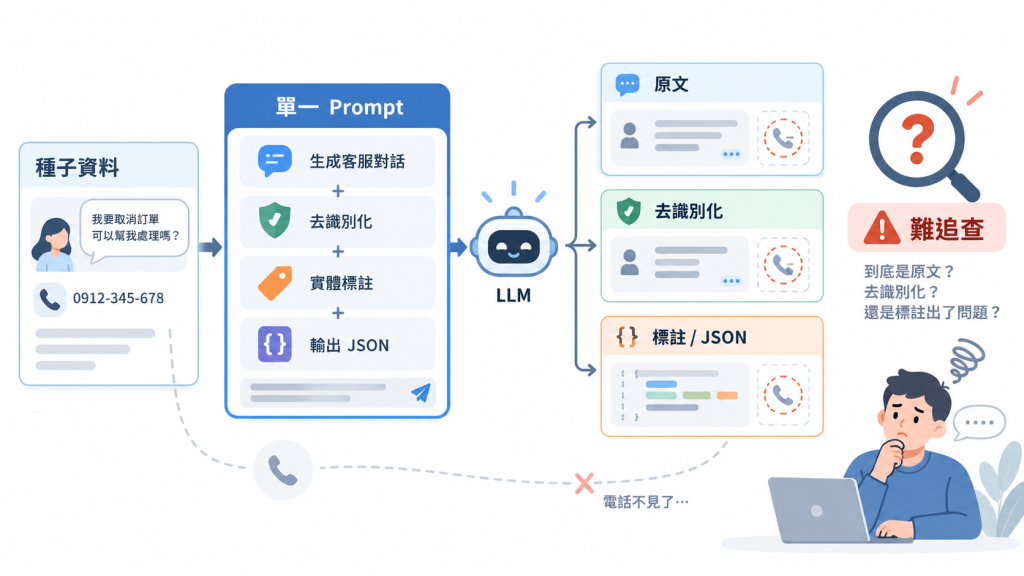
筆者認為生成資料這件事情很容易發生「差之毫釐,謬以千里」的問題(血和淚的教訓啊
NVIDIA NeMo Data Designer 的設計原則把合成資料生成視一個又一個的工程步驟與階段、而不是一個包辦所有工作的任務;每個階段只處理一項明確工作,留下對應的輸出作為檢查,在品質無虞後續才繼續進行下一步驟的工項。
筆者認為一個 Stage 至少要說清楚四件事:
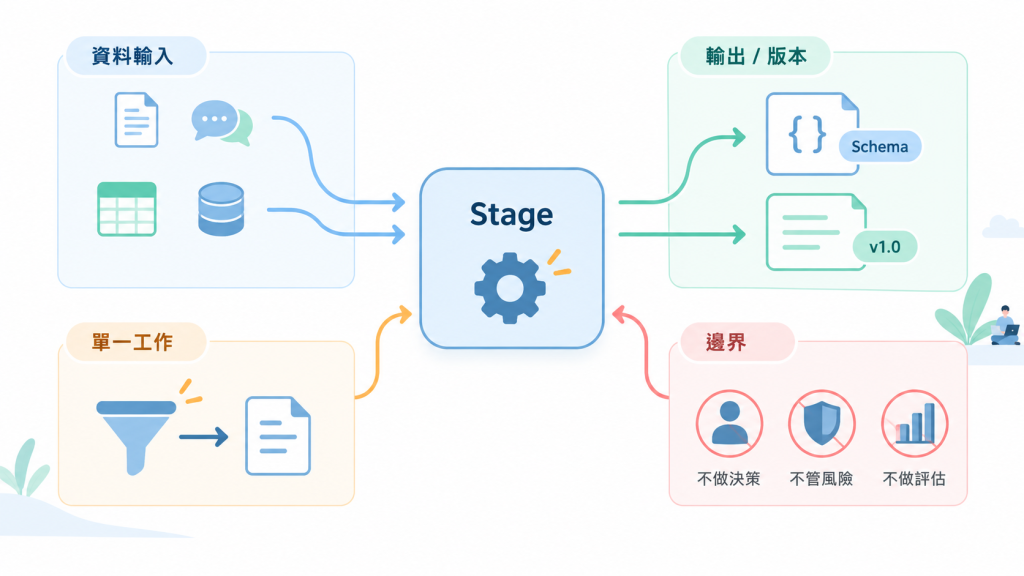
這個分法跟「呼叫幾次 LLM」不是同一件事;某個 Stage 可以使用 LLM,也可以只做確定性的字串轉換;同一次模型呼叫若同時生成原文、遮罩、標註又替自己評分,責任仍然混在一起。Stage 的重點是資料責任與可檢查的產物(Artifact),不是 LLM API 呼叫次 / 執行了多少次。
沿用前文的地址變更客服案例,Seed 已經固定任務、目的端、允許使用的虛構資料與預期處置。今天把資料生成拆成三個 Stage:含 PII 原文、去識別化版本,以及候選實體標註。
| Stage | 輸入 | 只負責什麼 | 主要輸出 | 不應順手做什麼 |
|---|---|---|---|---|
| 1. PII 原文生成 | Seed Contract、允許使用的虛構實體、表達變化條件 | 依任務生成一份含指定 PII 的原始客服內容 | source_text、實際使用的虛構值、生成設定版本 |
不要遮罩、不要替 Guardrail 下 BLOCK/ALLOW 判斷,也不要宣稱標註已完成 |
| 2. 遮罩/去識別化(Redaction) | 第一階段留下的原文、遮罩規則 | 移除或替換不應保留的敏感內容,同時保住原本任務語意 | redacted_text、使用的占位符(placeholder)/轉換方式、設定版本 |
不要重新生成另一段客服情境,也不要用改寫後文字取代原文的標註基準 |
| 3. 候選實體標註 | 原始 source_text、實體類型定義、Seed 中已知的虛構值 |
找出原文中的實體類型、文字與位置 | entity_candidates,包含 type、text、start/end 與來源依據 |
不要因為輸出格式正確,就直接把模型標註命名為最終 Ground Truth |
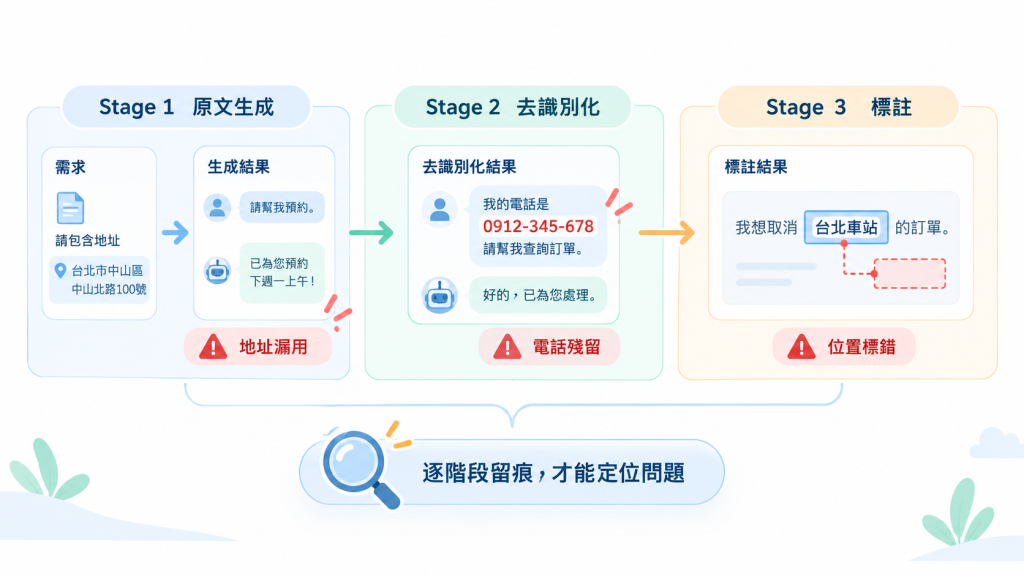
第一階段若漏用 Seed 指定的地址,問題就停在原文生成;
第二階段若仍留下完整電話,先回頭看去識別化;
第三階段若文字找對、位置卻標錯,就檢查標註規則與索引方式。
每個 Stage 都留下自己的資料,才有辦法把「結果不對」縮小成可處理的問題
| 觀察到的問題 | 先檢查哪個 Stage | 第一個要問的問題 |
|---|---|---|
| 原文沒有出現 Seed 指定的地址或電話 | PII 原文生成 | 第一階段是否收到正確 Seed,或把 must_use 當成可選條件? |
| 去識別化版本仍保留完整 PII | 去識別化 | Redaction 規則是否涵蓋該實體與格式? |
| 去識別化後已無法理解原本的客服任務 | 去識別化 | 第二階段是否把「移除敏感資訊」做成了「重寫或刪除整段內容」? |
| 實體文字正確,但 start/end 指到錯誤位置 | 候選實體標註 | 第三階段是否對原文標註,且使用同一套索引規格? |
| 原文、去識別化與標註各自合理,卻不是同一筆內容 | 無法只歸給單一 Stage | 三個 Stage 是否真的引用同一個 record_id 與上游輸出?這是 Dependency 要解決的問題。 |
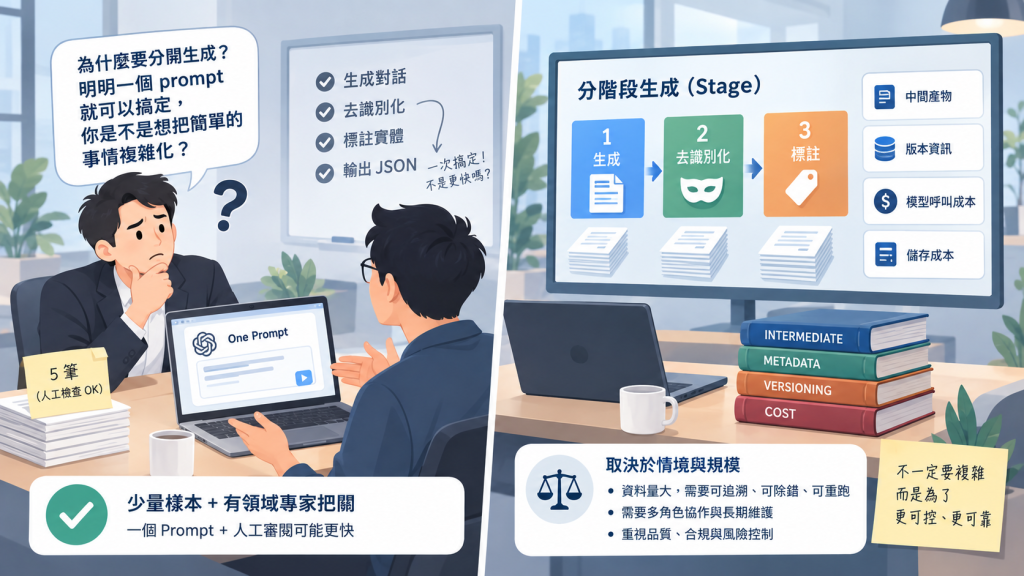
通常在說這個階段的內容時,客戶很常會提問的地方是:「為什麼要分開生成?明明一口氣隨便用一個 prompt 就可以生成的內容,為什麼要分成那麼多步驟、那麼複雜?你是不是想要把簡單的事情複雜化? 」
umm 對,任何事物在分階段規劃 / 執行時通常意味著更多中間產物 (intermediate、或是叫副產物)、更多版本資訊(Metadata),也可能增加模型呼叫與儲存成本中;在你要生成的資料只有五筆案例、而且你本身 / 或是有領域專家能逐筆檢查時,一個 Prompt 加人工審閱可能更快,分階段生成(Stage )的確不是要考量的事。
筆者用 Pre-Train Model 時常用的 Chinchilla-style 來粗略估算「從零開始 Pre-training 一個 LLM,大概要準備多少資料」;
Training Tokens ≈ 模型參數量 × 20

一個 1B 的 Model 要 20B Token 的資料、以 500 字資料約 600 tokens 為例子,

大概等於 3,333 萬筆

如果換成 SFT(Supervised Fine-Tuning、監督式微調)約要 10M tokens

大約是 1.7 萬筆
當資料要累積到數百筆、拿來做回歸比較,或需要說明某筆資料為何合格時,只保存最後一份 JSON 的代價會開始浮現:錯誤無法定位、修正會連帶重跑全部工作,舊輸出也很難和新版本比較。
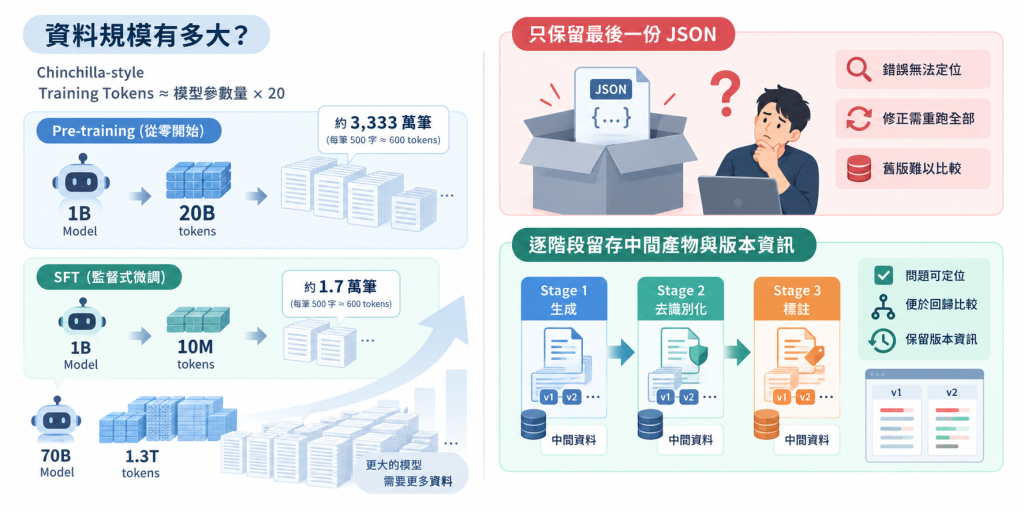
接下來真正棘手的問題是:如何保證 Redaction 與 Entity Candidate 都引用同一份 PII 原文,而不是三個 Stage 各自重新生成一份「看起來合理」的內容。Stage 先把工作拆開;Dependency 才會把這些工作接成同一條可重跑的資料路徑。


 iThome鐵人賽
 看影片追技術