
昨天建立了 dev Namespace,把 Todo App 的資源都部署進去,還設定了 ResourceQuota 限制資源用量。今天要學 HPA,讓 K8s 根據負載自動調整 Pod 數量!
Day 06 學過用 kubectl scale 手動調整副本數量:
kubectl scale deployment todo-api --replicas=4
這在流量可預測的情況下還能應付,但實際上流量很少是固定的:
靠人工盯著流量再手動 scale,反應速度太慢,也不現實。
HPA 解決這個問題:根據指標自動決定要跑幾個 Pod。
HPA(Horizontal Pod Autoscaler)監控指定的指標(CPU、Memory 或自訂指標),當指標超過設定的閾值,自動增加 Pod 數量;當指標降下來,自動減少 Pod 數量。
HPA 監控指標
    │
    ├── CPU 使用率 > 70%  →  增加 Pod
    │
    └── CPU 使用率 < 70%  →  減少 Pod(有冷卻時間)
HPA 調整的是 Deployment 的 replicas,Pod 數量在 minReplicas 和 maxReplicas 之間浮動。
HPA 每 15 秒(預設)從 metrics-server 拿一次指標,計算需要幾個 Pod:
期望副本數 = 目前副本數 × (目前指標值 / 目標指標值)
舉例:
縮容的時候有 冷卻時間(預設 5 分鐘),避免流量剛退就立刻縮容,一波流量回來又要重新擴容,造成頻繁震盪。
今天目標:確認 metrics-server 已啟用,建立 HPA 讓 todo-api 在 CPU 超過 50% 時自動擴容,用壓測觸發擴容並觀察 Pod 數量變化,停止壓測後確認自動縮容回最小值。
請先確認目前預設 Namespace 是 dev:
kubectl config view --minify | grep namespace
應該看到 namespace: dev,如果不是,先切換過來:
kubectl config set-context --current --namespace=dev
HPA 需要 metrics-server 提供指標:
minikube addons enable metrics-server

# 確認 metrics-server 跑起來
kubectl get pods -n kube-system | grep metrics-server
HPA 計算 CPU 使用率的時候,是用「目前使用量 / Request」來計算百分比。沒有設定 Request,HPA 無法計算使用率。
Day 16 已經幫 todo-api 設定了 requests.cpu: "100m",這裡可以直接繼續。
方式一:用 kubectl 指令
kubectl autoscale deployment todo-api \
  --cpu-percent=50 \
  --min=2 \
  --max=6
方式二:用 YAML
建立 todo-api-hpa.yaml:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: todo-api-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: todo-api
  minReplicas: 2             # 最少維持 2 個 Pod
  maxReplicas: 6             # 最多擴充到 6 個 Pod
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 50   # CPU 平均使用率目標 50%
kubectl apply -f todo-api-hpa.yaml
確認 HPA 狀態:
kubectl get hpa

TARGETS 顯示目前 CPU 使用率是 2%,目標是 50%,目前維持在最小值 2 個 Pod。
kubectl get hpa -w
kubectl run 跑壓測:kubectl run -it load-generator --rm --image=busybox --restart=Never \
--requests='cpu=100m,memory=64Mi' \
--limits='cpu=200m,memory=128Mi' \
-- /bin/sh -c "while true; do wget -q -O- http://todo-api-service/todos; done"
因為 dev Namespace 設有 ResourceQuota,跑任何 Pod 都必須指定 resource requests 和 limits,否則會被拒絕。
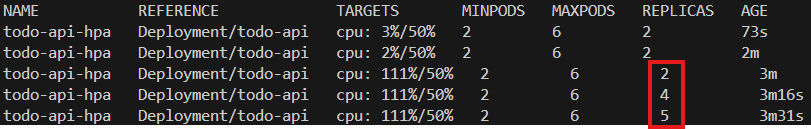
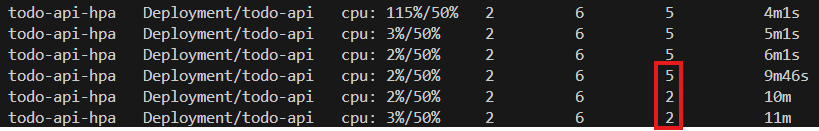
HPA 是水平擴縮容(增加 Pod 數量),K8s 生態系還有另外兩個自動擴縮容工具:
VPA(Vertical Pod Autoscaler)
VPA 是垂直擴縮容,自動調整單個 Pod 的 CPU 和 Memory Request/Limit,而不是增加 Pod 數量。
適合用在無法水平擴展的服務(例如單節點的資料庫),或者用來推薦合理的 Resource 設定值。
VPA 和 HPA 不建議同時用在同一個 Deployment 的 CPU/Memory 指標上,可能會衝突。
KEDA(Kubernetes Event-driven Autoscaling)
KEDA 是事件驅動的自動擴縮容,根據外部指標(訊息佇列的長度、HTTP 請求數、資料庫的查詢數)來決定 Pod 數量。
例如:Kafka topic 有 1000 則訊息待處理 → 擴容到 10 個 consumer Pod;訊息清空 → 縮容到 0 個 Pod(KEDA 可以縮容到 0,HPA 不行)。
適合背景任務、批次處理、訊息消費等工作負載。
今天學了 HPA:
明天會學 RBAC,設定不同角色的存取權限,讓叢集的操作有更嚴格的控管 !


 iThome鐵人賽
 看影片追技術