

Day 7,我替 AI Reliability Lab 加入了 calibration evaluator。
當時已經可以計算 Brier Score、ECE 等指標,也可以把模型給出的 confidence 和實際 correctness 放在一起分析。
但做到這裡其實有一個很明顯的問題:
我手上還沒有真正由 LLM 產生的 confidence data。
前一天使用的資料,本質上仍然是 Synthetic Data。
也就是說,我已經做好了一把尺,知道之後要怎麼衡量模型的 confidence 是否可信,但還沒有真的拿這把尺去量模型。
所以 Day 8 我決定先不急著繼續增加 evaluation metric。
今天只做一件事情:
建立第一套可以真正呼叫 LLM、收集 confidence、保存結果,而且未來能重複執行的 REAL Experiment pipeline。
這也是 AI Reliability Lab 第一次正式從 Synthetic Experiment 跨進 Real Experiment。
如果我要研究 LLM 的 confidence,第一個問題其實不是 ECE 怎麼算。
而是:
「confidence」本身到底要怎麼取得?
最直覺的方法,就是直接問模型。
例如我可以要求模型除了回答問題之外,也輸出:
final_answer
self_reported_confidence
假設模型回答:
Answer: Tokyo
Confidence: 1.0
這代表模型「自認」自己有 100% 的把握。
我把這個值稱為:
self_reported_confidence
但這裡馬上又會出現另一個問題。
模型自己說「我有 100% 把握」,真的代表它有 100% 把握嗎?
還是它只是很會講得很有自信?
因此今天我不想只收集 self-reported confidence。
我另外加入第二種 uncertainty signal:
agreement_confidence
概念很簡單。
同一個問題,不只問模型一次,而是讓它獨立回答多次。
假設同一題得到:
Tokyo
Tokyo
Tokyo
Tokyo
Tokyo
五次回答全部相同。
那代表模型在不同 sampling 下非常一致。
另一題如果得到:
A
B
A
A
B
就代表模型在這題的回答比較不穩定。
所以我定義:
agreement_confidence
=
最常出現答案的次數 / 總 sampling 次數
例如:
A
A
A
B
A
A 出現四次,因此:
agreement_confidence = 4 / 5 = 0.8
這裡有一件事情一定要先講清楚:
agreement confidence 目前只是一種 signal,不是經過 calibration 的 probability。
agreement = 0.8
不代表:
這個答案有 80% 機率是正確的。
它目前只代表:
在這一組 sampling 中,有 80% 的回答落在同一個答案上。
至於它能不能用來預測 correctness,就是後面真正要驗證的問題。
如果我今天只是呼叫 OpenAI API,然後把答案印在 terminal 上,其實沒有太大的研究價值。
因為後面很難再追蹤:
所以 Day 8 的其中一個重點,是先把 experiment record 定義清楚。
目前每一題最後會整理成類似:
{
  "case_id": "R001",
  "question": "2 + 3",
  "gold_answer": "5",
  "primary_answer": "5",
  "is_correct": true,
  "self_reported_confidence": 1.0,
  "sample_answers": ["5", "5", "5"],
  "agreement_confidence": 1.0,
  "model": "gpt-5.6-luna",
  "prompt_version": "day08-v1",
  "data_classification": "real_public_experiment"
}
其中幾個欄位我刻意分開保存。
gold_answer
代表事先已知的標準答案。
primary_answer
代表模型主要回答的答案。
is_correct
則是 primary answer 和 gold answer 比較後得到的結果。
另外再保存:
self_reported_confidence
sample_answers
agreement_confidence
這樣後面才能真正分析:
模型自認越有把握時,是不是越容易答對?
以及:
模型多次回答越一致時,是不是越容易答對?
這兩個問題看起來很像,但其實是兩種完全不同的 confidence source。
今天 primary response 不再讓模型自由輸出一大段文字。
而是要求它回傳結構化結果。
例如:
final_answer
self_reported_confidence
這件事情看起來只是方便 parsing,但對後面的 reliability experiment 非常重要。
如果我只是要求模型:
回答問題,順便告訴我你多有把握。
可能第一次得到:
I think the answer is Tokyo.
I'm about 95% confident.
第二次卻變成:
Answer: Tokyo
Confidence level: Very High
第三次甚至可能只有:
Tokyo
如果資料格式本身就不穩定,後面的 evaluator 就會把大量時間花在清理輸出格式,而不是分析模型 reliability。
因此這次 primary response 直接要求 machine-readable structured output。
模型必須明確提供:
final_answer
self_reported_confidence
而 confidence 也會驗證必須位於:
0.0 ~ 1.0
超出範圍就不能直接當成有效 experiment record。
今天原本 Day 8 的 infrastructure 已經有基本架構,包括:
CLI
Experiment configuration
Evaluation questions
Responses API adapter
Structured primary answer
Independent sampling
Agreement calculation
Gold-answer correctness
Public output schema
Mocked tests
但真正要開始跑 Real Experiment 前,我又補了一輪 safety 和 reproducibility。
其中一個我很在意的設定是:
retries = 0
一般正式產品如果 API request 暫時失敗,自動 retry 通常是合理的。
但是在實驗環境裡,retry 可能會讓實驗紀錄變得不透明。
例如我最後看到:
8 successful responses
但底層實際可能打了:
12 API requests
如果沒有另外記錄,就很難知道真正發生了什麼。
所以今天加入 request counter,而且明確關閉自動 retry。
另外也限制:
max_output_tokens = 256
timeout = 60 seconds
store = False
今天的題目只需要短答案,所以沒有理由讓模型產生大量 output。
這些看起來都是很小的工程設定,但它們會直接影響實驗之後是否能夠被解釋和重現。
另一個今天特別處理的問題,是 Mock 和 Real Experiment 的隔離。
Unit Test 當然不能每一次都真的打 OpenAI API。
否則:
pytest
每跑一次都要花 API 額度,而且測試結果還會受到模型本身的不確定性影響。
所以 mocked responses 一定要保留。
但是 mocked data 絕對不能和 Real Experiment output 混在一起。
目前真實實驗產生、而且可以公開的衍生資料會放在:
data/real/public/
如果未來真的需要保存 provider raw response,則會放在:
data/real/raw/
而:
data/real/raw/
維持 Git ignored。
今天的 smoke experiment 並沒有保存 raw provider response。
另外也補上 secret checking,避免 API key 或已知敏感內容意外流進 public output。
這件事情對我來說很重要。
因為「能跑」和「適合放進公開 GitHub repo」其實是兩個不同問題。
在真正打 API 之前,我先把整套測試跑完。
原本:
57 passed
補上 Day 8 的 regression tests 之後變成:
68 passed
這次額外補的測試包含:
confidence range validation
answer normalization
agreement calculation
unanimous samples
split samples
gold answer correctness
malformed response handling
missing API key behavior
secret protection
request counting
incomplete response rejection
也就是說,在真的花 API request 之前,我先盡量把可以用 Mock 驗證的部分全部驗證一次。
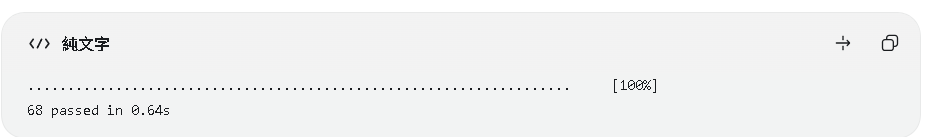
Infrastructure 和 tests 都確認沒問題之後,今天終於實際開始跑第一批 Real Experiment。
但第一次我沒有直接跑完整 benchmark。
而是刻意只跑兩題。
設定如下:
API: OpenAI Responses API
Model: gpt-5.6-luna
Prompt version: day08-v1

Questions:
R001
R002

Primary requests per question:
1

Independent samples per question:
3

max_output_tokens:
256

reasoning:
none

timeout:
60 seconds

retries:
0

store:
False
因此每一題實際需要:
1 primary request
+
3 independent sample requests
=
4 API requests
兩題總共:
8 API requests
實際結果:
8 / 8 succeeded
沒有發生 retry。
最後成功產生兩筆完整的 Real Experiment record。
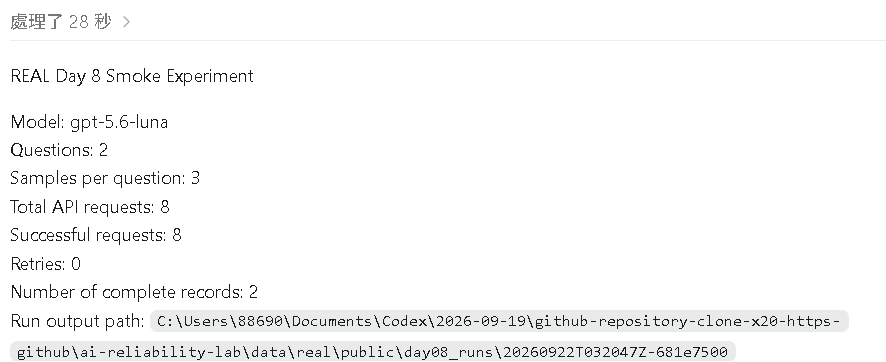
第一題是:
Question:
2 + 3

Gold Answer:
5

Primary Answer:
5

Self-reported Confidence:
1.0

Sample Answers:
5
5
5

Agreement Confidence:
1.0

Correct:
Yes
第二題:
Question:
Capital of Japan

Gold Answer:
Tokyo

Primary Answer:
Tokyo

Self-reported Confidence:
1.0

Sample Answers:
Tokyo
Tokyo
Tokyo

Agreement Confidence:
1.0

Correct:
Yes
整理如下:
| Question | Gold | Primary | Self Confidence | Samples | Agreement | Correct |
|---|---|---|---|---|---|---|
| 2 + 3 | 5 | 5 | 1.0 | 5 / 5 / 5 | 1.0 | Yes |
| Capital of Japan | Tokyo | Tokyo | 1.0 | Tokyo / Tokyo / Tokyo | 1.0 | Yes |
Real records 最後被寫入:
data/real/public/day08_runs/
裡面包含:
records.jsonl
metadata.json
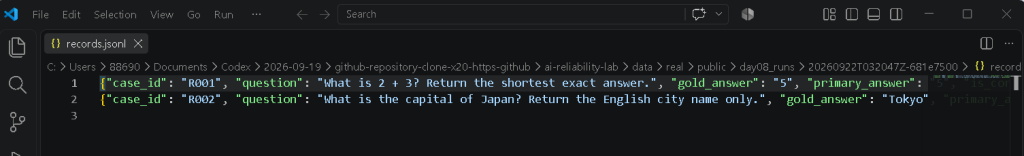
今天得到:
Self-reported confidence = 1.0
Agreement confidence = 1.0
Accuracy = 100%
乍看之下好像模型的 confidence 非常可靠。
但這裡反而是整篇最不能亂下結論的地方。
因為今天只有兩題。
而且是:
2 + 3
以及:
Capital of Japan
這兩題都是非常簡單的問題。
今天設計這兩題的目的,本來就不是測模型的 calibration。
它們只是 smoke test。
也就是我要確認下面整條 pipeline 能不能成功跑完:
Question
    ↓
Responses API
    ↓
Structured Primary Response
    ↓
Independent Sampling
    ↓
Answer Normalization
    ↓
Agreement Calculation
    ↓
Gold Answer Comparison
    ↓
Real Experiment Record
    ↓
Persist to Disk
今天的答案是:
可以。
但是這並不代表:
模型的 self-reported confidence 已經證明可靠。
也不能代表:
agreement confidence 已經證明是一個 calibrated probability。
甚至目前兩筆資料根本不足以計算有意義的 calibration。
如果下一批 benchmark 還全部都是這種非常簡單的題目,很可能所有資料最後都長成:
confidence ≈ 1.0
agreement ≈ 1.0
correct = True
那其實也很難看出模型的 uncertainty 到底有沒有資訊量。
所以 Day 8 真正的成果並不是:
模型答對兩題。
而是:
AI Reliability Lab 第一次建立了一條可以產生真實 LLM reliability data 的實驗管線。
Day 7 比較像:
Synthetic Confidence Data
        ↓
Calibration Evaluator
到了今天則變成:
REAL LLM
   ↓
Primary Answer
   ↓
Self-reported Confidence
   ↓
Independent Sampling
   ↓
Agreement Confidence
   ↓
Correctness
   ↓
Structured Real Record
   ↓
Calibration Evaluator
這個差異對整個專案很重要。
因為從下一步開始,我終於可以停止問:
我的 evaluator 能不能算?
而開始問真正的 reliability 問題:
模型產生的 uncertainty signal,到底能不能預測它自己會不會答錯?
Day 9 開始,題目設計本身就會變成實驗的一部分。
下一批 benchmark 不能全部都是模型幾乎必答對的問題。
我需要逐步加入不同難度與不同 failure mode。
例如:
簡單 factual questions

容易混淆的 factual questions

multi-step reasoning

數值計算

資訊不足問題

容易誘導模型過度自信的問題
因為只有當資料裡同時開始出現:
correct
incorrect
high confidence
low confidence
high agreement
low agreement
Day 7 做好的 calibration evaluator 才真正有東西可以量。
而到了那一步,就可以正式比較:
self-reported confidence
vs.
agreement confidence
到底哪一個跟 correctness 的關係比較強。
或者最後可能發現:
兩個都沒有想像中可靠。
那也一樣是結果。
AI Reliability Lab 的目標不是證明某個方法一定有效,而是建立一套能讓這些假設真正被測量、被重現、甚至被否證的實驗流程。
Day 8 做到的,就是讓這條流程第一次真正跑起來。
今天完成:
Real LLM experiment pipeline

Structured primary response

Self-reported confidence

Independent answer sampling

Agreement confidence

Gold-answer correctness

Real / Mock data separation

Request counting

Retries disabled

Secret protection

68 automated tests

2-question REAL smoke experiment

8/8 API requests succeeded

2 REAL experiment records saved
但是目前仍然沒有做:
正式 benchmark

大規模 Real Experiment

Calibration comparison

Self-report vs Agreement 結論
這些我刻意留到下一步。
今天先證明:
Real Experiment pipeline 是真的可以跑的。
Day 9 再開始真正讓模型犯錯。


 iThome鐵人賽
 看影片追技術