

Day 19 跑完 48 題 REAL benchmark 後,有一個結果非常明顯:6 個錯誤全部出現在 multi_step_reasoning,另外三個 strata 都是 12/12。
看到這個結果後,最直覺的下一步就是問:「模型到底錯在哪一步?」
但這個問題其實很危險。
因為我手上的 REAL artifacts 只有模型最後輸出的答案,以及七次 independent samples 的答案。我沒有模型真正的內部 reasoning trace,更沒有可信的 chain-of-thought。如果現在直接看著錯誤答案說「它忘了最後一步」「它算到一半停下來」,其實都只是事後猜故事。
所以 Day 20 我沒有再跑新的 API,而是換一個比較保守的方法:把 12 題 multi-step cases 的正確執行流程用 deterministic Python trace 重建出來,再看模型最後輸出的答案,有沒有剛好對應到某個合法的中間狀態。
這次分析版本是:
day20-multistep-trace-analysis-v1
來源仍然是 Day 19 的 REAL run:
20261002T134556Z-6819e3e5
今天 API、provider、network calls 全部都是:
0 / 0 / 0
這次不是只分析 Day 19 那六題錯誤,而是把全部 12 題 multi_step_reasoning 都放進來。
原因很簡單。如果我只看錯的六題,再依照它們的樣子設計分類,很容易變成事後量身打造。把六題正確 case 一起放進來,至少可以看看相同的方法在 correct cases 上長什麼樣子。
每一題都建立 deterministic reference trace,例如初始狀態、每一步操作後的狀態,到最後的 Gold Answer。
最後:
12 / 12 reference traces PASS
也就是每條 trace 的 final state 都和 frozen gold answer 一致。
Day 19 canonical verifier 也再次確認:
22 / 22 PASS
73 個 protected source files 全部維持 unchanged,所以今天只是在舊 REAL evidence 上做 derived analysis,沒有改任何原始紀錄。
模型的 final answer 和 deterministic trace 比對後,我用了四種非常保守的分類:
FINAL_CORRECT:答案就是最後的 Gold。INTERMEDIATE_STATE_MATCH:答案剛好等於某個 deterministic intermediate state。ONE_STEP_NEIGHBOR:可以從合法 trace state 再做一次合法操作得到。INVALID_OR_UNEXPLAINED:以上都對不上。後面簡寫成:
F / I / N / U
這裡最重要的是,I 不能直接解讀成「模型做到這一步就停了」。
我只能說:
模型最後輸出的答案,剛好和 reference trace 的某個 intermediate state 相同。
它內部到底怎麼算的,我不知道。
全部 12 題結果如下:
| Case | Primary | Seven Samples F/I/N/U |
|---|---|---|
| D14-007 | F | 7/0/0/0 |
| D14-008 | F | 7/0/0/0 |
| D14-009 | U | 2/0/0/5 |
| D14-010 | F | 7/0/0/0 |
| D14-011 | I | 3/4/0/0 |
| D14-012 | F | 7/0/0/0 |
| D18-007 | F | 1/0/0/6 |
| D18-008 | U | 0/0/0/7 |
| D18-009 | U | 3/0/0/4 |
| D18-010 | F | 7/0/0/0 |
| D18-011 | I | 6/1/0/0 |
| D18-012 | U | 0/0/0/7 |
這張表其實已經看得出來,六個錯誤不是同一種。
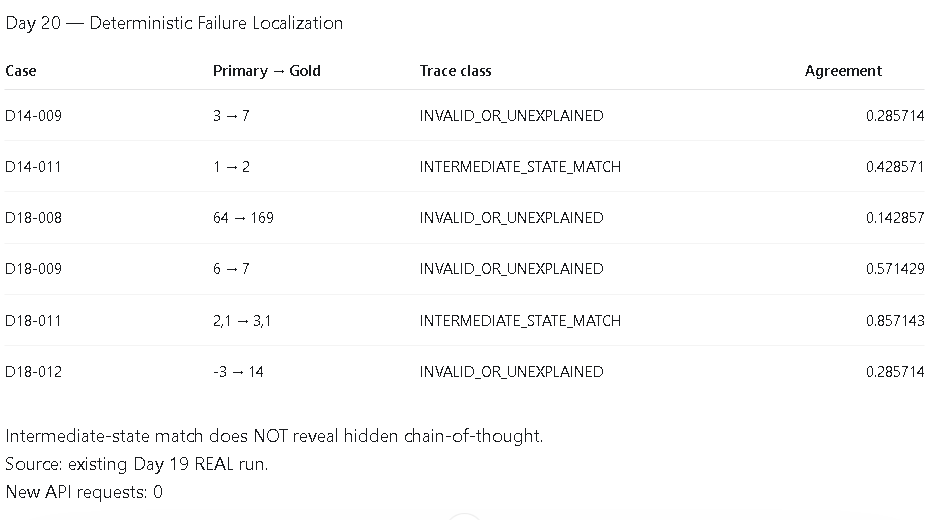 把六個 incorrect primary 拿出來:
| Case | Primary → Gold | Trace Class | Agreement |
|---|---|---|---|
| D14-009 | 3 → 7 | U | 0.285714 |
| D14-011 | 1 → 2 | I | 0.428571 |
| D18-008 | 64 → 169 | U | 0.142857 |
| D18-009 | 6 → 7 | U | 0.571429 |
| D18-011 | 2,1 → 3,1 |
I | 0.857143 |
| D18-012 | -3 → 14 | U | 0.285714 |
六題裡只有:
D14-011
和
D18-011
屬於 INTERMEDIATE_STATE_MATCH。
另外四題全部是:
INVALID_OR_UNEXPLAINED
也就是它們的錯誤答案沒有對應到目前 deterministic trace 裡任何事先定義的合法 intermediate state。
這個結果跟我一開始想像的不太一樣。我原本其實有點期待看到很多「差最後一步」的 pattern,但資料沒有支持這件事。
目前只能說,六個錯誤裡有兩題的 final output 剛好等於 reference intermediate state,另外四題用這套 deterministic trace 無法解釋。
D18-011 是 Day 19 很特別的一題。
Gold Answer:
3,1
Primary:
2,1
七個 samples 裡:
3,1 出現 6 次2,1 出現 1 次所以它的 Agreement 高達:
0.857143
也因為高於昨天 freeze 的 0.8 threshold,它成為唯一一個沒有被 agreement < 0.8 flag 抓到的錯誤。
今天把 deterministic trace 展開後,發現:
2,1
剛好就是 reference trace 的 step 4。
那個狀態是在完成 south 2 之後的位置;下一步再做最後一次 east 1,才會到真正答案:
3,1
所以我現在可以很精確地寫:
Primary output
2,1與 deterministic reference trace 的 step 4 state 完全一致。
但我還是不能寫:
模型做到 step 4 後忘了做最後一步。
因為後一句已經是在推測模型內部 reasoning。
這兩句看起來很像,但科學上差很多。
另一題 INTERMEDIATE_STATE_MATCH 是 D14-011。
Primary:
1
Gold:
2
這個 1 在 deterministic trace 中會出現在 step 2 和 step 5。
七個 samples 的 trace classes 是:
3 F / 4 I / 0 N / 0 U
也就是這一題不只是 primary 撞到 intermediate state,samples 裡也有四個答案屬於 intermediate match。
這跟 D18-011 有點不同。
D18-011 的七個 samples 是:
6 F / 1 I
大多數 sampling 其實都到了 final gold。
而 D14-011 的 samples 則在 final 和 intermediate state 之間分得比較開。
所以即使兩題都被標成 I,sampling pattern 還是不一樣。
最極端的是 D18-008。
它的 Gold 是:
169
Primary 是:
64
七個 samples:
64, 144, 256, 729, 361, 81, 324
Agreement:
0.142857
Normalized entropy:
1.0
七個 sample 全部都是不同答案,而且:
0 F / 0 I / 0 N / 7 U
也就是七個 samples 沒有一個等於 Gold,也沒有一個符合 deterministic intermediate state 或 one-step neighbor。
這種 case 就不能硬套「模型只少做一步」的故事。
目前最誠實的分類就是:
INVALID_OR_UNEXPLAINED
這個名稱故意留得很保守,因為「對不上目前 trace」不代表數學上絕對不可能有其他 derivation,只代表在我們明確定義、可驗證的 reference states 裡找不到它。
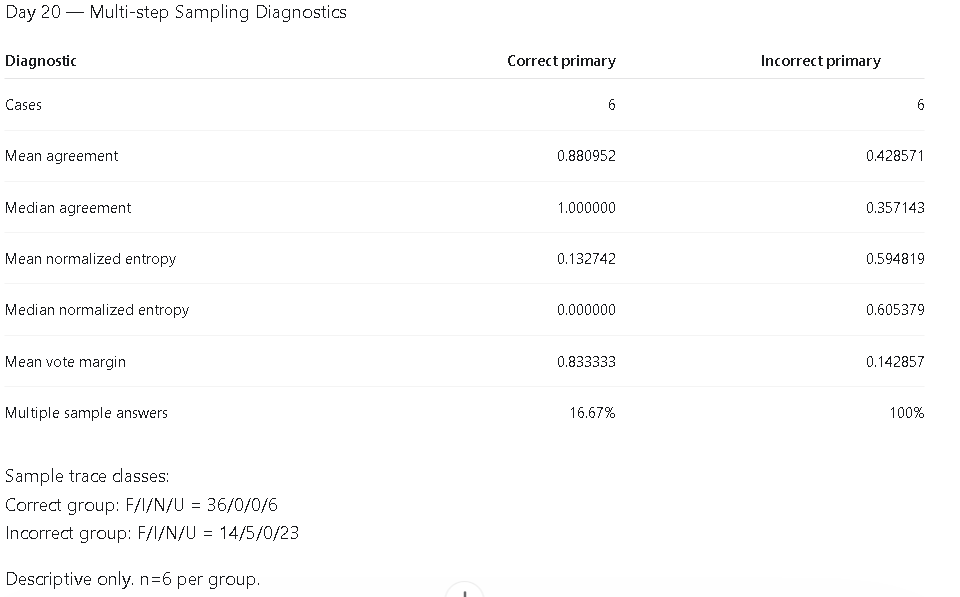 因為這次有把全部 12 題一起分析,所以可以把六個 primary correct 和六個 primary incorrect 做一個 descriptive comparison。
每組只有六題,所以不做 significance test,只看這批資料裡的差異。
| Diagnostic | Correct | Incorrect |
|---|---|---|
| Mean Agreement | 0.880952 | 0.428571 |
| Median Agreement | 1.000000 | 0.357143 |
| Mean Normalized Entropy | 0.132742 | 0.594819 |
| Median Normalized Entropy | 0.000000 | 0.605379 |
| Mean Vote Margin | 0.833333 | 0.142857 |
| Median Vote Margin | 1.000000 | 0.000000 |
| >1 distinct sample answer | 16.67% | 100% |
這次六個 incorrect primary cases,每一題的七個 samples 都出現超過一種答案。
反過來,六個 correct primary cases 裡只有一題有 multiple distinct answers。
Sample trace classes 也差很多。
Correct primary group 的 42 個 samples:
36 F / 0 I / 0 N / 6 U
Incorrect primary group:
14 F / 5 I / 0 N / 23 U
所以在這 12 題裡,錯誤 group 的 sampling 不只 Agreement 比較低,entropy 比較高,也出現更多無法用 reference trace 解釋的 final outputs。
不過樣本真的很小,六題對六題目前只能當 descriptive pattern。
Day 19 看到 primary 有時會選到少數答案後,我也很自然想到一個方法:
既然每題已經有七個 samples,那乾脆不要相信 primary,直接拿 sample modal answer 當 final answer?
Day 20 可以離線算這件事,因為七個 samples 都已經是真實跑過的 REAL outputs,不需要再送 API。
但這只能叫:
OFFLINE COUNTERFACTUAL ON EXISTING REAL SAMPLES
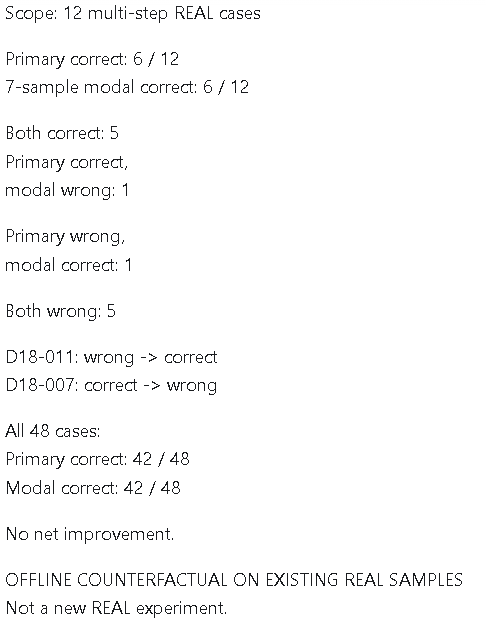 結果其實很有意思。
12 個 multi-step cases:
| Result | Count |
|---|---|
| Primary correct | 6 |
| Modal answer correct | 6 |
| Both correct | 5 |
| Primary correct → Modal wrong | 1 |
| Primary wrong → Modal correct | 1 |
| Both wrong | 5 |
Modal answer 確實救回 D18-011。
可是同時,它把原本 primary 正確的 D18-007 變成錯誤。
所以最後:
Primary correct:
6/12
Modal correct:
6/12
完全沒有淨增加。
如果擴到全部 48 cases 也一樣。
Primary:
42/48
Modal:
42/48
其中一題從 wrong 變 correct,但另一題從 correct 變 wrong。
這個結果我反而很喜歡,因為它擋住了一個非常容易出現的錯誤結論:
「既然 sampling 有資訊,那 majority vote 一定比 primary 好。」
至少在這批 REAL data 裡,沒有。
D18-007 的 primary 是正確的,所以 primary class 是:
F
可是七個 samples 的 trace distribution 是:
1 F / 0 I / 0 N / 6 U
也就是 primary 答對,但 samples 反而非常不穩。
因此直接用 sample modal answer 取代 primary,這題就會被改錯。
這也再次說明 sampling information 比較適合被當成額外的可靠性訊號,而不是直接假設它一定能取代 primary response。
到底要怎麼把 primary、agreement、entropy、trace validation 合在一起,現在還沒有答案。
一開始看到六個 errors 全部集中在 multi-step reasoning,我很容易想把它們歸成某個共同問題。
但今天真的把 trace 做完後,結果反而比較複雜。
六個錯誤裡:
ONE_STEP_NEIGHBOR
所以現在還沒有證據支持一個統一的 causal explanation。
但這並不是失敗。
反而讓下一步更清楚:Reliability system 不能只看「答案對不對」或一個 confidence number。如果某些 task 本身可以建立 deterministic execution trace,那麼 final answer 能不能通過 trace-aware verifier,可能是一條值得繼續做的方向。
至少今天已經先證明一件事:
不要因為錯誤答案剛好像中間結果,就直接把它寫成模型的思考過程。
我們真正知道的只有 final output。
剩下的,都必須靠可以重現、可以驗證的 evidence 慢慢往前推。
Day 20 最後:
今天沒有產生新的 REAL model evidence。
只有把 Day 19 已經存在的 evidence,拆得更細了一點。


 iThome鐵人賽
 看影片追技術