

Day 19 的 48 題 REAL benchmark 裡,模型答對 42 題、答錯 6 題,而且 self-reported confidence 48 題全部都是 1.0。反過來,七次 sampling 得到的 Agreement、entropy、vote margin 至少會隨 case 改變。Day 20 又往下拆了 multi-step errors,發現有些錯誤剛好對應 deterministic intermediate state,有些則完全對不上 reference trace。
但做到這裡有一個問題:
知道模型可能不可靠之後,系統到底要做什麼?
如果最後還是每一題都直接把 primary answer 丟給使用者,那前面算了一大堆 confidence、agreement、entropy,其實都只是報表。
所以 Day 21 我開始做第一個真的會「決策」的 reliability component:
Selective Answer Gate
它不負責改答案,也不會自己猜一個比較好的答案。
它只做一件事:
ACCEPT
或
REVIEW
也就是當 sampling signal 看起來穩定時,讓 primary answer 繼續往下走;如果 signal 達到某些條件,就把這題攔下來,交給後續人工檢查或其他 verifier。
Day 21 完全沒有重新呼叫模型。
今天使用的是 Day 19 已經存在的 48 筆 REAL records,所以:
分析版本是:
day21-selective-gate-development-v1
而且所有產出都標成:
post_hoc_development_from_real
這個標籤很重要,因為 Day 19 的正確和錯誤結果我已經看過了。
今天雖然有比較 threshold、有選 candidate policy,但這些結果全部都只是 development-set performance,不是獨立 validation。
如果我今天調出一條規則,在這 48 題上表現超漂亮,再直接說「這個 gate 有效」,其實就是 data leakage。
所以 Day 21 的目標不是證明一條 production policy,而是:
先把 gate 的架構、metrics、候選規則和未來 validation 流程做出來。
真正驗證留給之後沒看過的新資料。
這次我最在意的一個工程限制,就是 gate 在做決策時不能知道 correctness。
它收到的是一個 CaseSignals,裡面只允許放模型輸出後真的能取得的 reliability signals,例如:
Self-reported confidence 介面上也可以存在,但 Day 19 裡 48 題全部都是 1.0,所以實際上沒有辨識力。
Gate 不可以看到:
尤其 Day 20 那些 INTERMEDIATE_STATE_MATCH、INVALID_OR_UNEXPLAINED 雖然很有用,但它們需要 Gold/reference information 才算得出來,因此不能偷偷塞進一個號稱可以在線使用的 general gate。
Gate 先根據 signals 決定 ACCEPT/REVIEW,之後 evaluation code 才拿 correctness 來評分。
這個順序不能反。
第一條 policy 是:
P0_ACCEPT_ALL
完全不做 reliability gate,每一題都接受。
它就是我們的 baseline。
48 題全部 ACCEPT,所以:
| Metric | Result |
|---|---|
| Coverage | 100% |
| Review rate | 0% |
| Accepted accuracy | 87.50% |
| Selective risk | 12.50% |
| Error capture | 0% |
| Escaped errors | 6 |
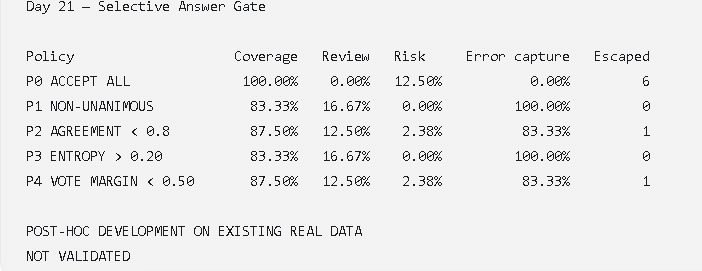 這裡的 selective risk 可以很直覺地理解成:
被我放行的答案裡,有多少比例其實是錯的?
Accept all 當然就是原本的 6/48:
12.5%
接下來每一條 gate policy,本質上都在做同一個 trade-off:
我願意犧牲多少 coverage,換取比較低的 accepted risk?
我先做六條簡單、看得懂的 policy。
| Policy | Rule |
|---|---|
| P0 | 全部 ACCEPT |
| P1 | Agreement < 1.0 → REVIEW |
| P2 | Agreement < 0.8 → REVIEW |
| P3 | Entropy > 0.20 → REVIEW |
| P4 | Vote margin < 0.50 → REVIEW |
| P5 | Agreement < 0.8 OR Entropy > 0.20 |
| P6 | Agreement < 0.8 OR Vote margin < 0.50 |
結果如下:
| Policy | Coverage | Review | Selective Risk | Error Capture | Review Precision | Escaped |
|---|---|---|---|---|---|---|
| P0 Accept all | 100% | 0% | 12.50% | 0% | N/A | 6 |
| P1 Non-unanimous | 83.33% | 16.67% | 0% | 100% | 75% | 0 |
| P2 Agreement < 0.8 | 87.50% | 12.50% | 2.38% | 83.33% | 83.33% | 1 |
| P3 Entropy > 0.20 | 83.33% | 16.67% | 0% | 100% | 75% | 0 |
| P4 Margin < 0.50 | 87.50% | 12.50% | 2.38% | 83.33% | 83.33% | 1 |
| P5 Agreement OR Entropy | 83.33% | 16.67% | 0% | 100% | 75% | 0 |
| P6 Agreement OR Margin | 87.50% | 12.50% | 2.38% | 83.33% | 83.33% | 1 |
這張表其實就已經把核心問題講完了。
如果我選 P1 或 P3,這批資料裡確實可以做到:
0 個 observed escaped errors
但是代價是要 review:
8 / 48 題
Coverage 剩:
83.33%
P2 比較寬鬆,只 review:
6 / 48 題
Coverage 提高到:
87.50%
但會放走一個錯誤。
所以 reliability gate 根本不是「找到一個準確率最高的 threshold」這麼簡單,而是在決定:
我們願意付多少 review workload,來換多少風險下降?
P2 的結果可以再拆細一點。
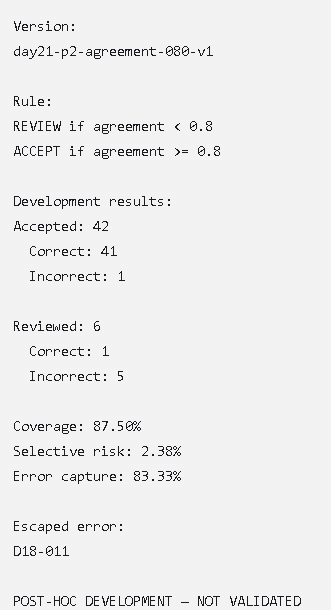
規則:
agreement < 0.8 → REVIEW
否則:
ACCEPT
最後:
42 個被接受的答案裡:
所以 accepted accuracy 是:
41 / 42 = 97.62%
Selective risk:
1 / 42 = 2.38%
而被 review 的六題裡:
所以 review precision:
5 / 6 = 83.33%
跟完全不做 gate 的 12.5% risk 比起來,development set 上確實下降很多。
但那個剩下的 1 題非常重要。
它就是:
D18-011
Day 19 的 D18-011:
Gold:
3,1
Primary:
2,1
七個 samples:
3,1 × 62,1 × 1Agreement:
6/7 = 0.857143
所以 P2 的 threshold 是 0.8 時,它會被判定:
ACCEPT
但 primary 恰好是錯的。
Day 20 已經看到,Primary 2,1 剛好等於 deterministic trace 的 step 4,而真正 final state 是 3,1。
今天 gate 不能使用這個 trace information,所以它就是一個很乾淨的 escaped error。
這反而是我覺得 Day 21 最值得留下來的地方。
如果結果剛好變成「一條簡單 threshold 抓到 6/6」,很容易讓我誤以為問題已經解掉了。
D18-011 很直接地提醒:
Sampling Agreement 可以當 risk signal,但不能當 correctness oracle。
為了避免只挑一個看起來漂亮的 threshold,我另外事先列了一個小 grid。
Agreement:
0.50 / 0.60 / 0.70 / 0.80 / 0.90 / 1.00
Entropy:
0.10 / 0.20 / 0.30 / 0.40 / 0.50
Vote margin:
0.25 / 0.50 / 0.75
總共有 14 個 fixed-grid risk-coverage points。
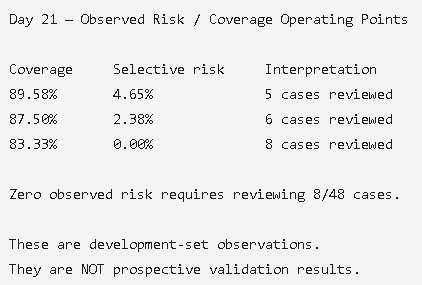
完整結果最後其實只形成三種主要 operating points:
| Coverage | Selective Risk |
|---|---|
| 89.58% | 4.65% |
| 87.50% | 2.38% |
| 83.33% | 0% |
這個結果比找一個「最高 accuracy threshold」更有用。
因為實際系統部署時,問題通常不是:
「哪個 threshold 最準?」
而是:
「我每天最多能 review 幾筆?」
如果 review capacity 很少,可能會選 coverage 89.58% 的 operating point,但 development data 裡還會漏兩個 errors。
如果願意 review 8/48,也就是大約 16.67%,這批資料裡才會出現 observed selective risk = 0。
這就是 Risk-Coverage trade-off。
我原本也加了兩個非常簡單的組合:
Agreement < 0.8 OR Entropy > 0.20
以及:
Agreement < 0.8 OR Vote Margin < 0.50
結果第一條 P5 跟 P3 完全一樣。
第二條 P6 跟 P2 完全一樣。
也就是在目前這 48 題裡,多加一個條件並沒有創造新的 observed decision boundary。
這也是我今天沒有繼續往「把很多 features 塞進 classifier」走的原因。
現在只有 48 cases、6 errors。
拿這些資料直接 train logistic regression、random forest 或其他 model,很容易得到一個看起來很厲害、實際上只是記住 development set 的東西。
目前 deterministic rules 反而比較誠實,也比較容易 audit。
因為 Day 19 的六個 errors 全部在 multi-step,所以我也另外看這 12 題,但這只是 descriptive slice,stratum 本身沒有被 gate 使用。
以 P2 來看:
12 題 multi-step 中:
Coverage:
50%
Accepted 6 題裡:
Selective risk:
16.67%
Error capture:
83.33%
也就是如果只看最難的這一組,P2 必須 review 一半的題目,才抓到六個 errors 裡的五個。
反過來 P1,也就是所有 non-unanimous 都 review,則會:
但 coverage 只剩:
41.67%
所以 full benchmark 上看起來只 review 12.5% 好像很輕鬆,但真正集中風險的 multi-step slice 裡,review workload 其實高很多。
 Day 21 在看結果之前,就先定了一個很簡單的 candidate selection rule:
照這個規則,最後選出:
P2_AGREEMENT_080
正式版本:
day21-p2-agreement-080-v1
SHA-256:
8555b86cabb652d8b98f06f627bbec857350a1988fdc443fccf9f08dbfa411db
規則非常簡單:
agreement < 0.8 → REVIEW
agreement >= 0.8 → ACCEPT
所以剛好等於 0.8 時,是 ACCEPT。
它只需要一個 signal:
sampling agreement
Development-set performance:
如果要用一句比較工程化的方式講:
Review 6/48 個 case,可以攔下目前觀察到的 6 個 errors 中的 5 個,但仍會讓 1 個錯誤答案通過。
這比說「Accuracy 97.62%」更接近真實系統會面對的問題。
這是今天最重要的限制。
Day 21 用的還是 Day 19 那 48 題。
而 Day 19 的六個 errors 我們早就看過了。
所以即使 threshold grid 不是瘋狂 brute-force 搜出來的,最後 P2 仍然是在同一批 development evidence 上被選出來。
換句話說:
83.33% error capture 不是 prospective validation 結果。
它有可能很樂觀。
下一批沒看過的資料,P2 可能抓不到這麼多錯誤,也可能 review 更多正常答案。
所以這次 release 故意把它叫做:
FUTURE VALIDATION CANDIDATE
而不是:
validated policy
更不是:
production gate
Day 21 最後也把未來 holdout validation 的流程先寫好。
下一次不能再拿 Day 19 這 48 題證明 P2。
需要一批新的、完全沒看過 outcome 的 frozen cases。
流程會是:
先 freeze benchmark。
模型產生 primary + 7 samples。
Gate 只拿 Agreement 判斷:
ACCEPT / REVIEW
先把所有 gate decisions freeze。
然後才揭曉 Gold Answer,計算:
而且 candidate hash 必須還是:
8555b86cabb652d8b98f06f627bbec857350a1988fdc443fccf9f08dbfa411db
如果看到新資料結果很差再改成 0.75,那就不是 validation 了。
回頭看這幾天的演進其實滿明顯。
Day 19 告訴我:
模型 48 題錯 6 題,而且 self-confidence 完全看不出來。
Day 20 告訴我:
這六個 error 不是同一種錯法,直接拿 samples 投票也沒有淨提升。
Day 21 才開始問:
既然沒有一個 signal 可以保證答案正確,那是不是乾脆不要每一題都強迫系統回答?
Selective Answer Gate 的想法就是這樣來的。
它沒有讓模型變聰明。
沒有修改 primary answer。
也沒有消滅錯誤。
它只是讓系統有能力說:
「這題我先不要直接放行。」
在目前這 48 筆 development data 上,P2 把 accepted risk 從 12.5% 降到 2.38%,代價是 review 6/48 題。
但 D18-011 還是逃掉了。
所以今天最重要的產出,其實不是 97.62% selective accuracy。
而是我終於有了一條版本固定、規則固定、hash 固定,而且可以拿去碰真正 unseen holdout 的 reliability policy。
下一步才是真正關鍵的地方:
看看它離開這 48 題之後,還剩多少效果。
Day 21 release:
cf6d9ece44aadfca5e572def51416dc31dcff77b
Candidate:
day21-p2-agreement-080-v1
Candidate SHA-256:
8555b86cabb652d8b98f06f627bbec857350a1988fdc443fccf9f08dbfa411db
Day 19 verifier:
22 / 22 PASS
Day 20 reference traces:
12 / 12 PASS
Source REAL evidence:
unchanged
API / Provider / Network calls:
0 / 0 / 0
這次重新 audit 時,現有 Python environment 沒有安裝 pytest,所以我沒有硬把 full-suite 寫成 PASS。現有 artifacts、candidate hash、CLI、offline recomputation、source integrity 和 diff checks 都通過,但這一輪無法重新驗證完整 test suite。這個限制也保留在紀錄裡。


 iThome鐵人賽
 看影片追技術