

Day 21 做完 Selective Answer Gate 後,我終於有了一條可以拿去測的 candidate policy:
agreement < 0.8 → REVIEW
否則:
ACCEPT
它的版本是:
day21-p2-agreement-080-v1
在 Day 19 那 48 筆 development data 上,它會 review 6 題、攔到 6 個錯誤中的 5 個,development error capture 是 83.33%。
但這個數字現在其實不能拿來證明 Gate 有效。
因為 Day 21 的 policy 本來就是在看過 Day 19 那批資料之後才選出來的。即使 threshold grid 是事先限制好的,也還是在同一批已知 outcome 上做 development。
所以 Day 22 我沒有再調 policy,也沒有再打一次模型。
今天做的事情反而有點像出考卷:
重新準備一批完全沒跑過模型的 48 題 holdout,先把題目、Gold、policy、analysis plan 和判定標準全部 freeze。
等這些東西都不能再改之後,下一次 REAL experiment 才有資格叫 prospective validation。
Day 21 最後其實留了一個小問題。
當時重新 audit repository 時,環境裡沒有 pytest,所以雖然既有 artifacts、hash、CLI 和 offline recomputation 都驗過,但沒辦法重新跑完整 test suite。
Day 22 開始前,我先處理這件事。
最後建立 project-local .venv:
因為環境一開始缺 setuptools>=68,這次有允許 Python package installation 的網路存取,但它只用來安裝 repository 原本就宣告好的 dev dependencies。
這和模型實驗分開記錄。
今天:
Model/API requests = 0
沒有任何題目被送去 OpenAI。
環境恢復後先跑 smoke test,再跑 Day 22 focused tests,最後完整 suite 也重新跑過。
Phase B 最終結果:
545 passed,9 skipped
這 9 個 skip 不是測試失敗,而是刻意阻止 Day 21 candidate 重新 replay 已知的 REAL outputs。也就是有些東西我們反而希望測試框架「不要讓你方便重跑」,避免後面的 prospective workflow 被開發資料污染。
新的 benchmark 叫:
day22-prospective-holdout-v1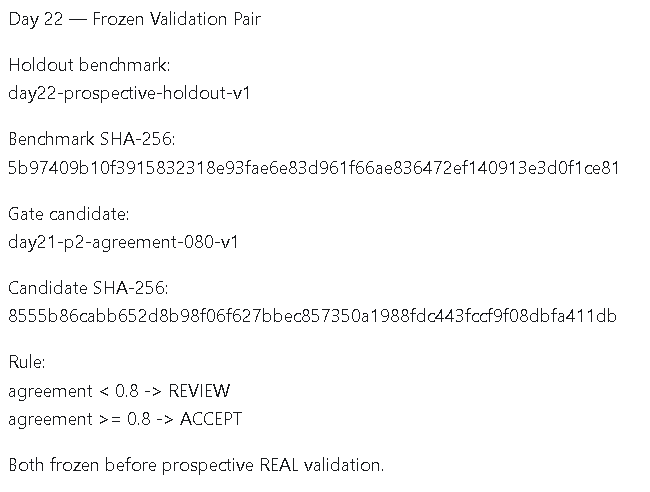
總共還是 48 題,而且沿用前面的四個 strata:
| Stratum | Cases |
|---|---|
| deterministic_short_answer | 12 |
| multi_step_reasoning | 12 |
| insufficient_information | 12 |
| distractor_resistance | 12 |
| Total | 48 |
但這 48 題全部都是新的。
不是從 Day 19 那 48 題抽一半出來,也不是把舊題換數字。
Generator 版本:
day22-direct-generator-v1
Seed:
22012026
之所以保留 fixed seed,是希望整批題目可以 deterministic 地重新產生,而不是先生成幾百題,再人工挑出看起來比較「適合模型犯錯」的那些。
這點對 holdout 很重要。
如果我已經知道哪種題 GPT 容易錯,再特別挑一堆類似題進來,那最後就不是在驗證 Gate,而是在設計一份專門配合舊 failure pattern 的考卷。
所以 Day 22 的 generator 不允許使用 Day 19 的 model outputs、failure labels,也不能把 Day 20 的 trace classes 當成出題依據。
48 題產生後,第一層先做 deterministic validation。
結果:
48 / 48 Gold checks PASS
Multi-step 的 reference logic 要能真的推回 Gold。
Insufficient-information 題則需要在 private validation metadata 裡證明:同一份 visible information 至少允許兩個不同結果,確定真的無法唯一推出答案。
Distractor cases 也會另外紀錄哪些資訊是 relevant、哪些只是 distractor,但這些資訊不會放進 model-visible prompt。
自動 overlap audit 也沒有發現:
不過程式能做的檢查還是有限。
兩題文字可能沒有任何字串一樣,但人看起來還是幾乎同一題;或者某個 insufficient-information prompt 從邏輯上看似沒問題,但人讀起來會覺得其實可以合理推導。
所以這次多加了一道我前面都沒有真的做過的流程:
Human Review。
Phase A 完成後,benchmark 還沒有 freeze。
當時狀態是:
pending_human_review
我先拿到一份 human-review packet,每題包含:
人工 review 的重點不是猜模型會不會答錯,而是看 benchmark 本身有沒有問題。
我檢查的主要是:
題目是不是正常人能理解、Gold 看起來有沒有明顯不合理、題目有沒有不小心洩漏答案、insufficient-information 題到底是不是真的資訊不夠,以及新題有沒有只是舊題換皮。
最後:
48 / 48 approved
Rejected:
0
Requested revisions:
0
而且這個 approval 發生在任何 REAL holdout inference 之前。
這點我覺得很重要,因為如果模型跑完後才回頭說「這題好像有點怪,我們刪掉好了」,那一樣會產生 post-hoc bias。
所以 human review 完成後,題目就不能再因為未來模型表現不好而修改。
Phase B 才真正把 holdout freeze。
Benchmark:
day22-prospective-holdout-v1
SHA-256:
5b97409b10f3915832318e93fae6e83d961f66ae836472ef140913e3d0f1ce81
Release classification:
prospective_holdout_frozen_pre_real
Manifest verification:
PASS
這次 manifest 一共涵蓋 16 個 release artifacts 和 8 個 source hashes。
也就是之後 Day 23 開始跑 REAL experiment 時,如果 benchmark、generator configuration、preregistration 或其他 frozen artifact 中任何一個被改掉,verification 應該會直接發現。
Day 19 verifier 也仍然是:
22 / 22 PASS
Day 20 trace validation:
12 / 12 PASS
舊資料沒有因為建 Day 22 holdout 被回頭改掉。
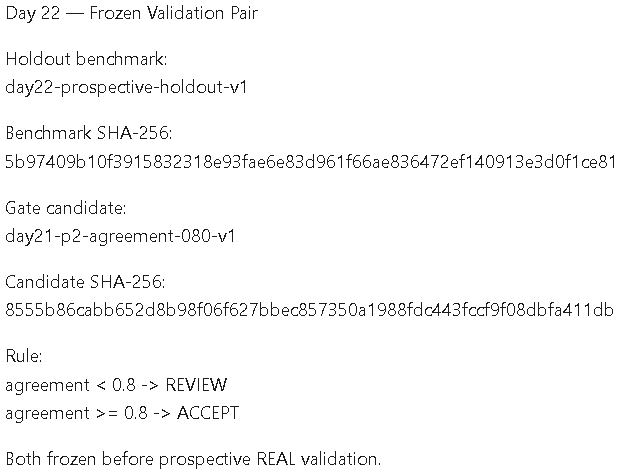 不只是 benchmark freeze。
Day 21 選出的 candidate 也完全原封不動:
day21-p2-agreement-080-v1
SHA-256:
8555b86cabb652d8b98f06f627bbec857350a1988fdc443fccf9f08dbfa411db
規則仍然只有一句:
agreement < 0.8 → REVIEW
agreement >= 0.8 → ACCEPT
包含剛好等於 0.8 的 case,也會 ACCEPT。
接下來即使 Day 23 跑出來發現 0.8 很難看,也不能看到結果後改成 0.75,再說這是同一場 validation。
真的要改,就必須承認 Day 23 validation 失敗或不理想,再建立下一版 policy,用下一批資料重驗。
Day 23 的 workflow 這次也被寫死。
順序是:
primary + samples
→ normalization
→ agreement
→ frozen gate
→ ACCEPT / REVIEW decision
→ persist + freeze decisions
→ gold scoring
這個順序和一般 offline evaluation 最大的差別是:
Gate decision 必須在 correctness 被計算以前就固定。
Gate 不能看到:
Case ID 可以拿來把紀錄對起來,但不能成為 decision feature。
這樣 Day 23 跑完後,如果某題被 ACCEPT 但答案錯了,我們不能假裝 threshold 本來會把它 REVIEW。
那就是一個真正的 escaped error。
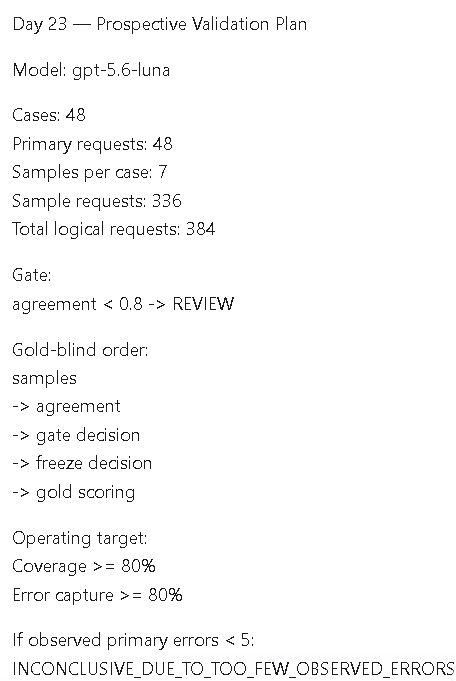 Day 23 已經 freeze 的 REAL design 是:
Model:
gpt-5.6-luna
48 個 holdout cases。
每題:
所以:
| Component | Requests |
|---|---|
| Primary | 48 |
| Samples | 336 |
| Total | 384 |
Retries:
0
如果中途失敗,只 resume unresolved slots。
store = false
所以明天會是和 Day 19 一樣規模的 384 REAL requests。
差別是 Day 19 那一批後來被拿來 development policy,而 Day 23 這批在模型開始前,benchmark 和 policy 都已經不能再動了。
如果只是等結果出來再說:
「嗯,看起來還不錯。」
那還是很容易自我解讀。
所以 Day 22 連 validation target 都先 freeze。
P2 candidate 的 descriptive operating target 是:
Coverage ≥ 80%
而且:
Error Capture ≥ 80%
兩個都要達到。
但是這裡還多加一條:
如果整份 holdout 最後 primary errors 少於 5 個,即使 error capture 算出來是 100%,validation status 也要標成:
INCONCLUSIVE_DUE_TO_TOO_FEW_OBSERVED_ERRORS
原因很好理解。
假設 48 題只錯 1 題,而 Gate 剛好抓到那 1 題,數字會寫成:
100% error capture。
但「抓到 1/1」的證據其實非常弱。
所以這次直接在結果出現前,把 minimum observed error rule 寫進 preregistration。
48 題還是小樣本。
所以 Day 23 除了 point estimate,也事先決定對幾個 binomial proportions 報 95% Wilson interval:
如果 denominator 根本不存在,例如完全沒有 review cases,則直接回:
null / undefined
而不是硬算。
這些 interval 也是現在就決定要算,不是看到結果很漂亮或很難看後才加。
今天其實沒有任何「AI 表現」可以報。
沒有 Accuracy。
沒有 Agreement。
沒有 Gate error capture。
因為模型根本還沒看過這 48 題。
今天的工作全部都在 REAL experiment 發生之前完成:
最後 test suite:
545 passed,9 documented skips
Focused tests:
100 passed
Model/API requests:
0
Benchmark SHA-256:
5b97409b10f3915832318e93fae6e83d961f66ae836472ef140913e3d0f1ce81
Day 22 commit:
c440e5a43aba3d0010dfa6a7e7ab07811830f10c
做到這裡,下一步反而很單純。
明天不調 threshold。
不換題目。
不改成功標準。
把這 48 題真的送進模型,先讓 Gate 做完 ACCEPT / REVIEW 決策,再揭曉 Gold。
到時候結果是漂亮還是難看,就照原樣留下來。
那才是這條 Gate 第一次真正的測驗。


 iThome鐵人賽
 看影片追技術