
要用同步 API,還是改成事件處理?我會先從使用者的畫面想起:按下按鈕後,他需要立刻看到什麼?庫存查詢可能要馬上有答案,通知則可能晚幾分鐘也沒關係。先知道這個差別,再選做法。
如果使用者下一步一定要用到最終結果,就要把等待方式和完成時間設計好。如果先看到「已收到,處理中」就能繼續作業,後續工作就有非同步處理的空間。這個條件,應該先和使用單位確認。
| 問題 | 偏同步 | 偏非同步 |
|---|---|---|
| 呼叫者需立即得到結果? | 是 | 否 |
| 可否接受最終一致? | 否 | 是 |
| 下游可能暫時不可用? | 影響流程 | 可稍後處理 |
| 需要重播或多訂閱者? | 少 | 多 |
上面四個問題,我會分開確認。有些步驟確實需要立即完成,但通知、索引更新或外部同步,不一定都要讓使用者一起等。把每一步的需要看清楚,才知道哪一段可以拆開。
例如,訂單請求可以先回覆已接受,再透過事件處理後續工作。但我會把「已接受」和「已完成」寫得很清楚,讓使用者知道,目前到底走到哪一步。
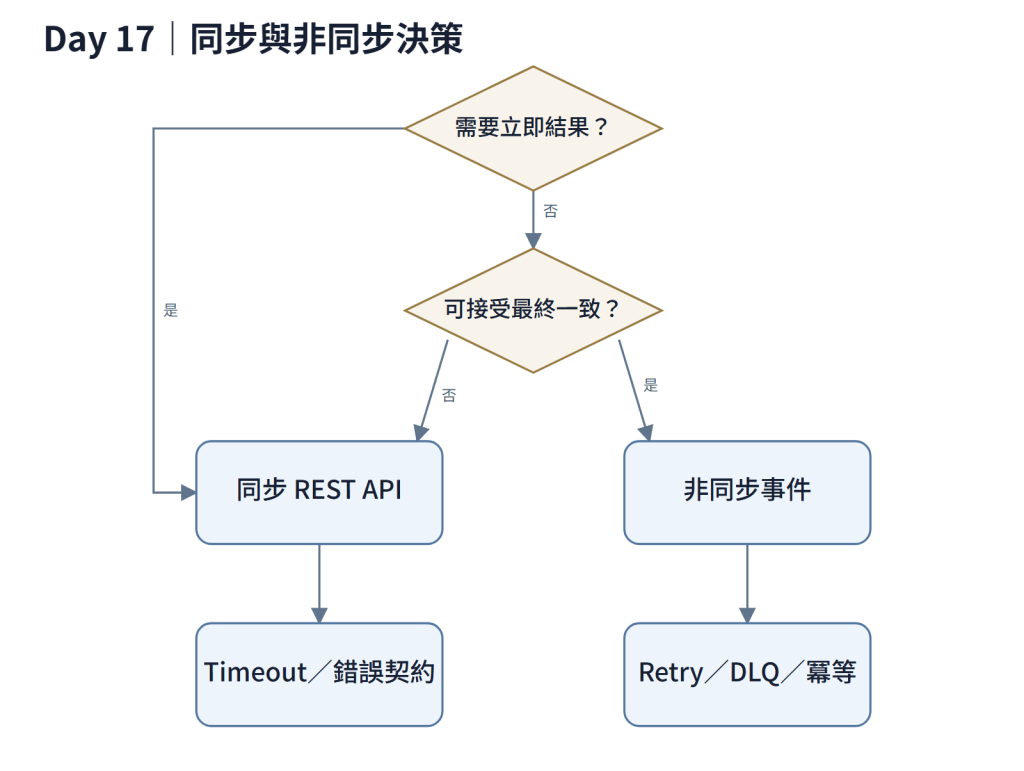
圖 Day 17-1:同步與非同步決策。
如果畫面只寫成功,使用者自然會以為全部完成,所以這份狀態也要一路做到畫面與資料模型。後面有哪個步驟失敗,也要有地方能查,才不會變成雙方認知不同。
所以,評估非同步時,我會一起算進狀態查詢的工作:目前進度、已完成的下游,以及失敗時誰處理。這些準備做好,使用者才有辦法安心等待結果。
事件至少定義 eventId、eventType、occurredAt、aggregateId、schemaVersion、correlationId 與必要 payload。
事件欄位也各有用途。eventId 用來去重,schemaVersion 說明格式版本,correlationId 則把事件和原本的請求接起來。我會希望後面查問題時,仍能沿著這些資訊把整段過程找回來。
Consumer 必須做到冪等,失敗時有 retry 與 DLQ。冪等不是加上重試就會自然成立,Day 19 會說明實作方式。
呼叫端已經等不下去時,下游可能還在執行,這時要能查到操作狀態,避免一邊以為失敗,另一邊其實已經完成。所以同步 API 也要準備 timeout、錯誤契約與取消行為。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 使用者路徑同步、後續下游非同步 | 使用者等待時間可控,下游失敗不影響主流程 | 下游結果成為使用者當下決策依據時 |
| 非同步流程額外提供狀態查詢 | 「已接受」必須可以追到後續結果 | 無;缺少狀態查詢的非同步是不完整的 |
| 事件一律帶 correlationId | 追蹤不應在事件邊界斷掉 | 無 |
| 同步 API 明確定義取消行為 | 逾時後的狀態不可以是未定義 | 無 |
非同步讓下游有時間慢慢完成工作,也多了狀態與一致性管理。同步比較容易順著流程理解,但如果一次請求要經過很多服務,各層等待與逾時就要一起安排。兩邊的準備工作,都算進去再決定。
| 指標 | 計算方式 | 想回答的問題 |
|---|---|---|
| 使用者等待時間 | 從送出到畫面回應的時間 | 同步部分是否維持在可接受範圍? |
| 端對端完成時間 | 從接受到全部下游完成的時間 | 非同步部分是否在承諾時間內完成? |
| consumer lag | 待處理訊息數與延遲 | 下游處理能力是否足夠? |
| 重送率 | 重送次數/訊息總數 | 失敗是偶發還是持續? |
| 逾時比率 | 逾時請求數/全部請求數 | 逾時設定是否合理? |
畫面很快回應,是一項改善;業務最後多久才完成,則是另一件需要持續確認的事。所以我會把使用者等待時間和整段流程完成時間一起看。
一條流程裡,可以有需要立即完成的部分,也可以有稍後處理的工作。我認為最重要的,是讓每個回應和狀態都有清楚意思。下一篇,接著看看 Kafka 與 RabbitMQ 適合承接哪些需求。


 iThome鐵人賽
 看影片追技術