
【Day - 15】介紹過的 grill-me,讓我重新注意到 Speclink 裡比較少用到的 Interview。它會先整理問題之間的關係,再根據前面的答案繼續追問。這種把決定一項一項問清楚的方式,是不是也能放進自己的 discuss 呢?
當時 Speclink 還沿用 Spectra discuss 的問法,所以我先和 AI 一起看原本的 Interview,確認哪些地方可以調整。
grill-me 的提問方式,讓我很有「把問題一項一項拷問到底」的感覺。不過,和 AI 一起看過後,我發現 Spectra discuss 的 Interview 已經能一次問一題。我想借用的,是 grill-me 安排問題的方式:哪些決定要先做?哪些問題得等前面有了答案才能問?哪些事情其實由 AI 查資料就能知道?
所以,我最初把 decision tree(決策樹)加進原本的 Interview,保留一次問一題的方式。AI 先整理問題之間的關係,能從程式、檔案或工具查到的事實自己查,需要我選擇的部分才拿出來問。等前面的問題有了答案,再繼續處理後面的問題。
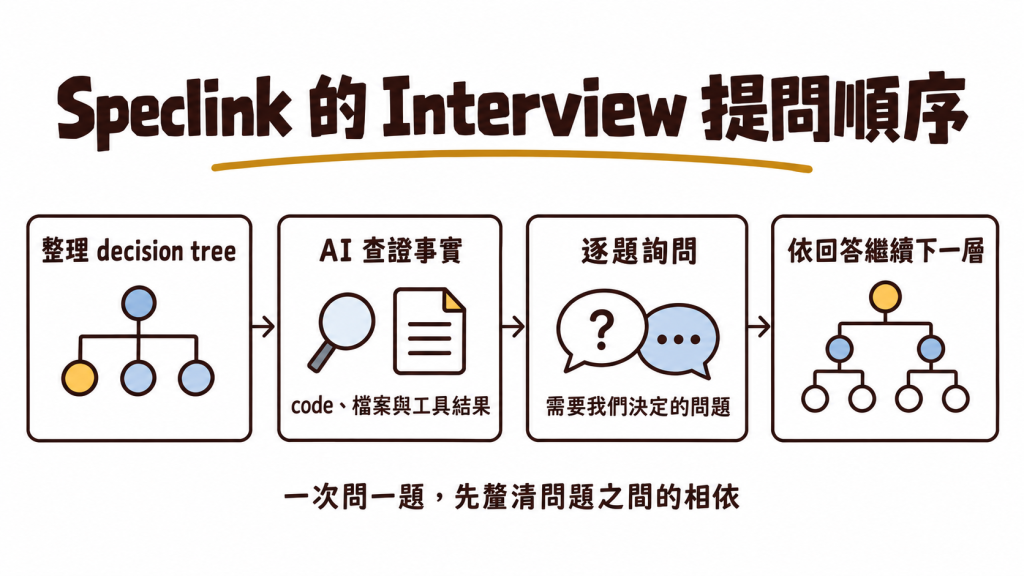
當時我就想:「這樣調整後,Interview 應該就很有 grill-me 的感覺了吧?」
調整完後,我就繼續照平常的方式使用 discuss。只是用了一段時間後,我才發現:怎麼好像每次都直接進入 Assumptions,Interview 還是很少出現呢?
原因出在 Skill 怎麼指示 AI 選擇問法。【Day - 15】提過,當時 AI 會先搜尋相關程式檔案,找到三份以上,就按照 Skill 的規則進入 Assumptions;不足三份,才進入 Interview。Speclink 第一版也沿用這個作法,所以即使我調整了 Interview,只要 AI 一開始依照規則進入 Assumptions,就不會用到剛補上的問法。
和 AI 繼續比較後,我們發現,Assumptions 和 Interview 其實都要求提出有依據的建議,主要差在一次列出假設,還是一次問一題。找到多少檔案,也無法保證每個決定都有足夠依據。所以,在當時的討論裡,先提出了一個調整方向:預設讓 AI 列出 Assumptions,遇到依據不足、需要我選擇的地方,再針對那個決定逐題追問,不必替整場討論選定同一種模式。
不過,這樣還少了我原本想要的需求釐清。如果我只說「想調整登入流程」,AI 很快就能找到相關檔案,卻還不知道我要改善速度、調整錯誤提示,還是加入 MFA。這時直接列出 Assumptions,即使後面可以追問,前面的作法仍然是猜出來的。我希望它先問清楚我要什麼,再提出作法。
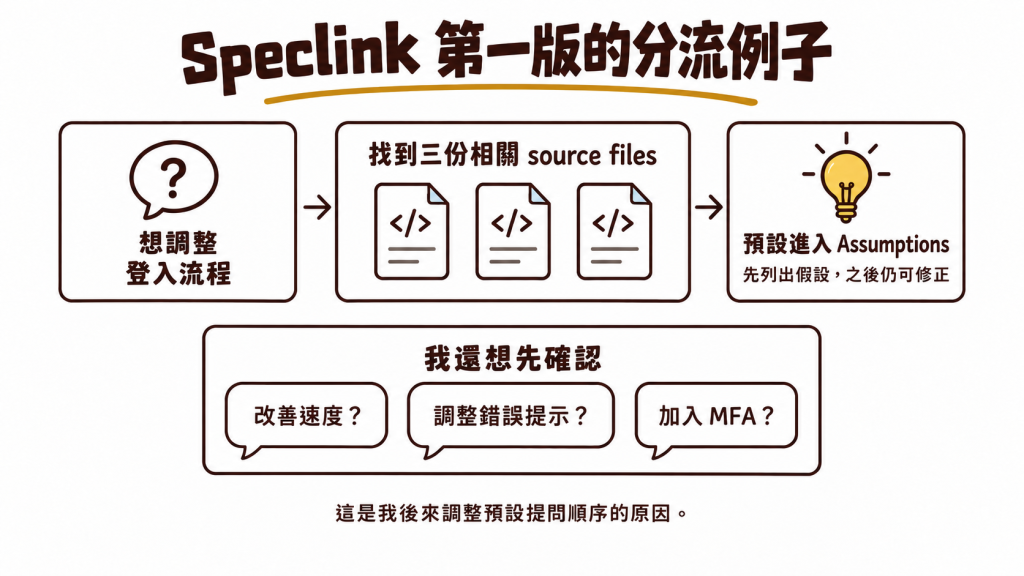
當然,我們可以像【Day - 15】說的,手動切到 Interview;但我想調整的是預設順序:對我來說,需求還沒說清楚時,先逐題回答會比較順手。所以,我最後拿掉了檔案數量的門檻,保留開場逐題釐清需求的 grill 階段,再讓 AI 進入 Assumptions;如果需求一開始就清楚,就直接列出假設。
這樣就留下了兩種需要提問的時機:開場先問清楚「我想要什麼」,提出作法後,再確認「這樣設計對不對」。Interview 的逐題問法在兩個地方都用得到,也就不再是只靠檔案數量決定要不要進入的獨立模式。
這次討論也一起處理了 AI 在提問以前讀了什麼。專案裡已經累積了正式 specs,這些規格能不能幫它更快找到這次討論需要的背景?
Speclink 第一版會先從主題挑出關鍵字,搜尋相關程式。後來專案裡累積了正式 specs,我希望 AI 開始討論前,先看看規格原本怎麼描述這項功能。所以改成先查 specs,確認這次是在調整既有功能,還是準備加入新功能,再用規格裡的名稱去找相關程式。
先讀規格也不是要拿舊規格擋住新需求。如果這次就是要改掉原本的行為,AI 只要先指出哪些地方會受到影響,接著還是可以繼續討論。
正式 specs 能讓 AI 知道目前的功能怎麼運作,但有些討論結果不會寫進規格。例如某個作法以前比較過,最後決定不採用,只看 specs 和 code,就不一定知道當時為什麼放棄。AI 也可能再次提出相同的建議,讓我們又得解釋一次。
既然 discussion 已經留下這些原因,我就希望 AI 開始新的討論前,也能先找找以前談過什麼。
還記得【Day - 16】的通知範例嗎?當時選了 SSE、排除 WebSocket,也把歷史通知補送留到以後。下次再談通知功能時,AI 如果先讀過這份紀錄,就能知道哪些作法考慮過、哪些問題還留著。不過,如果這次真的需要雙向通訊,當然也可以重新考慮 WebSocket;先前的理由是拿來參考,不是以後都不能改。
所以,我在 discuss Skill 裡加上了搜尋舊討論的步驟。AI 查完正式 specs 後,會用規格裡的名稱與這次主題的關鍵字,尋找進行中或已封存的 discussion,再帶著找到的背景去查 codebase。
搜尋的是前面保存的 discussion 文件,不是整份聊天紀錄。AI 會比對討論主題、識別名稱,以及紀錄裡的決定、排除原因與暫緩項目,先整理找到的相關決定,再挑最多三份相關的 Conclusion 詳讀,不會一開始就把所有舊文件都讀進來。
建立這次的新 discussion 時,AI 也會在 Context 的 Prior discussions: 記下參考過哪些 discussion;沒有找到就寫 none。這樣下次回來,除了看得懂這次的討論,也找得到它參考過的舊紀錄。
這裡是在替新的討論找背景,所以查到的舊 discussion 會作為參考,後續建立紀錄時仍會另建一份。如果只是想繼續上次還沒談完的主題,就直接讀取並接著寫原本的 discussion,不需要再建一份。
背景查過後,AI 會先確認:這次想達成什麼、有哪些限制,以及做到什麼程度才算完成?如果還不清楚,就透過 Interview 一次問一題。我把開頭這段釐清需求的過程稱為 grill,問答會留在 Rounds 裡,標記為 interview。
需求問清楚後,再進入 Assumptions,讓 AI 根據查到的資料提出作法,並說明理由。如果需求一開始就很明確,就可以直接從 Assumptions 開始。
列出假設後,也可能還有需要我們決定的地方。這時 AI 會針對那個問題繼續問,附上建議答案與查到的依據,這一輪同樣記成 interview。所以,看到這個標記,表示這一輪是在問問題,不一定代表討論還停在開頭的 grill。能查資料確認的事實,仍然由 AI 自己查。
那前面提到的 decision tree,在這裡怎麼用呢?不管是開頭釐清需求,還是列出假設後繼續追問,都得先確認哪些問題應該先問。例如,還不知道這次調整登入流程是不是要加入 MFA,就先問要用簡訊還是驗證器,可能根本不需要討論到這一步。
所以,我把「先整理問題的先後關係,再一次問一題」保留下來,讓這兩種情況都按照相同方式處理。
如果 Assumptions 已經列出了需要確認的決定,就可以直接用這份清單繼續討論,不必另外畫一棵決策樹。AI 只要說清楚現在問的是哪個決定,再根據答案接著問,就能把前後相關的問題依序談清楚。
從【Day - 14】一路談到這裡,我們分別看了怎麼保存討論、把結論接進 change,以及 AI 怎麼查資料和提問。把這些作法放在一起,就能看出一場 discuss 是怎麼進行的:
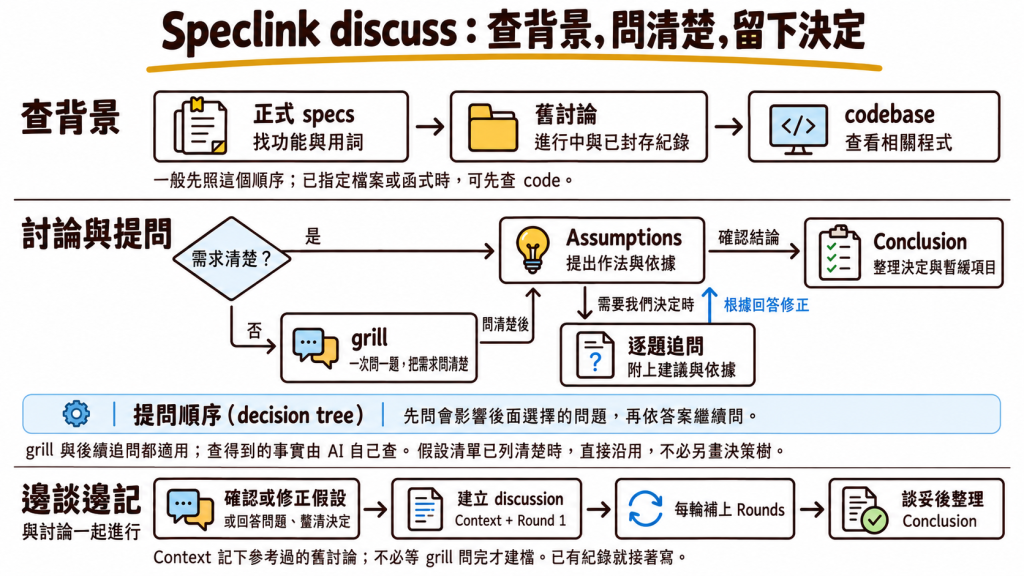
圖裡先查 specs、舊討論,再查 code,是一般情況下的順序。如果一開始就指定了某個檔案或函式,也可以先看程式,再補查相關背景。
圖中間也畫出了提出假設後怎麼繼續討論:遇到需要我們決定的地方,AI 會附上建議與依據,一次問一題,再根據回答修正原本的假設。不管是開頭的 grill,還是這裡的追問,都會先確認哪些問題要先問、哪些得等前面有了答案才能繼續。淡藍色區塊裡的「提問順序(decision tree)」說的就是這個方式,不需要另外跑一輪流程。
討論的內容也會邊談邊記。當我確認或修正一項假設,或回答問題、釐清一個決定後,就會建立 discussion,寫下 Context 與第一個 Round,不必等 grill 全部問完。後面每談一輪就繼續記錄,談妥後再整理 Conclusion;如果是接著上次的討論,就直接寫進原本的紀錄。
到這裡,AI 怎麼找資料、怎麼問,以及討論怎麼留下來並接進 change,就都串起來了。Speclink discuss 也終於說完啦!
等討論有了結論,決定透過 propose 建立 change、準備規格時,還有一件事要確認:這次談好的功能,應該補進哪份既有規格?還是真的需要新增一份?
【Day - 9】看過的 auth 與 authentication 就是例子。同一個功能只是換個名字,卻可能被當成兩個 capabilities,最後留下兩份規格。接下來,我們就看看 Speclink 怎麼在建立規格以前,先把這件事確認清楚吧!
grill-me Skill
grilling Skill
discuss-skill 正式規格


 iThome鐵人賽
 看影片追技術