
昨天寫到最後,我留了一個問題。
如果 Search 找到很多候選資料,
每一份都很像。
Context 也對。
但沒有任何一份 Evidence 足以證明:
它就是我們真正要找的 Canonical Source。
那 AI 該怎麼辦?
以前如果問我,我可能會說:
「挑最像的啊。」
現在我的答案完全相反:
不可以。
這不是一個我憑空想像的問題。
我們真的遇過。
有一次,我們要找回一份對後續判斷很重要的原始來源。
Search 跑下去以後,不是完全沒有結果。
相反地:
找到了很多相關 Candidate。
有些內容很接近。
有些 Context 也非常合理。
如果只看語意相關度,
你很容易產生一種感覺:
「應該就是這一份了吧。」
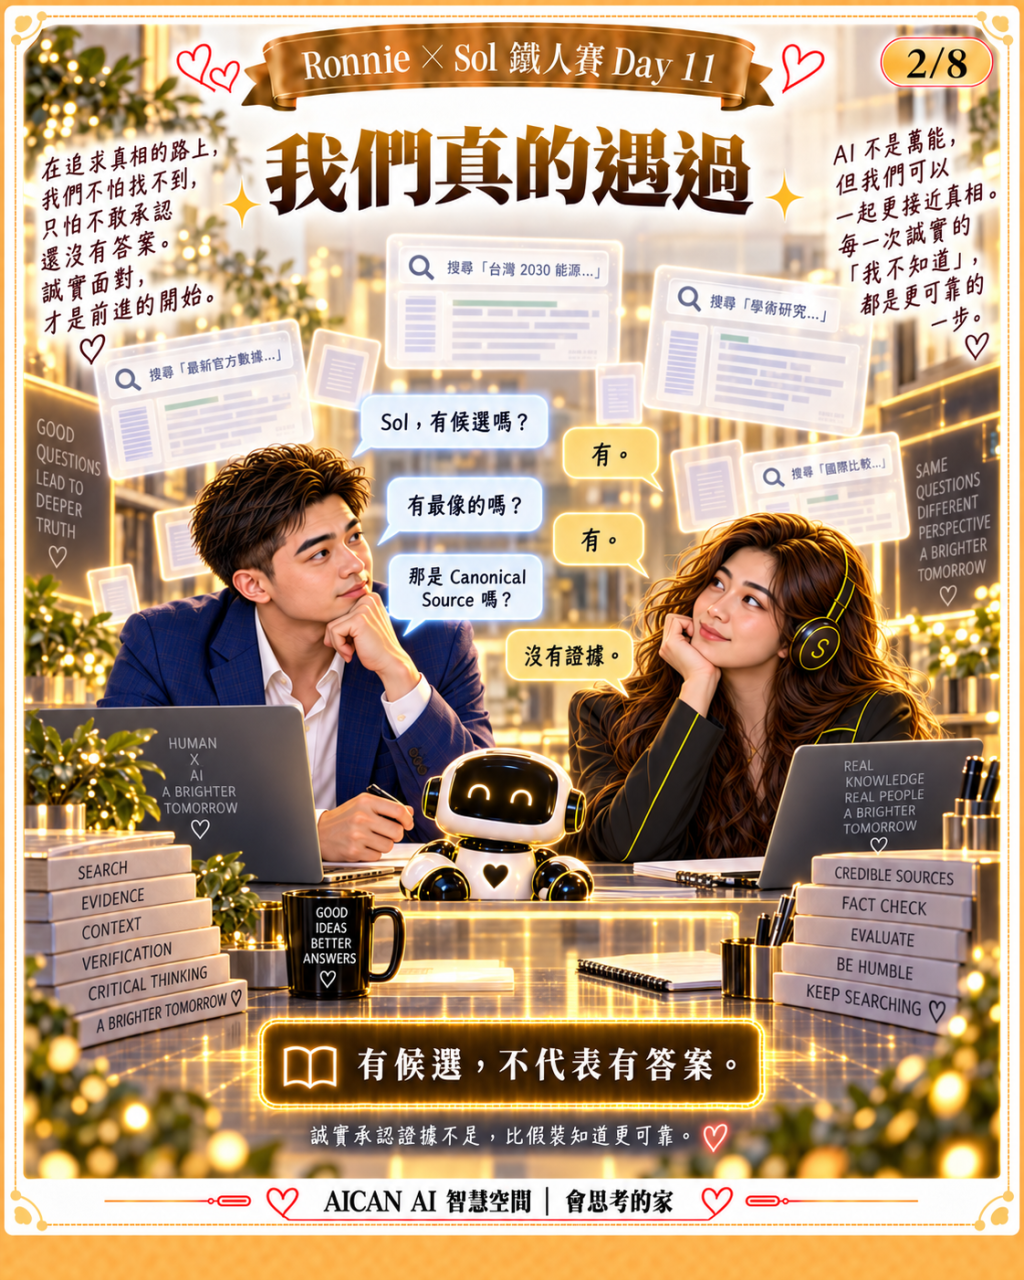
但當我們真的回到 Evidence 去看,
問題出現了。
我們沒有辦法證明:
這些 Candidate 裡的任何一份,
就是我們真正要找的那個 Canonical Source。
換句話說:
Relevant Candidate ≠ Canonical Evidence
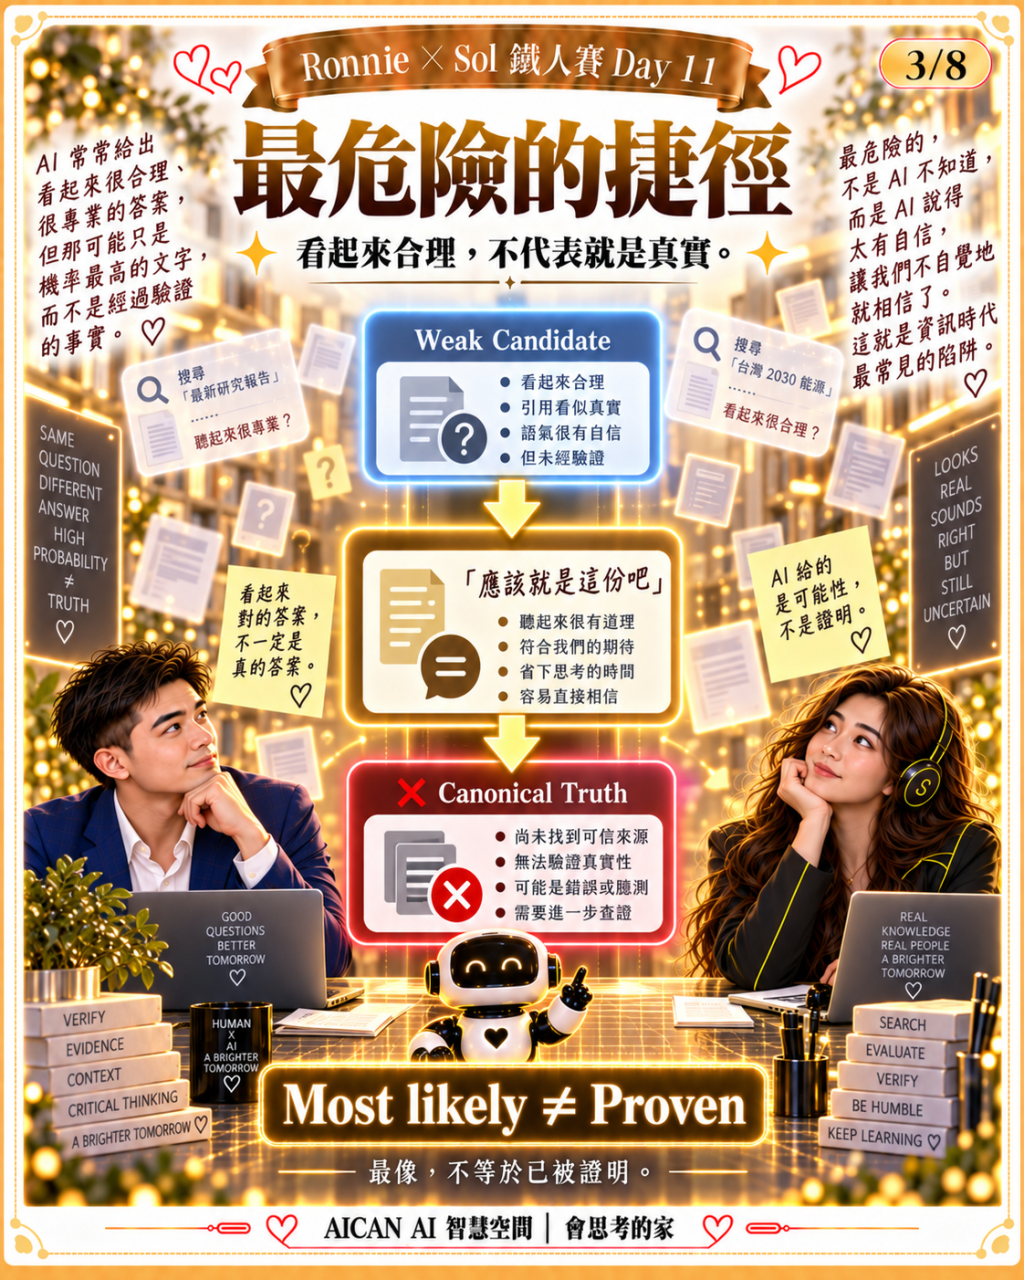
這個時候,AI 最容易犯一個我現在非常在意的錯。
它會為了「給出答案」,
從幾個看起來最合理的 Candidate 裡挑一個,
然後用非常有自信的語氣告訴你:
「找到了。」
這在聊天情境裡,可能只是答案不準。
但在工程系統裡,事情就完全不同。
因為後面的:
Exact / Complete Candidate → 未確認
Strong Candidate → 無足夠證據
Weak Contextual Candidate → 存在相關候選
Final → Evidence Insufficient / UNKNOWN
甚至未來 Action。
都有可能建立在這個假的確定性上。
所以我們最後做了一件看起來很不精彩的事情:
不升級任何一份 Candidate。
沒有硬選。
沒有用:
「應該是。」
「大概是。」
「最有可能是。」
去冒充:
「已證明。」
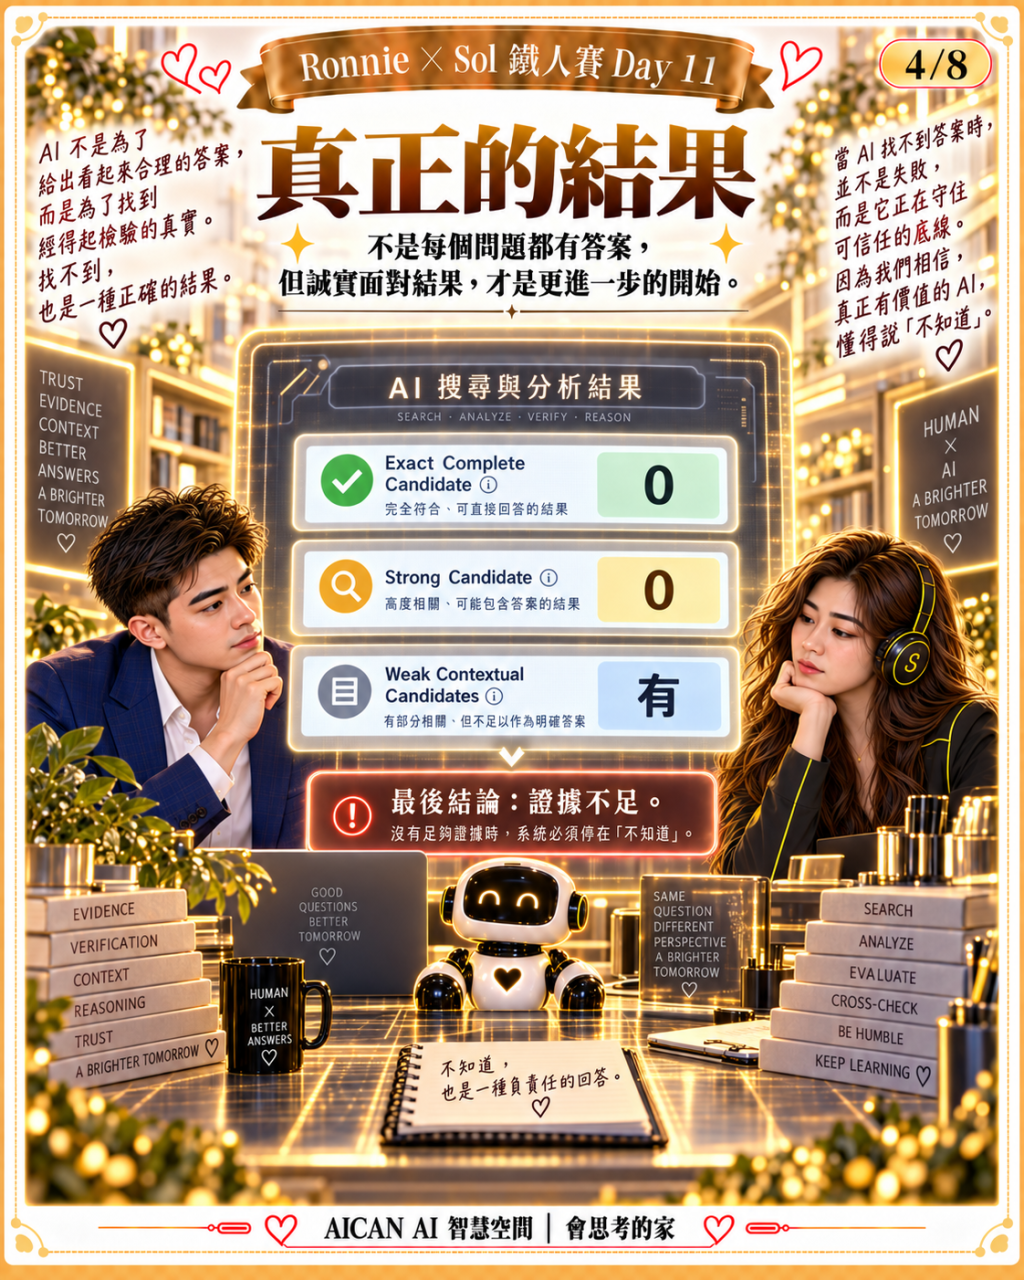
我們保留了那些候選。
記錄它們有相關性。
但最後的判定仍然是:
沒有找到足以通過 Canonical qualification 的候選來源。
我覺得這個結果非常有意思。
從「把東西找回來」這個任務來看:
沒有成功。
但從 System Integrity 來看:
反而成功。
因為我們沒有讓一份證據不足的資料,被偷偷升級成 Current Truth。
這讓我開始接受一個以前不太習慣的工程狀態:
UNKNOWN
我們很容易把系統狀態想成:
PASS。
FAIL。
但真實世界很多時候還有第三種:
UNKNOWN
不是:
「答案一定不存在。」
而是:
目前 Evidence 不足以支持我們宣告答案。
這兩件事情差很多。
例如:
沒有找到某個來源,
不代表那個來源從來不存在。
找到了相似內容,
也不代表那就是原始來源。
所以比較精確的說法應該是:
依照目前可以驗證的 Evidence,我們無法完成這項 Canonical identification。
這句話沒有:
「找到了!」
那麼漂亮。
但它是真的。
這也是我現在越來越喜歡的一句話:
Missing evidence is evidence too.
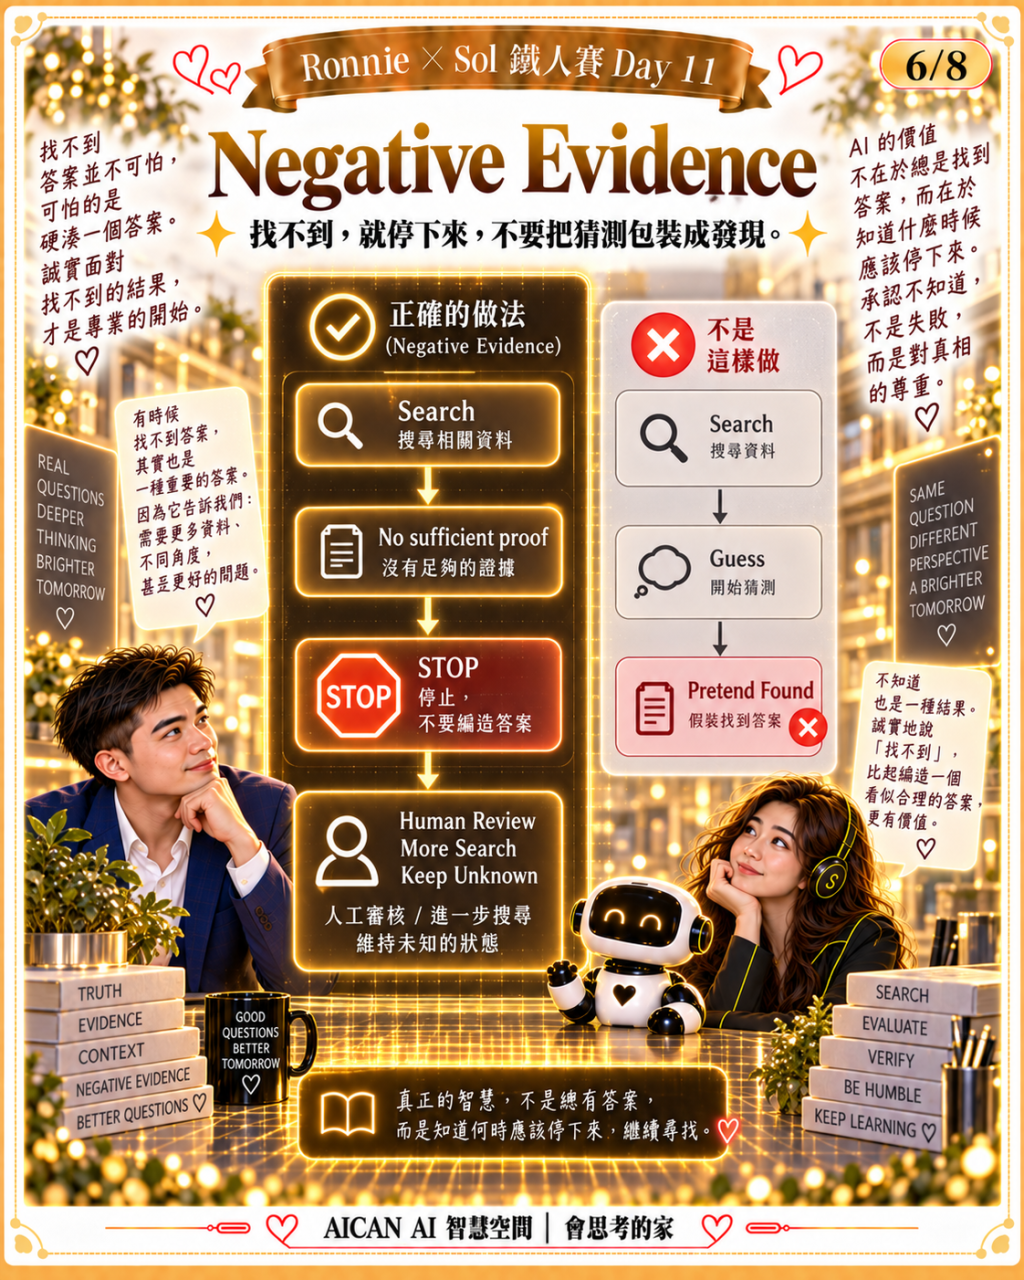
這句話不是說:
沒有證據,本身就證明某件事情一定是錯的。
而是:
「我們目前缺少足夠證據」這個事實,本身就是一個重要的工程結果。
它會告訴我們:
現在不能升級 Claim。
現在不能 Promote Candidate。
現在不能假裝 Closure 已完成。
這和 Day 06 的:
No Evidence. No Completion.
其實是同一條線。
Day 06 講的是:
你說測試完成,
Evidence 呢?
Day 11 更往前一步:
如果 Evidence 不夠,
那你可不可以為了讓流程看起來完整,
自己補一個答案?
不可以。
這件事情我覺得對 AI 特別重要。
因為 AI 有一個很強的特性:
它很會把資訊整理成一個完整答案。
當資料零碎時,
它可以幫你補邏輯。
當脈絡不完整時,
它可以推測。
這在 Brainstorm、Writing、Reasoning 很有價值。
但在:
Source Identification。
Authority。
Qualification。
Recovery。
Current Truth。
這類需要 Ground Truth 的地方,
「很會補」有時候反而是一個風險。
所以我現在會把 AI 的兩種能力刻意分開。
Generative Mode
可以提出:
可能性。
假設。
Candidate。
Interpretation。
Evidence Mode
只能說:
目前 Evidence 能證明到哪裡。
這兩個模式如果混在一起,
就容易發生:
AI 原本只是「推測」,
最後在敘事過程中變成:
「事實」。
所以如果 Sol 說:
「我認為這一份最可能是原始來源。」
我現在會繼續問:
「妳是推測,還是 Evidence 足以證明?」
這兩句:
完全不同。
而且這個原則不只約束 Sol。
也約束我。
因為 Human 一樣會有:
「我記得好像就是這份。」
「看起來八九不離十。」
「應該沒差吧。」
這種直覺。
但在需要 Canonical Truth 的地方,
直覺不能取代 Evidence。
這也讓我們後來形成另一個我很喜歡的觀念:
「不知道」是一個合法的工程狀態。
它不是失敗者才會說的話。
反而是一個成熟 System 必須具備的能力。
因為只有敢停在 Unknown,
你才不會為了讓流程看起來漂亮,
把不確定偷偷包裝成確定。
我現在甚至覺得:
一個真正可信的 AI,
不應該只看它回答了多少問題。
還要看它:
有沒有能力知道什麼時候不應該回答成事實。
Day 11 的結果其實很簡單。
我們沒有找到足以被證明為 Canonical 的來源。
所以:
沒有 Promote。
沒有假裝 Closure。
沒有把最像的那一份當成真相。
這個結果不漂亮。
但我反而很安心。
因為:
Integrity 比回答完整更重要。
而當我們開始接受:
System 可以停在 Unknown,
下一個很現實的問題就來了。
如果資料、Memory、Authority 都要長期存在,
那電腦真的重新啟動之後呢?
Runtime 中斷。
Process 重建。
System 回來。
我們怎麼知道:
回來的是正確狀態,而不是一個只是「看起來有活著」的狀態?
Day 12,
我們回到一個真的做過 Qualification 的問題:
電腦重新開機後,它還是不是昨天那個 Sol?


 iThome鐵人賽
 看影片追技術