

Day 9 把 redacted_text 和 entity_candidates 接回同一版 source_text。這能避免三份資料各說各話,卻還不能回答一個更實際的問題:三份資料都對得上來源時,這筆案例就能進測試集了嗎?
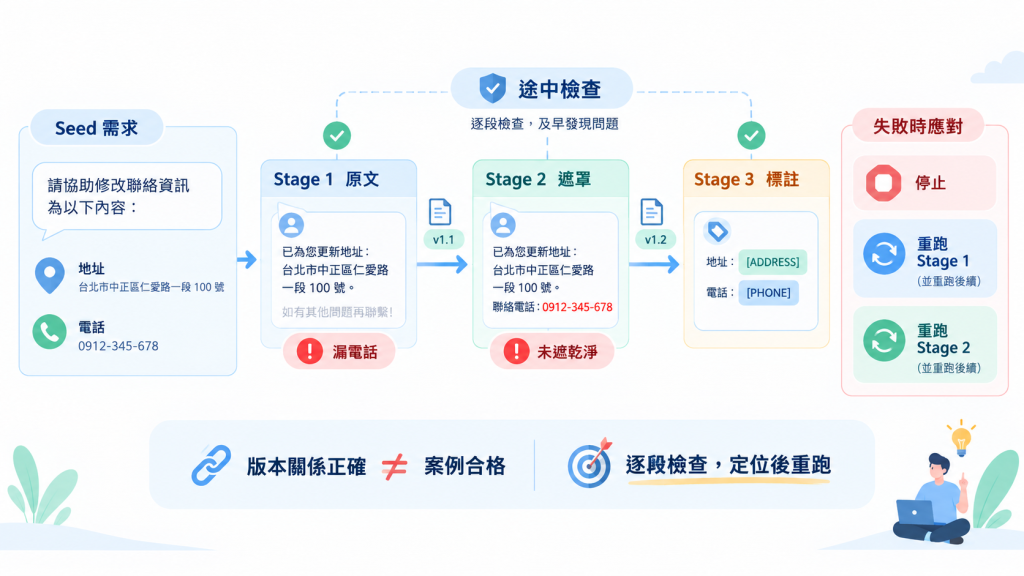
想像一筆地址變更客服資料:原文確實由指定 Seed Data 產生,遮罩與候選標註也都指向這份原文。但原文少了 Seed Data 要求的電話;或者原文沒問題,遮罩後仍留下完整電話。版本關係全都正確,資料仍然不該被當成合格的 PII 測試案例。今天要處理的,是生成途中何時檢查、失敗後怎麼處置,以及哪一段需要重跑。
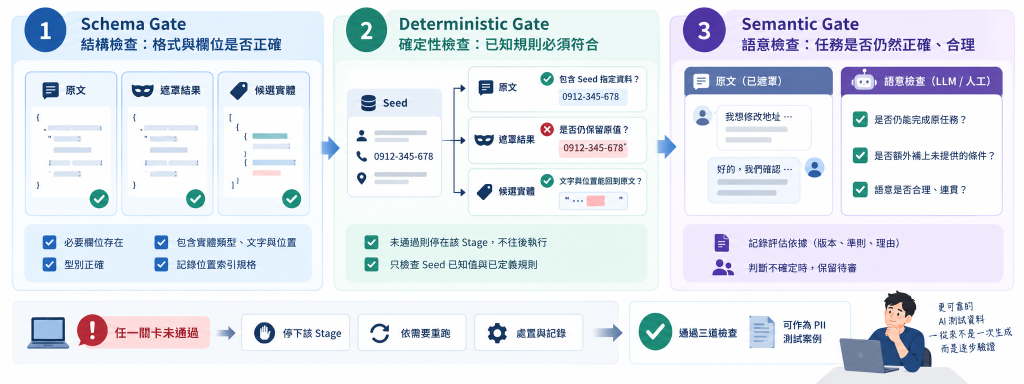
第一道是結構檢查(Schema Gate)。原文、遮罩結果與候選實體各有約定格式:必要欄位是否存在、型別是否正確,entity_candidates 是否真的包含實體類型、文字與位置,並記錄位置採用的索引規格。這道檢查能攔下無法解析或缺欄位的產物,但 JSON 合法,並不能證明電話已遮住。
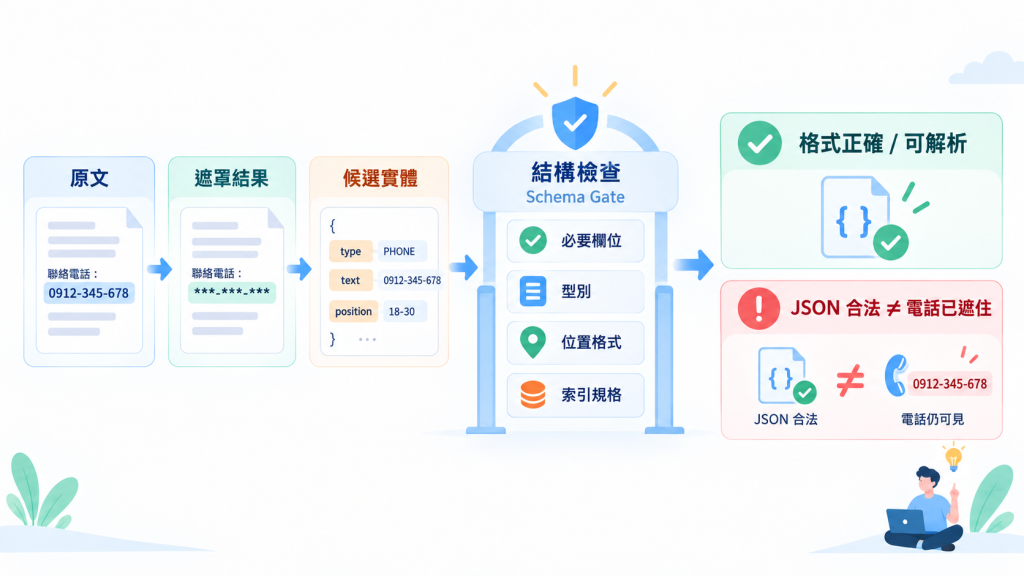
要擋下缺欄位或型別錯誤,筆者用 Python 型別檢查中常用的 Pydantic 做驗證示意:
from typing import Literal

from pydantic import BaseModel, ConfigDict, ValidationError

# 定義有甚麼回傳和型別
class Entity(BaseModel):
    model_config = ConfigDict(strict=True, extra="forbid")
    type: str
    text: str
    start: int
    end: int

class Candidate(BaseModel):
    model_config = ConfigDict(strict=True, extra="forbid")
    record_id: str
    source_version: str
    source_text: str
    redacted_text: str
    index_unit: Literal["python_str"]
    entity_candidates: list[Entity]

def schema_gate(data: dict[str, object]) -> bool:
    try:
        Candidate.model_validate(data)
    except ValidationError as error:
        print("REJECT: SCHEMA_INVALID", error.errors()[0]["loc"])
        return False
    print("PASS: schema")
    return True

sample = {
    "record_id": "PII-01-001",
    "source_version": "v1",
    "source_text": "請修改地址,電話是 TEST-PHONE-001。",
    "redacted_text": "請修改地址,電話是 [電話]。",
    "index_unit": "python_str",
    "entity_candidates": [
        {"type": "PHONE", "text": "TEST-PHONE-001", "start": 10, "end": 24}
    ],
}
schema_gate(sample)
schema_gate({**sample, "source_version": 1})
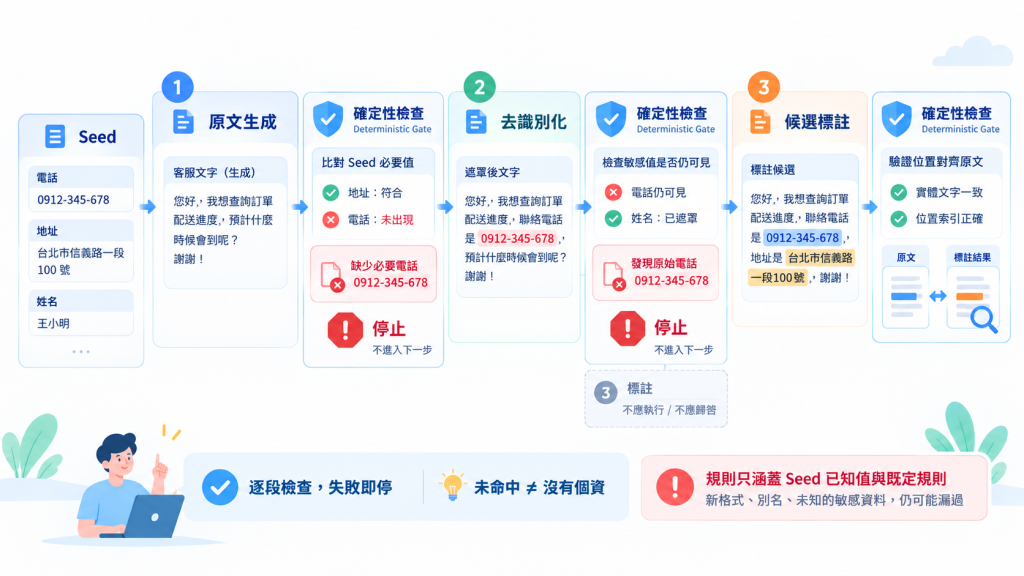
確定性檢查(Deterministic Gate)處理有明確答案的條件。對這組客服案例,至少要核對原文是否包含 Seed Data 指定的虛構資料、遮罩結果是否仍保留已知的姓名或電話原值,以及候選實體的文字與位置能否依約定的索引規格回到同一版原文。若 Seed Data 明確要求一個電話而原文沒有出現,後面即使把那段文字遮得再乾淨,也補不回這筆測試案例原本要測的風險。
檢查應盡量放在負責的 Stage 後面。原文沒有通過必要資料檢查,就先別花成本生成遮罩與標註;遮罩洩漏已知電話,則停住這份遮罩結果,不必讓候選標註一起背鍋。上述比對只涵蓋 Seed 已知值和已定義規則,不能因為沒命中就宣稱沒有任何個資。新的格式、別名或未列出的敏感資訊,仍可能漏過規則。
def deterministic_gate(
    must_use: dict[str, str], source_text: str, redacted_text: str
) -> tuple[bool, str]:
    missing = [name for name, value in must_use.items() if value not in source_text]
    if missing:
        return False, f"SOURCE_REQUIRED_VALUE_MISSING:{missing[0]}"

    retained = [name for name, value in must_use.items() if value in redacted_text]
    if retained:
        return False, f"REDACTION_KNOWN_VALUE_RETAINED:{retained[0]}"

    return True, "KNOWN_VALUES_PASS"

must_use = {"phone": "TEST-PHONE-001", "address": "測試路一號"}
source = "客戶要把地址改到測試路一號,電話是 TEST-PHONE-001。"
redacted = "客戶要把地址改到[地址],電話是[電話]。"

# Pass
print(deterministic_gate(must_use, source, redacted))

# Failed、模擬電話不見了
print(deterministic_gate(must_use, "客戶要改到測試路一號。", redacted))

# Failed、模擬遮罩失敗
print(deterministic_gate(must_use, source, redacted + "TEST-PHONE-001"))
有些問題沒有簡單的字串答案。地址遮住後,客服對話還看得出客戶要修改地址、客服確認了什麼嗎?生成的回覆是否順手補上 Seed 沒提供的核准條件?這類語意檢查(Semantic Gate)可以使用有明確準則的 LLM-as-a-Judge,或先交人工審閱;它處理的是規則難以完整表達的判斷,不替代前面的欄位和精確比對。
Judge 的判斷要能回到原文與準則:檢查的是哪一版資料、哪一版評分準則、判斷理由是什麼。尤其「遮罩後還能否完成原任務」涉及程度問題,若理由不足或判斷搖擺,先保留待審狀態比較誠實。先前筆者在 COSCUP 分享中把 Schema、確定性規則與語意判斷分開,也提醒 Judge 需要以人工樣本校準;這裡沿用的是檢查分工,沒有套用一個已校準的分數門檻。
import json
from unittest.mock import Mock

from openai import OpenAI

def semantic_gate(client, source_text: str, redacted_text: str) -> tuple[str, str]:
    response = client.responses.create(
        model="mock-model",
        instructions=(
            "只判斷去識別化後能否辨識地址變更任務。"
            "只回傳 JSON:task_preserved 布林值與 reason 字串。"
        ),
        input=f"原文:{source_text}\n去識別化:{redacted_text}",
    )
    try:
        result = json.loads(response.output_text)
        if not isinstance(result, dict):
            raise ValueError("Judge 回覆不是物件")
        if type(result.get("task_preserved")) is not bool:
            raise ValueError("task_preserved 格式錯誤")
        if not isinstance(result.get("reason"), str) or not result["reason"].strip():
            raise ValueError("缺少判斷理由")
    except (ValueError, TypeError):
        return "QUARANTINE", "JUDGE_OUTPUT_INVALID"
    signal = "JUDGE_SIGNAL_TRUE" if result["task_preserved"] else "JUDGE_SIGNAL_FALSE"
    return signal, result["reason"]

client = Mock(spec=OpenAI)
source = "客戶要把地址改到測試路一號,電話是 TEST-PHONE-001。"
redacted = "客戶要把地址改到[地址],電話是[電話]。"
client.responses.create.return_value.output_text = (
    '{"task_preserved": true, "reason": "仍能辨識地址變更需求"}'
)
print(semantic_gate(client, source, redacted))
client.responses.create.return_value.output_text = (
    '{"task_preserved": false, "reason": "地址變更目的已不明"}'
)
print(semantic_gate(client, source, redacted))
client.responses.create.return_value.output_text = "not json"
print(semantic_gate(client, source, redacted))
只留下「不合格」三個字,隔天還是得重新讀完整筆資料。本文先把每次檢查記成:案例與產物版本、檢查的 Stage、規則或準則版本、通過與否、原因代碼(Reason Code),以及後續處置。這是這組 PII 測資的設計欄位,不是宣稱 NeMo Data Designer 已替我們實作完整的處置流程。
| 檢查時看到的狀況(設計示意) | 原因代碼示例 | 這一版產物的處置 | 下一步 |
|---|---|---|---|
| 原文漏掉 Seed 必要電話 | SOURCE_REQUIRED_VALUE_MISSING |
Reject | 重做原文;已依賴舊原文的產物一併失效 |
| 遮罩後仍有 Seed 中的電話原值 | REDACTION_KNOWN_VALUE_RETAINED |
Reject | 保留原文,只重做遮罩並重新檢查 |
| 候選實體位置對不上原文 | ENTITY_SPAN_MISMATCH |
Reject | 保留原文,只重做標註並重新檢查 |
| 遮罩後是否仍保有任務語意,現有判斷無法確認 | TASK_MEANING_UNCERTAIN |
Quarantine | 暫停進入資料集,待人工或經校準的準則複核 |
今天的文章是我在中斷了鐵人賽、而且確定沒辦法重新開賽的情況下寫的;原本是想要把鐵人賽當成作品來書寫、為主題和教學的性質較多;現在的話會慢慢改成實務開發經驗裡面的一些心得。
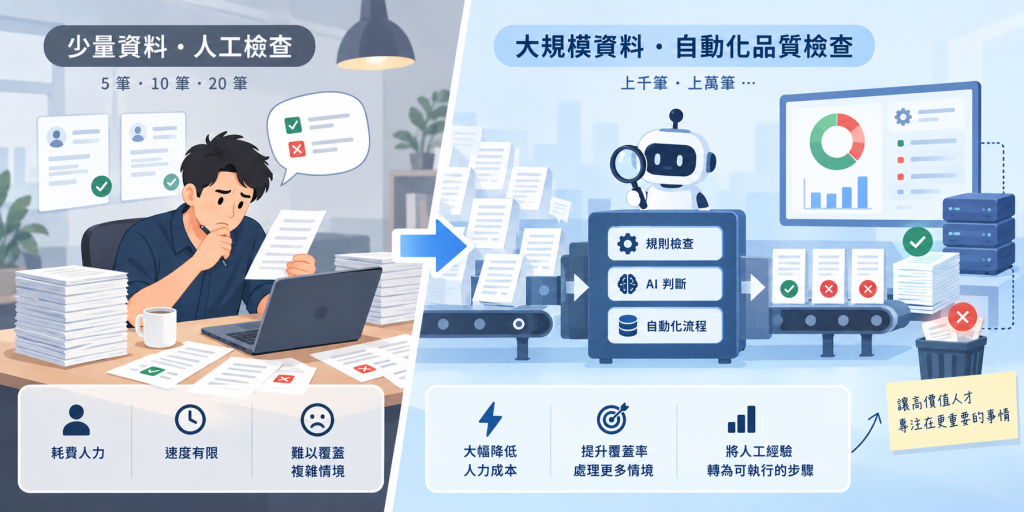
今天的生成資料品質檢查是我認為在資料合成研究裡面最重要的一個章節。原因是在傳統的軟體工程開發裡面,我們很常在測試的時候,都是在測一些零零散散、比較單純的正向案例;當今天測試的量體,或是實務上的運行情況面臨更多不同的狀況時,就如同今天在生成資料的時候,生成 5 筆 10 筆 20 筆人還能花些時間去看;但我們今天在討論資料合成的筆數可能是上千、上萬筆的時候,你要花多少「工人智慧」的人力成本來協助品質檢查?
而企業很在意的一件事情:「能不能把一些不同的人工判斷規則,漸漸變成可被自動化以及被 AI 執行的手段與步驟?」非常多的企業在面臨高價值人力要處理品質控管的事情時,都會求助於筆者、所以在這個地方可謂是非常有實戰經驗(血淚的教訓)。
而在明天,我們將針對從 Day 6 到 Day 10的整個流程進行一次實戰,完整展示生成資料管線的步驟、流程及程式碼,請讀者靜心期待!
2026 COSCUP 分享《A Prompt Is Not All You Need:用開源工具打造 LLM 合成資料管線》內容轉錄


 iThome鐵人賽
 看影片追技術