
按下更新,然後發現新版是壞的。
手抖那一刻腦中只有一個問題:現在服務是不是已經全掛了,要多久才能救回來?
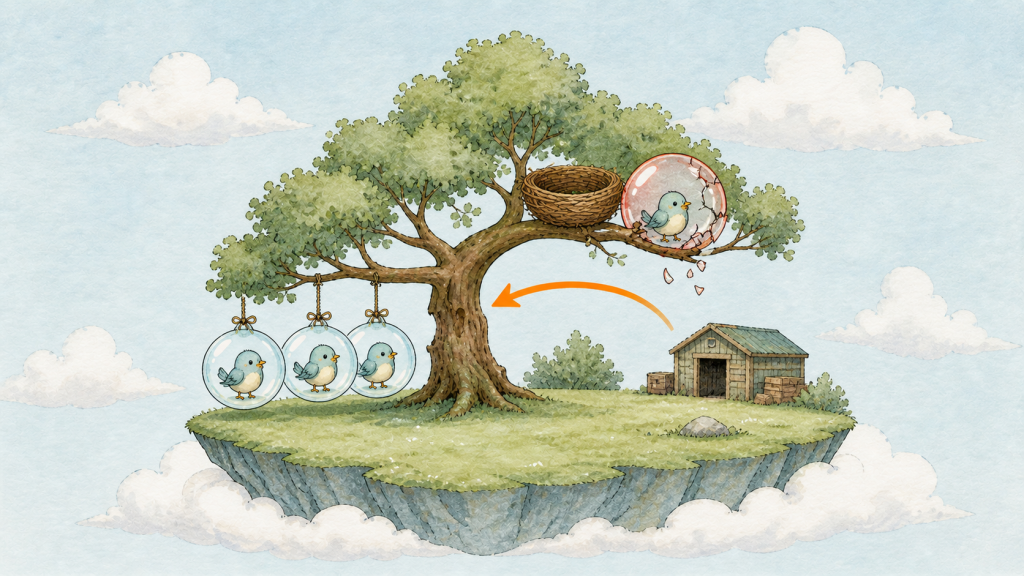
一顆橘色的壞掉泡泡(Pod)卡在樹枝半路上不上不下,旁邊三顆舊版照常運作,一支箭頭從橘泡泡(Pod)指回舊版那一區
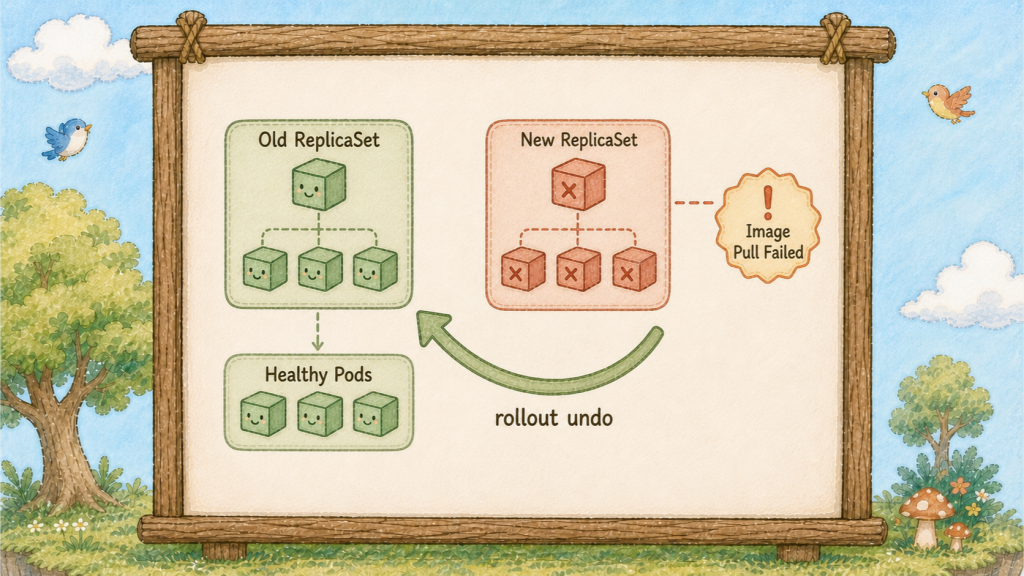
只要舊副本仍健康,且更新策略保留可用副本,壞版本通常會卡在更新階段。
這是昨天那套滾動更新順便送的保護。
回想部署管家(Deployment)的動作:新的加一顆、舊的減一顆、再加一顆、再減一顆。
關鍵在於它不是無腦往下推的,每推一顆就會停下來確認:這顆新泡泡(Pod)真的活起來了嗎?
沒活起來(Pod 沒回報 Ready),部署管家(Deployment)就不往下走,舊版那幾顆一顆都不會收。
今天示範的 image 根本拉不下來,泡泡(Pod)永遠不會 Ready,所以煞車一定踩得住。
但如果新版能啟動、只是一直回 500,又沒有設定小旗子(Readiness Probe),容器一跑起來就算 Ready,部署管家(Deployment)會一路推完,把舊版全部換掉。
小旗子(Readiness Probe)才是這個煞車的感應器,後面的篇章會細講。
所以常見畫面是「一顆橘泡泡(Pod)卡住,其他副本繼續服務」。
圖上那顆橘泡泡(Pod)卡住的地方,就是部署管家(Deployment)的煞車點。
煞車力道由兩個旋鈕決定,在 YAML 裡調:
maxUnavailable 更新過程中,最多可以有幾顆不能服務。
設 0 就是「一顆都不准少」,部署管家(Deployment)只能先吹新的再收舊的。
maxSurge 更新過程中,最多可以多出幾顆。
設 1 就是「總數最多比你要的多一顆」,也就是一次只搬一顆。
兩個都可以填數字或百分比,預設都是 25%。
百分比換算成顆數時,maxSurge 無條件進位、maxUnavailable 無條件捨去。
3 顆副本的 25% 是 0.75,所以 maxSurge 算成 1、maxUnavailable 算成 0,預設值剛好等於「先加一顆、一顆都不准少」,這就是今天的示範能卡住的原因。
換成 4 顆副本,maxUnavailable 會變成 1,部署管家(Deployment)一開始就會先收掉一顆舊的。
只要記住這句:maxUnavailable 決定你敢掉多少,maxSurge 決定你願意多付多少資源換速度
部署管家(Deployment)身上有那卷版本卷軸(Revision)。卷軸上一行一個版本,每一行對應昨天講的一隻貓頭鷹(ReplicaSet),舊貓頭鷹(ReplicaSet)沒被刪掉,只是數字停在 0(預設最多留 10 隻,由 revisionHistoryLimit 決定)。
所謂 rollback,就是叫部署管家(Deployment)把舊的那一行抄一份到卷軸(Revision)最下面,當成最新版,然後把兩隻貓頭鷹(ReplicaSet)的數字對調回去。
所以 undo 之後,舊版會拿到一個新的行號,原本的行號會從卷軸上消失(1、2、3 undo 後變成 1、3、4)。
所以回滾通常不需要重新查舊版 tag,也不需要翻 git
但如果執行回滾的 Node 沒有舊 image 快取,仍可能重新從 registry 拉取;image 已不存在或 registry 不可用時,回滾也會失敗。
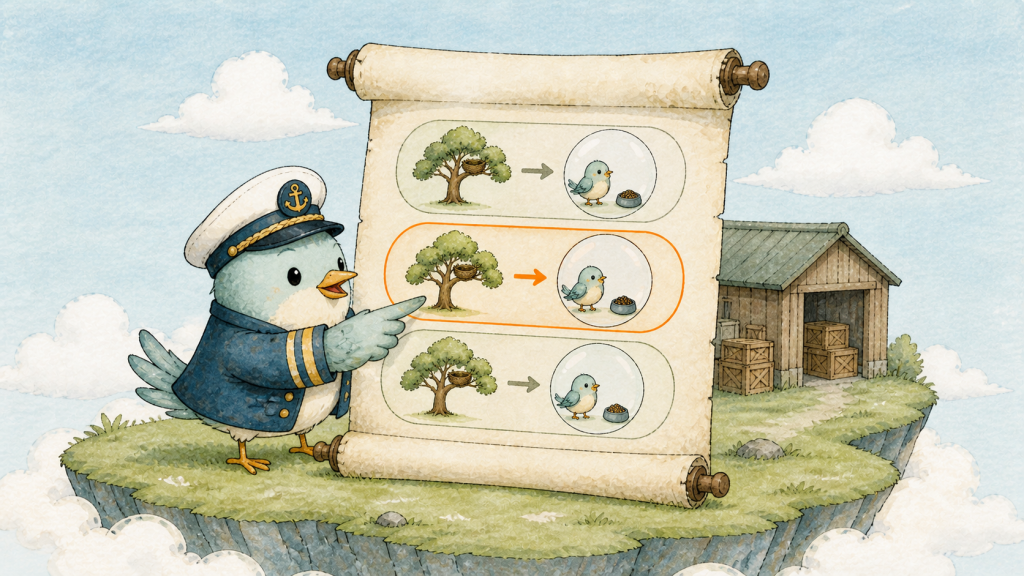
部署管家(Deployment)手上的版本卷軸(Revision)攤開,由上而下列著三行版本紀錄,其中一行被手指按住
最後提醒一件事:卷軸(Revision)只記得「泡泡 Pod 長什麼樣子」,不記得「有幾顆」
改 image 會產生新的一行紀錄,改 replicas 不會。這是很多人第一次用 rollout history 會困惑的地方。
昨天我們有一個叫 hello 的部署管家(Deployment),手下三顆 nginx:1.27-alpine 的泡泡(Pod)。今天故意把它更新壞,再救回來。
先看看卷軸(Revision)現在有幾行:
kubectl rollout history deployment/hello
你會看到 REVISION 1 和 2(1 是最初的 1.25,2 是昨天改的 1.27),CHANGE-CAUSE 那欄是 <none>。
CHANGE-CAUSE 是可以自己寫的,寫了之後卷軸(Revision)才看得懂:
kubectl annotate deployment/hello kubernetes.io/change-cause="upgrade to nginx 1.27" --overwrite
kubectl rollout history deployment/hello
現在最新那一行有說明了。養成這個習慣,三個月後回頭看你會感謝自己。
現在做壞事,更新到一個根本不存在的 image:
kubectl set image deployment/hello hello=nginx:9.99-does-not-exist
kubectl annotate deployment/hello kubernetes.io/change-cause="try broken image" --overwrite
第二行別省略:change-cause 寫在部署管家(Deployment)身上,不重寫的話,新的這一行會沿用上一句「upgrade to nginx 1.27」,卷軸(Revision)就會記錯。
立刻看發生什麼事:
kubectl get pods
你會看到四顆泡泡(Pod):三顆舊的還是 Running,多出來一顆新的是 ErrImagePull 或 ImagePullBackOff。
可以看下圖那顆橘字泡泡(Pod) ── 它卡住了,但部署管家(Deployment)沒有動舊的那三顆。
問部署管家(Deployment)進度:
kubectl rollout status deployment/hello --timeout=30s
畫面停在 Waiting for deployment "hello" rollout to finish: 1 out of 3 new replicas have been updated...,三十秒後 timeout 退出。卡住,但沒有崩潰。
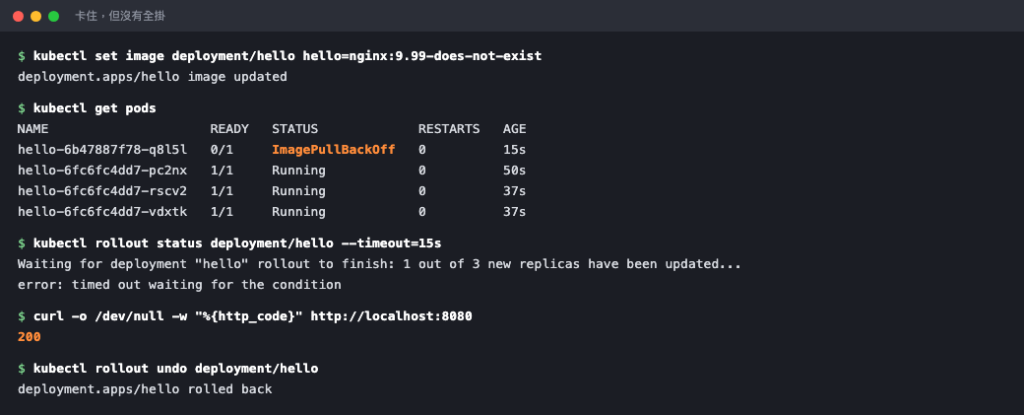
壞版本卡在 ImagePullBackOff,但同一時間 curl 拿到的是 200 ── 使用者什麼都沒感覺到。
現在做今天最重要的驗證 ── 服務到底還活著沒有:
這次走 Service,跟真實使用者的路徑一樣。還沒有 Service 的話先建一個(已經有了會回報 AlreadyExists,略過即可):
kubectl expose deployment hello --port=80
kubectl port-forward svc/hello 8080:80
打開 http://localhost:8080,Nginx 的 Welcome 頁照常出現。橘泡泡(Pod)沒有 Ready,Service 不會把流量分給它,請求全部落在舊的三顆上。剛剛推了一個完全壞掉的版本上去,在這個設定與舊副本仍健康的前提下,使用者通常不會感覺到。Ctrl+C 離開。
看部署管家(Deployment)怎麼說:
kubectl describe deployment hello | grep -A4 Conditions
Progressing 那行會是 ReplicaSetUpdated;超過 progressDeadlineSeconds(預設 600 秒,也就是 10 分鐘)還推不動,就會變成 False 加上 ProgressDeadlineExceeded ── 部署管家(Deployment)在回報「我推不動」。
它只負責回報,不會自動回滾,要由你(或 CI/CD)接手執行 undo。
救回來,一行:
kubectl rollout undo deployment/hello
kubectl rollout status deployment/hello
這次很快就印出 deployment "hello" successfully rolled out。
確認現場:
kubectl get pods
kubectl get deploy hello -o jsonpath='{.spec.template.spec.containers[0].image}{"\n"}'
橘泡泡(Pod)不見了,三顆 Running,image 回到 nginx:1.27-alpine。
如果要回到更早的版本,先看卷軸(Revision)再指定行號:
kubectl rollout history deployment/hello
kubectl rollout undo deployment/hello --to-revision=1
這會回到最初的 1.25。行號請以你當下 rollout history 看到的為準,剛剛 undo 過一次,行號已經重新排過。
再執行一次 kubectl rollout undo deployment/hello 就能回到 1.27,卷軸(Revision)是可以來回捲的。
最後把煞車旋鈕(Deployment 策略)設成最保守的樣子。編輯 hello-deployment.yaml,在 spec.replicas 下面加這段:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
同一個檔案裡,順便確認 image 是 nginx:1.27-alpine,跟島上現況一致。這步要在 apply 之前做,否則 apply 會先把島上改回檔案裡的舊版本,平白多滾一次。
套用後,更新到一個真的存在的新版本,觀察新策略怎麼搬:
kubectl apply -f hello-deployment.yaml
kubectl set image deployment/hello hello=nginx:1.28-alpine
kubectl get pods -w
你會看到新泡泡(Pod)先出現、變成 Running 之後,才有一顆舊的進入 Terminating;總數最多 4 顆,可用的始終維持 3 顆。Ctrl+C 離開。
maxUnavailable: 0 會要求更新期間不可少於期望的可用副本數;實際能否維持服務,仍取決於舊副本、Readiness 和節點資源。代價是更新會慢一點、過程中會多佔一顆泡泡(Pod)的資源。
更新完記得把檔案裡的 image 改成 nginx:1.28-alpine 再存進 git,別讓檔案跟島上打架。
今天做到的是服務不中斷:任何時刻都有健康的泡泡(Pod)在服務,使用者重新整理永遠有東西。多數情境講的零停機部署,指的是這一層。
還有更嚴格的一層叫無損更新:連正在處理中的請求都不失敗。
舊泡泡(Pod)被收掉的那一刻,如果流量路由規則還來不及更新,新請求可能還會被送到已經死掉的 Pod 上,這中間有一個很短的空窗期。
要補滿空窗需要三塊拼圖:
① 小旗子(Readiness Probe):新泡泡(Pod)真的能接客才舉旗,Service 才會把流量分過去。
② 離場緩衝:用 preStop 先等幾秒,讓 Service 把舊泡泡(Pod)從名單摘掉;terminationGracePeriodSeconds 要設得比這段等待更長。
③ 優雅關機:應用程式收到 SIGTERM 後,先把手上的請求處理完再退出。
另外 minReadySeconds 可以要求新泡泡(Pod)穩定 Ready 幾秒才算數,擋掉「一起來就倒」的版本。
Deployment 策略保留健康舊副本、新版又過不了 Readiness 時,壞版本會卡在半路,等你執行 rollout undo 回滾。


 iThome鐵人賽
 看影片追技術