
在大型語言模型的發展歷程中,「上下文視窗(Context Window)」的大小直接決定了 AI 能吞下多少資訊。過去的模型受限於數千到數萬 Token,面對一本財報或學術論文往往必須切片(Chunking)、建立複雜的 RAG(檢索增強生成)架構。而 Gemini 最具破壞力的技術突破,就是將原生長上下文推升到了百萬級別。
今天我們要在 Google AI Studio 裡,直接用平板上傳一份幾十頁的完整 PDF 報告,實測 Gemini 在海量文字下的深度理解與跨章節整合能力。
長文本的核心優勢:告別破碎的切片檢索
平板實測情境:企業永續報告書(ESG)或年報穿透式分析
找一份公開的企業永續報告書、科技年報或學術論文 PDF(約 30~60 頁,檔案格式為 .pdf)。
我這邊找了一份統一企業永續報告書做測試
操作步驟
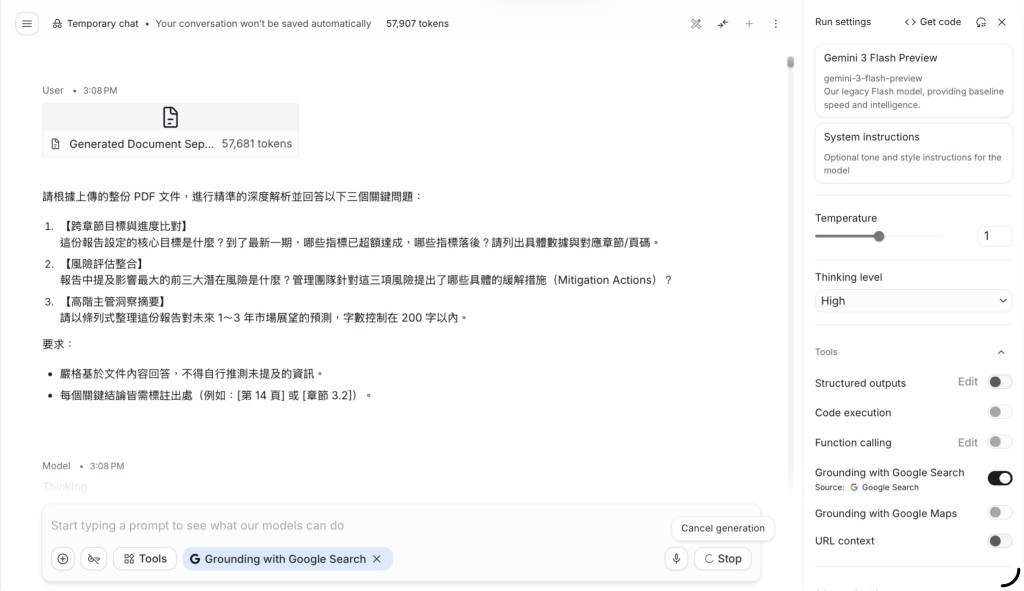
測試 Prompt 設計(考驗跨章節整合)
不要問單純的「請總結這份報告」,而是設計一組考驗「橫向比對」與「因果歸納」的指令:
請根據上傳的整份 PDF 文件,進行精準的深度解析並回答以下三個關鍵問題:
【跨章節目標與進度比對】
這份報告設定的核心目標是什麼?到了最新一期,哪些指標已超額達成,哪些指標落後?請列出具體數據與對應章節/頁碼。
【風險評估整合】
報告中提及影響最大的前三大潛在風險是什麼?管理團隊針對這三項風險提出了哪些具體的緩解措施(Mitigation Actions)?
【高階主管洞察摘要】
請以條列式整理這份報告對未來 1~3 年市場展望的預測,字數控制在 200 字以內。
要求:
實作結果: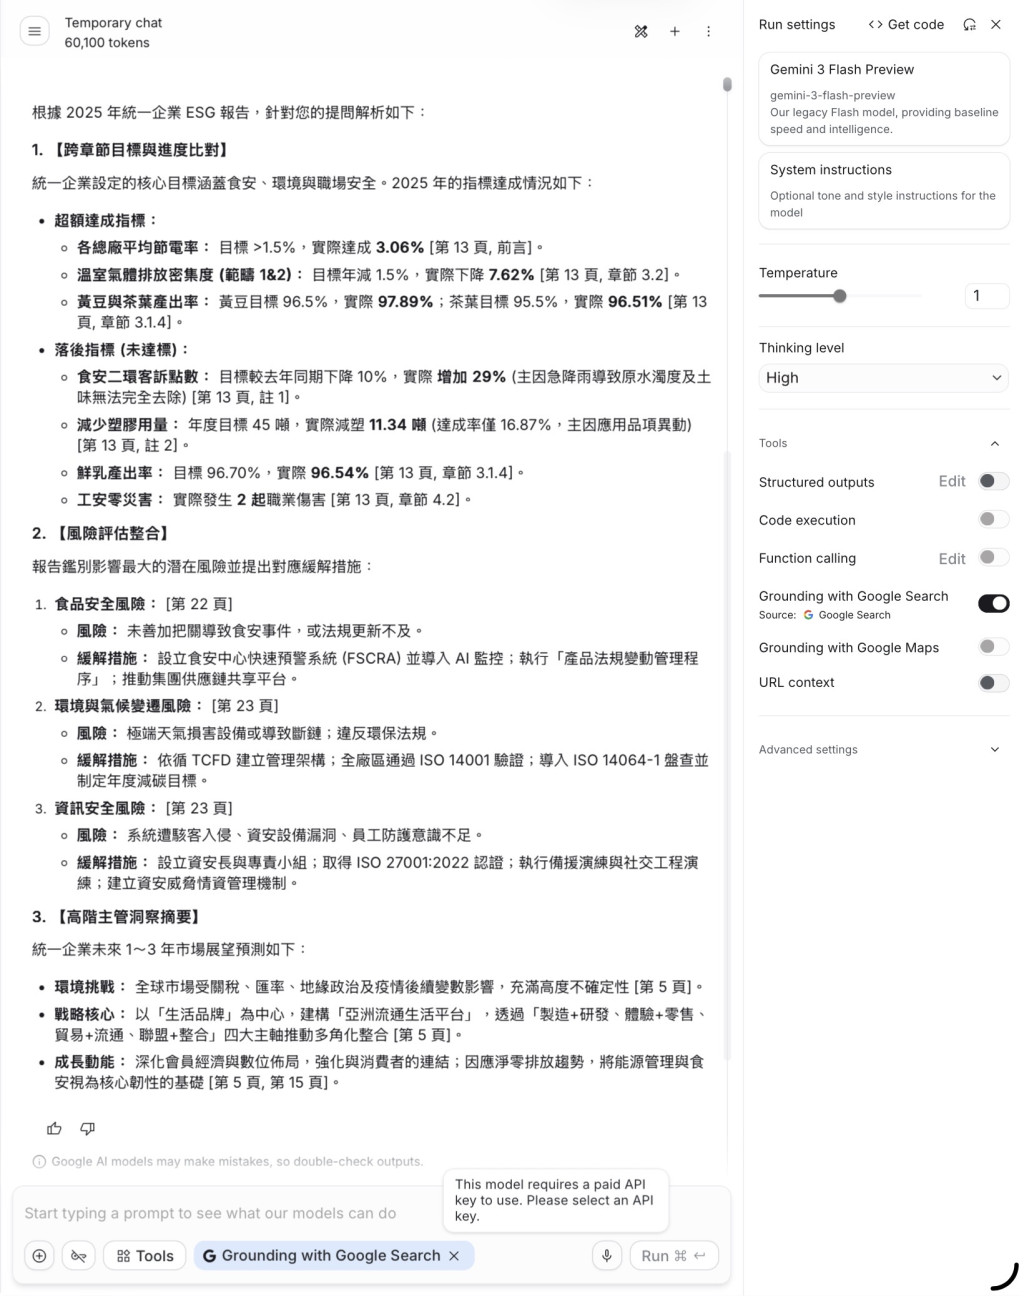
今日結語建議
長上下文技術徹底改寫了非結構化文件的處理範式。過去需要耗費數天搭建檢索系統、微調切片參數的繁瑣流程,如今在 Google AI Studio 裡只需「點擊上傳、下達 Prompt」兩步即可完成。無論是數十頁的商業財報、學術論文還是產品規格書,Gemini 都能在幾秒鐘內建立全局理解,成為你平板上最強大的個人智庫。


 iThome鐵人賽
 看影片追技術