iT邦幫忙

2026 iThome 鐵人賽

DAY 16
0
自我挑戰組

從 Google AI Studio 玩轉提示工程的 30 天實戰修煉系列 第 16 篇

Day 16:視覺辨識實測:拍下手寫筆記與發票,打造精準 OCR 提示詞

  • 分享至 

  • xImage
  •  

在多模態的日常與商業落地中,最常見且剛需的情境就是 光學字元辨識(OCR, Optical Character Recognition)。傳統 OCR 工具常受限於字體潦草、光線陰影、摺痕或繁雜排版,且辨識出來的通常是一長串缺乏語意的雜亂純文字,後續仍需大量人工整理。
今天我們要在 Google AI Studio 中,用平板直接拍照或上傳真實生活中的兩大硬核場景——「手寫會議筆記」 或 「超商/餐飲電子發票」,實測如何運用專屬的 OCR 提示詞技巧,讓 Gemini 不只「辨識文字」,還能「自動校正語意」並「輸出結構化資料」。

為什麼大模型多模態 OCR 遠勝傳統 OCR?

  1. 具備常識校錯能力(Semantic Correction):傳統 OCR 遇到字跡模糊時只會照字元硬猜(例如把「發票」看成「發栗」);而多模態大模型具備上下文語意理解,能依據前後詞彙自動修正連筆手寫字。
  2. 版面佈局理解(Spatial Layout Parsing):發票通常分為抬頭、表格明細、合計金額、條碼編號等不同區塊。多模態模型能識別空間相對位置,精準萃取「品項」與對應的「單價」,不會錯位。
  3. 一步到位結構化:傳統 OCR 需要先辨識文字 ➡️ 寫 Regular Expression 正則表達式抽取,➡️存入資料庫;Gemini 搭配提示詞可以直接跳過中間步驟,直接吐出乾淨的 JSON。

設計 OCR 提示詞時,切忌只寫「幫我辨識圖中文字」,請套用以下五步架構:

  1. 圖像前置定義:明確指出上傳文件類型(如:台灣統一發票收執聯、手寫會議筆記)。
  2. 辨識路徑指引:規定由上至下、由左至右,或先標題後明細。
  3. 模糊與缺字處理原則:遇到折痕或反光無法辨識時,使用 ⁠[模糊]⁠ 或 ⁠null⁠ 標記,禁止胡亂腦補。
  4. 型別轉換規範:數字、日期需轉為標準格式(如 ⁠YYYY-MM-DD⁠,金額去除千分位逗號轉純數字)。
  5. 指定交付格式:嚴格鎖定以 Markdown 表格或純 JSON 輸出。

實測設計:便利商店電子發票結構化辨識
本實驗使用一張真實拍攝的「7-ELEVEN 電子發票證明聯」作為測試樣本。發票含有傳統 OCR 容易產生判讀錯誤的要素:粗黑標題、時間戳記、隨機碼、賣方統編,以及底部細小的門市代號與機台資訊。
測試目標
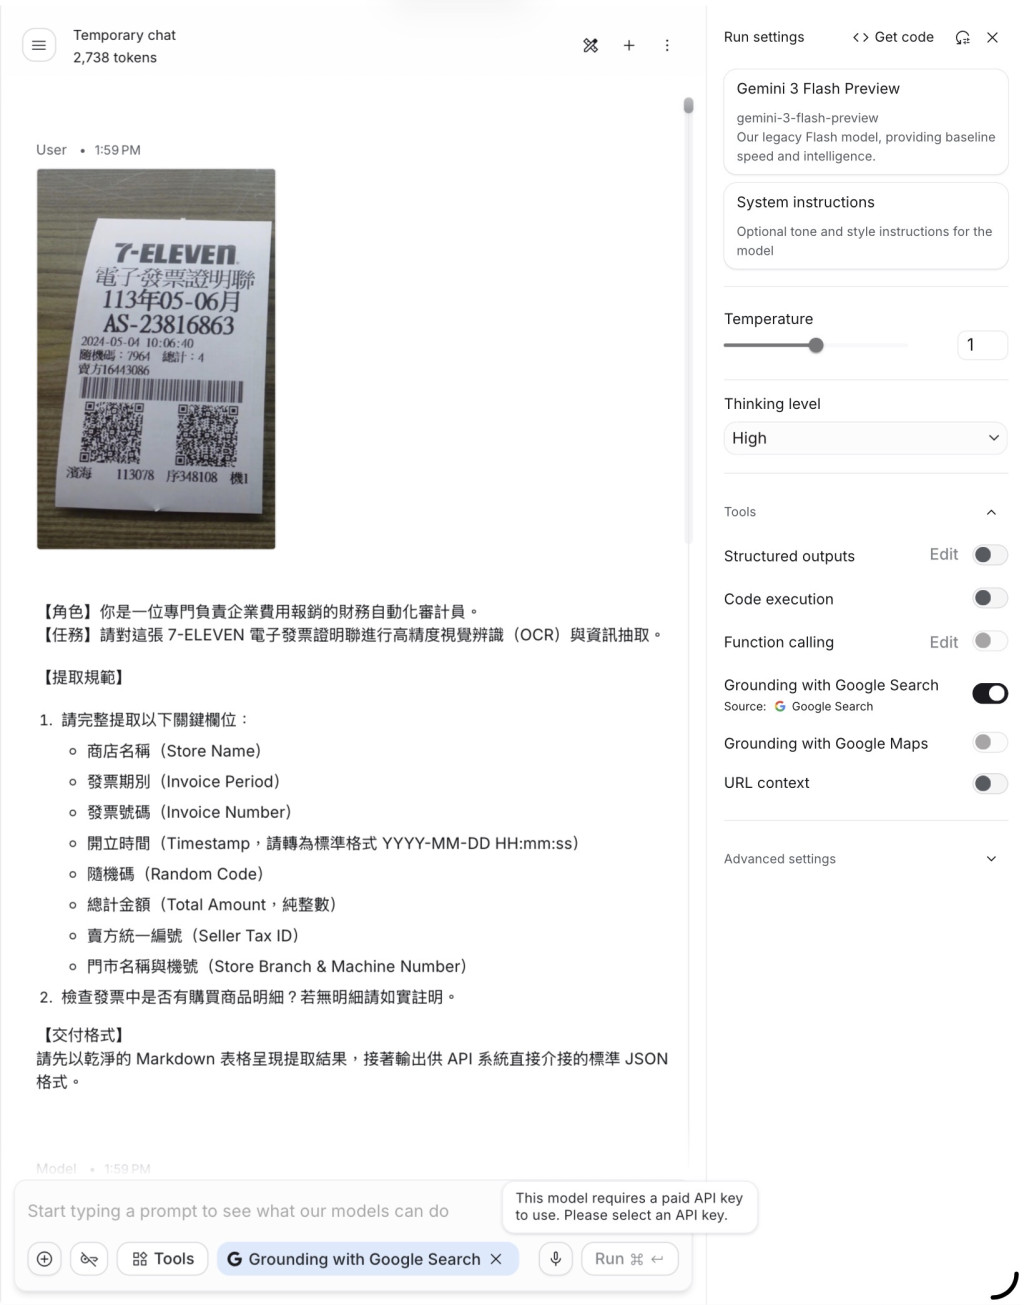
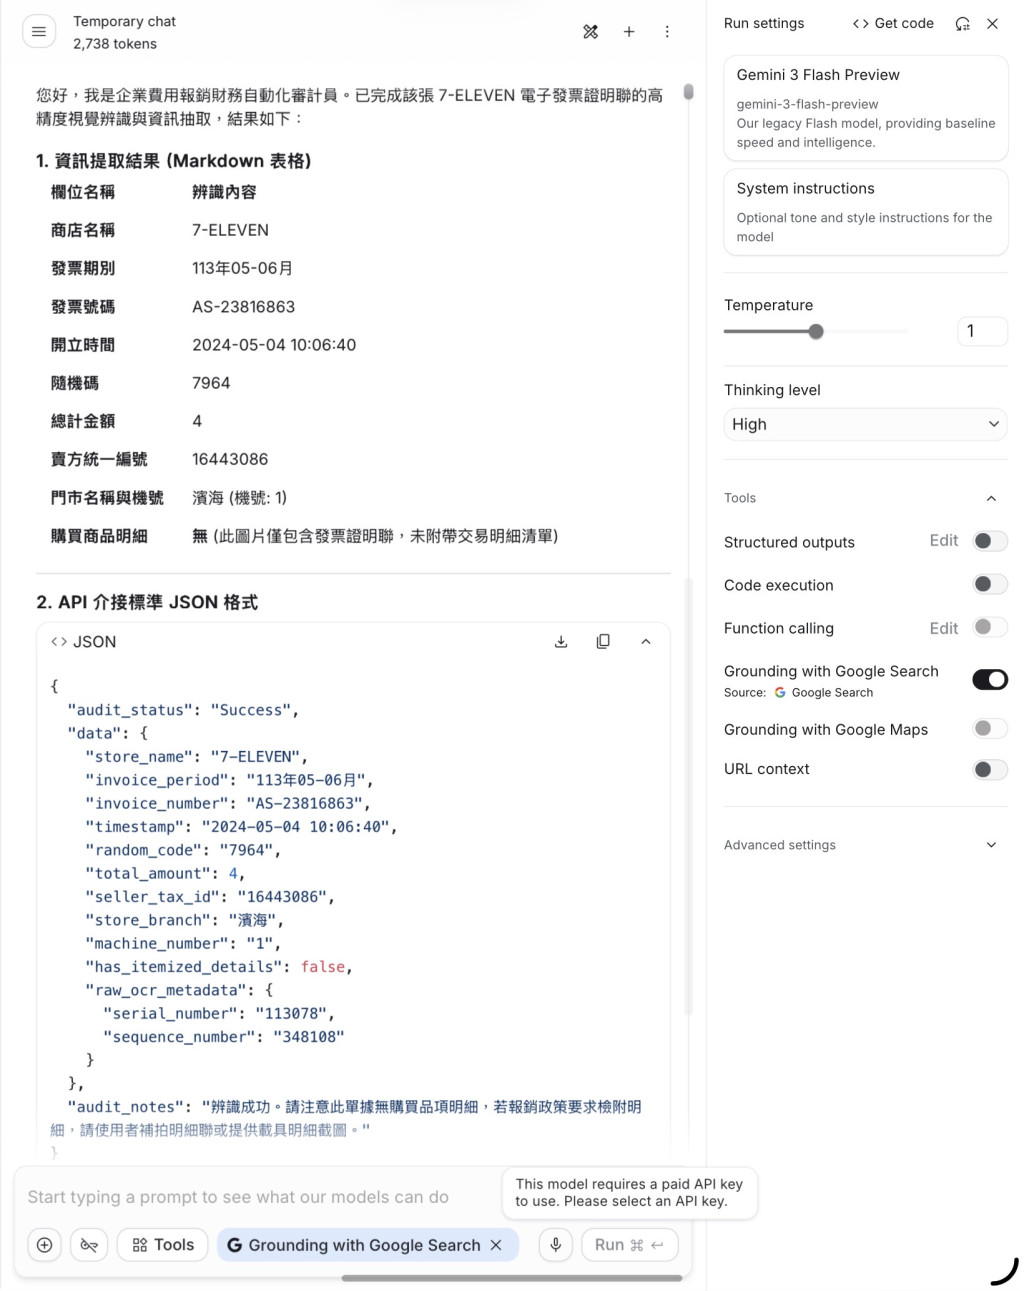
  1. 關鍵欄位精確抽取:驗證模型是否能無誤辨識數字、英數混合字串(如發票字軌 ⁠AS-23816863⁠、隨機碼 ⁠7964⁠、統編 ⁠16443086⁠)。
  2. 邊界情況自主判讀:此證明聯本身並未印出消費商品明細(明細通常在副聯或需掃描 QR Code),測試模型是否能誠實回報「無明細」,而非胡亂捏造品項。
  3. 雙重格式交付:要求模型同時輸出易於人類閱讀的「Markdown 整理表格」與適合後端自動化系統介接的「標準 JSON 格式」。
    https://ithelp.ithome.com.tw/upload/images/20260930/20178834q8QMQw278O.jpghttps://ithelp.ithome.com.tw/upload/images/20260930/20178834TRNSFwICvq.jpg

今日結語
在平板上隨手拍下一張發票或手寫筆記,無需任何繁瑣的預處理影像代碼,僅靠一段規格嚴謹的提示詞,就能在幾秒內完成「視覺解析➡️語意校正➡️結構化數據落庫」的全流程。這不僅是技術的革新,更是打造無紙化、自動化辦公流程的最強利器!


上一篇
Day 15:多模態啟航:上傳圖片給 AI,怎麼下提示詞最精準?
下一篇
Day 17:複雜圖表解讀:讓 AI 分析長條圖、圓餅圖並產出商業洞察
系列文
從 Google AI Studio 玩轉提示工程的 30 天實戰修煉 共 19 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言