
RAG 全名是 Retrieval-Augmented Generation,中文常翻成「檢索增強生成」。名字聽起來有點學術,但概念其實很簡單:
讓 AI 回答問題之前,先去查資料,再根據查到的資料回答,而不是憑空亂答。
你可以把一般的 LLM 想成一個「憑記憶考試」的學生,只能靠訓練時記住的東西作答,遇到訓練資料沒涵蓋到的內容(比如公司內部的產品規格、上個月才更新的政策),它要嘛答不出來,要嘛就開始「掰」,也就是常聽到的幻覺(hallucination)。
RAG 要做的事,就是讓這個學生變成「翻書考試」:先讓它去翻資料(Retrieval,檢索),找到跟題目相關的段落,再把這些段落連同題目一起交給它,讓它照著資料生成答案(Generation,生成)。這樣一來,答案有憑有據,也比較好更新。資料庫換了新資料,AI 馬上就能查到最新版本,不需要重新訓練模型。
基本流程濃縮成一句話:
查資料 → 把查到的東西塞進提示詞 → 讓 LLM 根據這些資料生成回答
聽起來簡單,但魔鬼藏在細節裡,資料要怎麼存、怎麼切、怎麼查得準、查到多筆結果要怎麼判斷取捨,這些都是接下來要慢慢拆的東西。
這裡從「為什麼要這樣設計」著手,先不碰細節,把整個產品知識庫 RAG 的骨架攤開來看清楚:
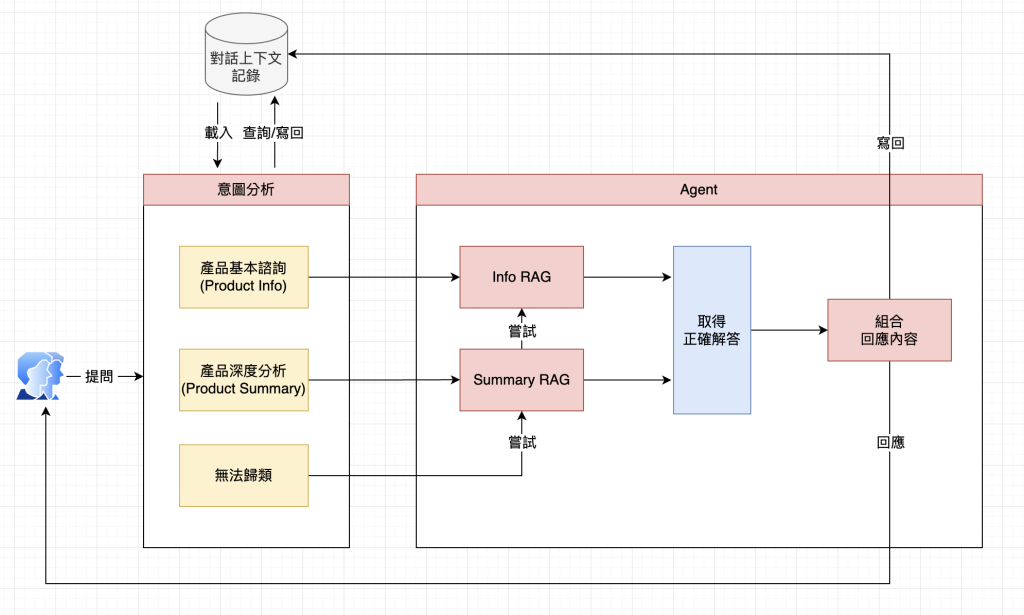
主要有四塊模組:
接下來一塊一塊拆解。
使用者丟問題進來之後,系統不會馬上衝去 RAG 查資料,而是先經過「意圖分析」這一關。
這其實是整張圖裡最關鍵的一個決定:不是所有問題都用同一套方式去查。 想像一下如果不分流,什麼問題都丟進同一個知識庫、用同一種查法,很容易查出一堆牛頭不對馬嘴的結果——明明問規格,卻撈到一堆長篇分析文,反之亦然,準確度就是這樣被拖垮的。
所以這裡先幫問題貼標籤,分成三種:
產品基本諮詢(Product Info):偏事實型的問題,比如規格。
產品深度分析(Product Summary):偏分析、比較、總結型的問題,比如「這產品適合什麼樣的人用」。
無法歸類:分類器自己也不確定的時候,會掉到這一個分支,後面會講這個分支怎麼被救回來。
意圖分析這邊會跟「對話上下文記錄」互動,主要兩件事:
載入: 把之前聊過的內容拉進來,讓判斷意圖時可以參考上下文。不然使用者接著問「那它的保固呢」,系統根本不知道「它」是誰。
查詢/寫回: 意圖分析自己也可能去查或更新這份記錄,維持整個對話狀態的一致性。
意圖分析分完類之後,問題就進到 Agent 這一塊,這裡是整個系統真正在幹活的地方。
你可能會想,為什麼不乾脆共用一個 RAG 就好,幹嘛分兩條?因為這兩種知識庫裡放的資料型態本來就不一樣,一邊是原始的事實資料,一邊是已經被整理、分析過的內容。資料型態不同,代表切法(chunk 怎麼切)、Embedding 怎麼做、甚至查詢演算法的最佳設定都可能不一樣。
這張圖有個小細節蠻值得注意的:當問題被判成「無法歸類」時,系統並不是直接兩手一攤回一句「我不懂」,而是同時往 Info RAG 跟 Summary RAG 各發一次「嘗試」查詢,看哪邊能撈到有用的東西。
這種做法叫「優雅降級」(graceful degradation),概念很簡單:分類不確定,不代表系統就沒招了,退一步用比較寬鬆的方式再試一次,總比直接放棄、讓使用者收到空白答案好。
Info RAG 或 Summary RAG 查完之後,結果會匯到「取得正確解答」這個節點,它要解決的問題是:兩邊都可能有結果,但到底哪個才是使用者真正想要的答案?
實作上通常會用這幾招(或混著用):
這一步其實是整個雙路架構能不能穩的關鍵,後面「持續優化」那篇會花不少篇幅講這個,畢竟雙路查詢最怕的就是兩邊都查到東西,但答案彼此打架。
挑出正確答案之後,最後交給「組合回應內容」把它包裝成要回給使用者的內容,可能還會做一些格式化、補上資料來源之類的收尾。
最後結果會分兩路走:
回應: 直接回給使用者。
寫回: 把這一輪的問答存回「對話上下文記錄」,這樣下一輪使用者再問問題時,「意圖分析」就能載入到最新的上下文,整個對話才會一輪一輪接得起來。


 iThome鐵人賽
 看影片追技術