
前面幾篇我們拆過「意圖分析」、也拆過「RAG Agent」,這篇要做的事情,是把這些零件全部組裝起來,變成一個真正能上線的地端 AI 產品知識庫。
如果 RAG 設計只是「把問題向量化 → 查資料庫 → 丟給 LLM」這三步,那大概只能撐過 demo 階段。真實情境裡使用者會打很口語的話、會接著上一句繼續問、會問到非結構化資料(像是商品優缺點、使用情境等),還會不小心問到你根本沒建索引的東西。所以這套「完整落地」的架構,其實也是在試圖解套這些「demo 版本會爆炸」的地方。
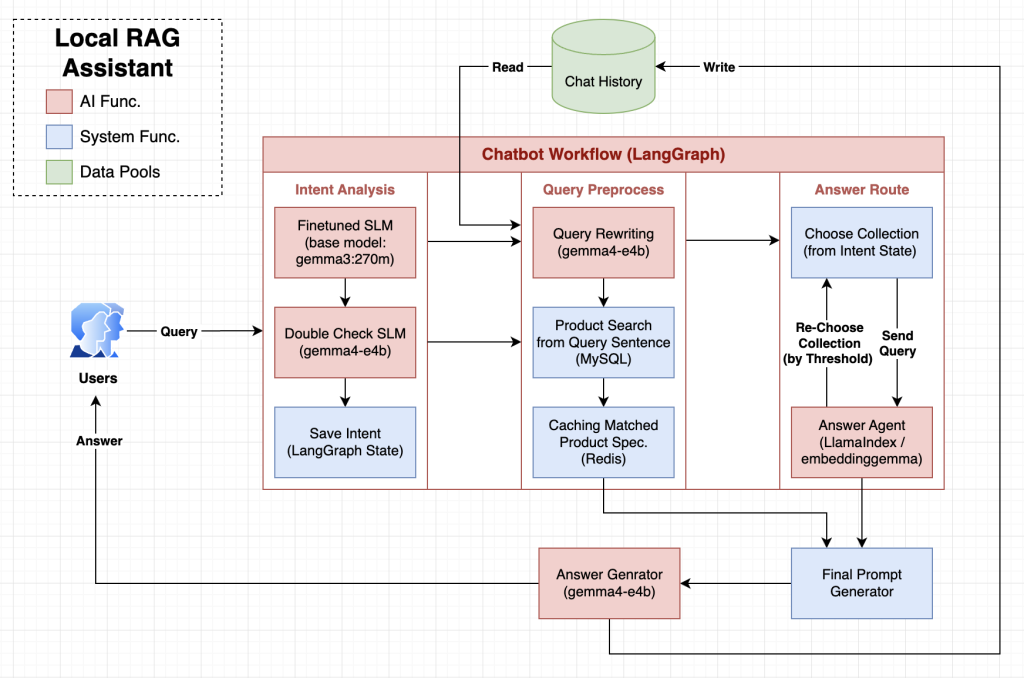
用最簡單的話講一次流程:
- 使用者發問
- 意圖分析(這句話到底想幹嘛)
- 查詢前處理(把話講清楚、順便查一下有沒有對到具體商品)
- 答案路由(依照意圖去對的知識庫檢索)
- 組 Prompt(把查到的東西全部兜在一起)
- 產生答案
- 回覆使用者,同時把這輪對話記下來,留給下一輪用
整條流程用 LangGraph 串起來,每個步驟都是一個 node,中間的資料(像是判斷出來的意圖)可以存在 state 裡,後面的 node 隨時拿得到,不用每個步驟都重新問一次使用者。
接下來就照架構圖從左到右,一段一段拆解。
Intent Analysis:先搞懂使用者到底想幹嘛這是整條流程的第一站,也是最容易被忽略、但其實最關鍵的一步 — 你得先知道使用者想幹嘛,才知道等一下要去哪裡找答案。
架構圖裡這一段有三個方塊:
Finetuned SLM(base model:gemma3:270m):用一個微調過的超小模型,快速把使用者的話分類成幾種意圖(問商品規格?問退換貨政策?單純聊天?)。選用 270m 這種小模型的原因很直白 — 它要跑在地端,又要快,不能每句話都動用大模型。
Double Check SLM(gemma4:e4b):小模型雖然快,但難免會誤判,所以再用一個稍微大一點的模型在沒過門檻時複查一次。這其實是一種「先用小模型分流、有需要再用中模型把關」的取捨,拿一點點延遲去換判斷的準確度。
Save Intent(LangGraph State):把最後確認過的意圖存進 LangGraph 的 state,後面不管是「查詢前處理」還是「答案路由」都可以直接讀,不用重複判斷。
💡 小重點:為什麼不乾脆全部都用大模型判斷就好?因為意圖分類本質上是個相對單純的分類任務,小模型其實就能處理七八成的情況,把大模型留給真正需要推理能力的地方(像是生成答案),才是地端資源有限時比較划算的分工方式。
Chat History:貫穿全場的「記憶體」圖正上方的 Chat History,它不屬於任何一個階段,而是整條流程都會互動的資料池,做兩件事:
Read(讀):在「查詢前處理」要改寫使用者問題的時候,會回頭去讀之前的對話紀錄。舉例來說,使用者這句話問「那它多少錢」,如果沒有上下文,系統根本不知道「它」是指哪個商品——這時候就得靠 Chat History 幫忙補上下文。
Write(寫):等到最後 Answer Generator 把答案生出來之後,會把這一輪的問答寫回 Chat History,留給下一輪繼續用。
這一來一回,才讓整個對話「有記憶」,而不是每句話都當成獨立的新對話在處理。
Query Preprocess:把話講清楚,順便看看有沒有對到具體商品拿到意圖之後,還不能直接拿使用者原話去檢索,因為使用者講話通常很口語、很省略。這一段做三件事:
Query Rewriting(gemma4:e4b):把原始問題,搭配 Chat History 的上下文,改寫成一句「講清楚、可以拿去檢索」的完整句子。這步其實對後面檢索品質的影響非常大 — 查詢句寫得好不好,直接決定你查不查得到對的內容。
Product Search from Query Sentence(MySQL):拿改寫後的句子,去結構化的 MySQL 商品資料庫比對,看看有沒有精確對應到的商品名稱、型號、SKU 之類的東西。這一步跟向量檢索是分開的,因為商品規格這種結構化資料,直接查資料庫會比向量相似度檢索更準。
Caching Matched Product Spec(Redis):把比對到的商品規格快取進 Redis。這樣同一個商品被反覆問到的時候,不用每次都重新查一次資料庫,回應速度會快很多。
💡 核心概念:不是所有知識都適合丟進向量資料庫。結構化、常變動的資料(像價格、庫存),用傳統資料庫查反而更準更快,向量檢索留給非結構化的知識內容(像使用手冊、FAQ)。
Answer Route:去對的地方找答案,找不到就換一個地方找這是整個架構設計得比較細膩的一段,重點在於:不是每次都查同一個知識庫。
Choose Collection(from Intent State):根據前面存下來的意圖,決定要去向量資料庫裡的哪個 collection 查。問退換貨政策就查 FAQ 那個 collection,問商品規格就查說明書 collection,而不是一股腦全部混在一起查。
Send Query → Answer Agent(LlamaIndex / embeddinggemma):把處理好的查詢句送進用 LlamaIndex 架起來的 RAG Agent,搭配 embeddinggemma 做向量化跟相似度檢索,把最相關的知識片段撈出來。
Re-Choose Collection(by Threshold):如果 Answer Agent 撈回來的相似度分數低於設定的門檻值(threshold),就代表很可能一開始選錯 collection 了,這時候會觸發回饋迴路,回頭重新選一個 collection 再查一次。
這個「查不到就換地方查」的設計,其實是在補「意圖分析可能判斷錯」這件事的後路——與其讓整套系統一條路走到黑,不如留一個容錯機制。
最後這一段,是把前面兩條支線的成果匯合在一起:
Final Prompt Generator:把「查詢前處理快取到的商品規格」加上「Answer Agent 檢索到的知識片段」,再加上使用者的問題跟必要的上下文,組成最終要丟給 LLM 的 prompt。
Answer Generator(gemma4:e4b):拿這個組好的 prompt,生成真正要回給使用者的答案。
答案產生之後兵分兩路:一路回傳給使用者,另一路寫回 Chat History,讓下一輪對話可以延續上下文——整條流程到這裡形成一個完整的閉環。
以下為實際運作的系統 demo: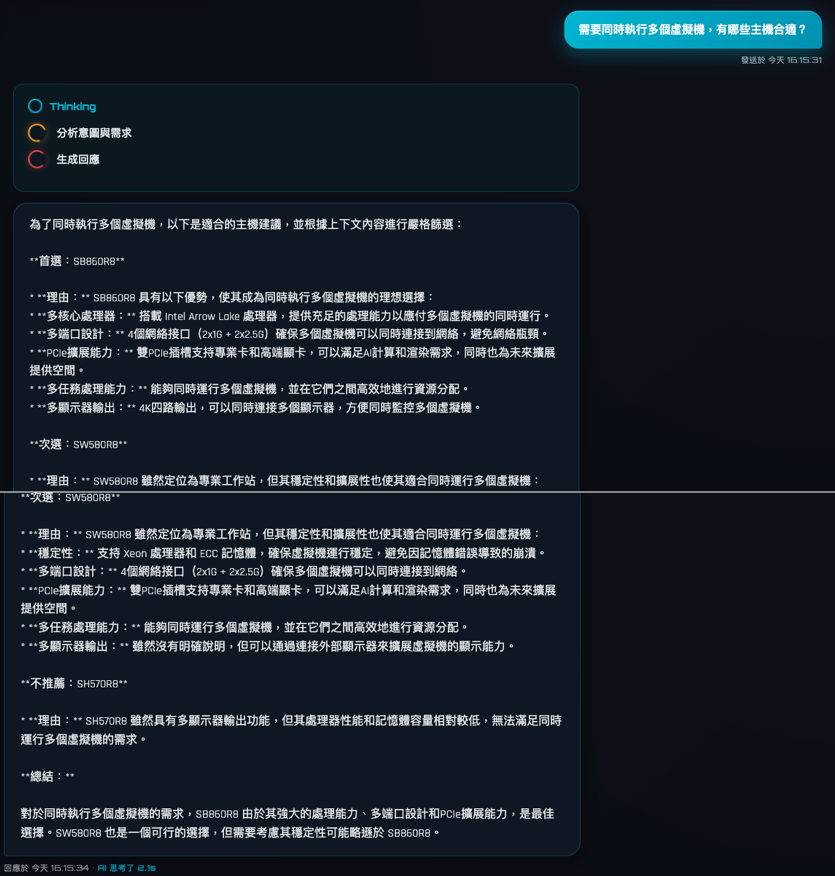
回頭看整個落地架構,會發現一個很明顯的設計哲學:能用小模型解決的,不動用大模型;能查資料庫解決的,不硬塞進向量檢索。
gemma3:270m 這顆客製化的小模型負責意圖分類、gemma4:e4b 負責複查、改寫、生成這些比較需要語言能力的工作、embeddinggemma 專門做向量化 — 每個模型都只做自己最擅長、成本最低的那件事。這也是「地端 AI」在資源有限的情況下,能把整套 RAG 助理真正跑起來的關鍵。


 iThome鐵人賽
 看影片追技術